



Pourquoi l'intelligence artificielle connaît - elle une mauvaise information?
Traduit automatiquement
 Auteur
Dans la recherche avec de grands modèles linguistiques (LLM), les réponses offertes dans les flux de travail ou les processus d'apprentissage quotidiens peuvent être vues comme hautement compétentes, fluide et persuasive. Toutefois, lorsque le texte donné est examiné en détail; une étude académique montrée dans la source peut apparaître que la décision du tribunal ou l'événement historique est complètement fictif.
Cette situation apporte une question critique à l'esprit des utilisateurs: L'intelligence artificielle fait-elle des erreurs, est-elle fiable?
Les outils d'intelligence artificielle ne sont pas une combinaison de mécanismes de contrôle de précision ou d'un moteur de recherche classique. Connaissant les principes de travail qui sous-tendent ces systèmes, il est plus facile de répondre à la question de savoir ce qu'est l'hallucination de l'intelligence artificielle et de transmettre les résultats obtenus à partir des bonnes presses.
Qu'est-ce que l'intelligence artificielle?
L'hallucination artificielle de l'intelligence dans la littérature technologique; c'est la condition qu'un modèle d'intelligence artificielle n'existe pas en réalité, logiquement basique ou verbalement incorrecte information est extrêmement confiant, cohérent et couramment réalisé avec une narration.
Contrairement aux folies de la psychologie humaine, le processus ici n'est pas une illusion consciente ou une tromperie intentionnelle. Le modèle rompt complètement avec la réalité casuelle tout en construisant mathématiquement le tableau de mots le plus logique.
Analyse des hallucinations d'intelligence artificielle d'IBM Accueil dans le cadre; ces modèles ne peuvent pas distinguer le mal avec le droit comme dans l'esprit humain. Les systèmes ne calculent les satellites que pour les images des données éducatives (modèles) et comblent les lacunes par la "confabulation" (miroir) lorsqu'ils rencontrent le manque d'information. Par exemple, dans le cas d'un avocat préparé à l'aide de ChatGPT aux États-Unis en 2023, le modèle a été identifié que les idées inexistantes, les numéros de dossiers et les fausses décisions de jugement ne sont pas réalisés. Comme le modèle imite imparfaitement la structure des textes de droit réels, le faux texte apparut à première vue ne fut pas distingué.
Différence entre l'intelligence artificielle et l'erreur ordinaire
Toute réponse incorrecte à l'intelligence artificielle n'est pas évaluée dans la catégorie des hallucinations. Une population ancienne d'un modèle se situe dans le cadre de la « courte erreur » pour donner l'information de la langue dans la traduction ou pour être reflétée dans un calcul technique. Les erreurs ordinaires peuvent principalement être suivies et corrigées au moyen d'une règle de données ou de transactions manquantes dans l'ensemble éducatif.
L'halusination est qu'en dépit du fait qu'il n'y a pas de données réelles sur le sol du modèle et qu'elle le délivre avec un ton de réalité précis. Cela rend la détection des hallucinations beaucoup plus difficile que les erreurs ordinaires.
Pourquoi l'intelligence artificielle connaît - elle une mauvaise information?
Tout d'abord, pour comprendre que l'intelligence artificielle produit de fausses sorties Fondements et processus de développement des technologies de l'intelligence artificielle Tu dois savoir. Lorsque les modèles sont essentiellement compris qu'il existe une architecture de traitement et de calcul des probabilités, la logique des parts d'erreurs est également claire:
1. Prévisions statistiques et Manik possible
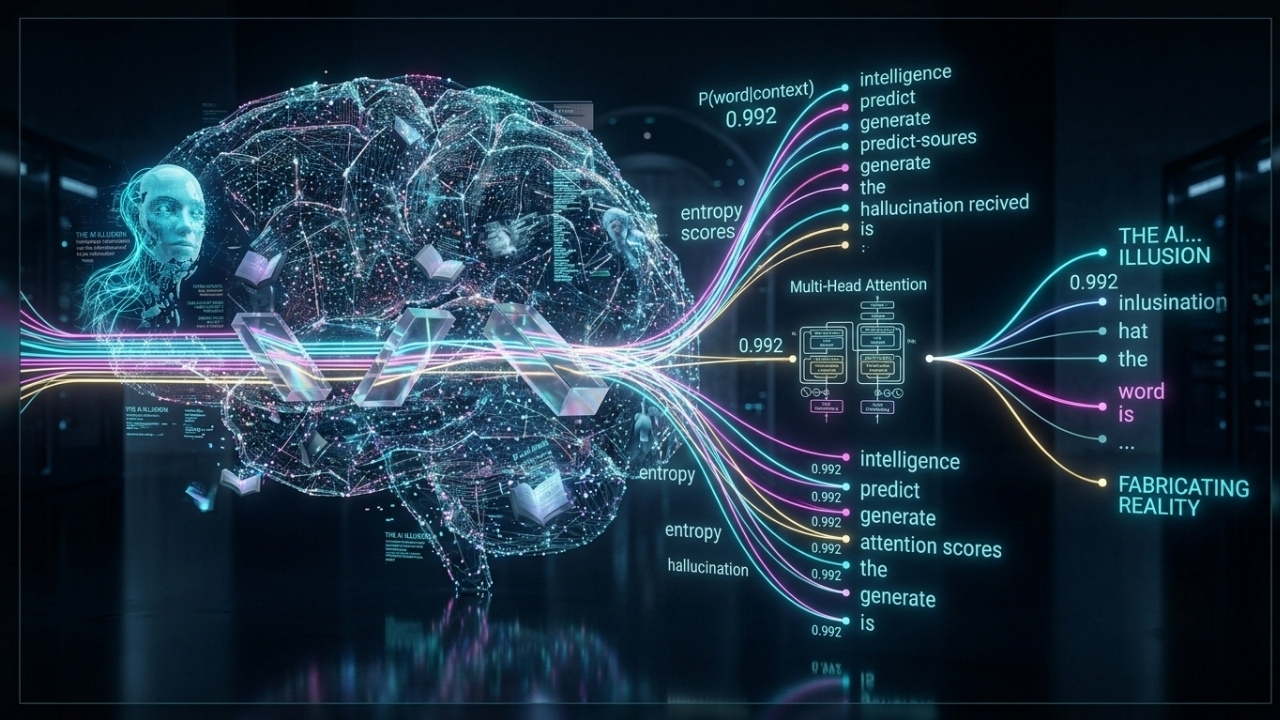
Les grands modèles linguistiques fonctionnent selon le principe de la prédiction du mot suivant (token). Modèle, "C'est le plus susceptible de venir à quel mot en statistique après expression?" se concentre sur la réponse à la question. L'exactitude factuelle de la phrase de priorité pour le modèle n'est pas la structure linguistique et en termes de noyau de signification. Avec l'exécution logique, la probabilité statistique se produit lors du toit.
2. Données de formation parfaites, non stables ou sursatellites
Les modèles sont formés en scannant des ressources ouvertes, des articles et des textes numériques dans l'environnement Internet. Les mauvaises informations contenues dans le pool éducatif sont adoptées comme règles générales par le modèle des préjugés ou des déclarations contradictoires. En outre, lorsque le modèle s'adapte aux données sur l'éducation (suradaptation), il perd la capacité de généraliser et d'établir des connexions incorrectes par des corrélations sans règle.
3. Fournir le dépassement de la conformité aux entrées des utilisateurs
Lors de la production des modèles sont optimisés pour fournir une réponse ininterrompue à la commande user. Au lieu de mentionner que le plus souvent ne sait pas, l'utilisateur répondra en acceptant la précision du problème demandé. Par exemple, lorsqu'une question de base ou de fiction est dirigée, au lieu de rejeter la question de modèle, écrit un scénario fictif qui correspond à l'hypothèse du problème.
4. Sécurité extérieure et manipulations à mauvais usage (injection rapide)
L'intelligence artificielle produit de l'information fausse ou trompeuse n'est pas toujours due au manque d'éducation du modèle. Les manipulations faites de l'extérieur peuvent également déclencher l'hallucination. Grâce à des techniques d'attaque ennemies telles que l'injection rapide, les couches de sécurité du modèle peuvent être manipulées et garantir que le système produit des sorties complètement fictives, guidées ou nuisibles. Comprendre la fragilité et les mécanismes de défense contre de telles interventions des systèmes d'intelligence artificielle Qu'est-ce que la sécurité de l'IA et peut pirater devrait être traitée de manière globale. Les filtres de sécurité disparaissent rapidement la cohérence des informations dans les modèles qui sont supprimés ou manipulés.
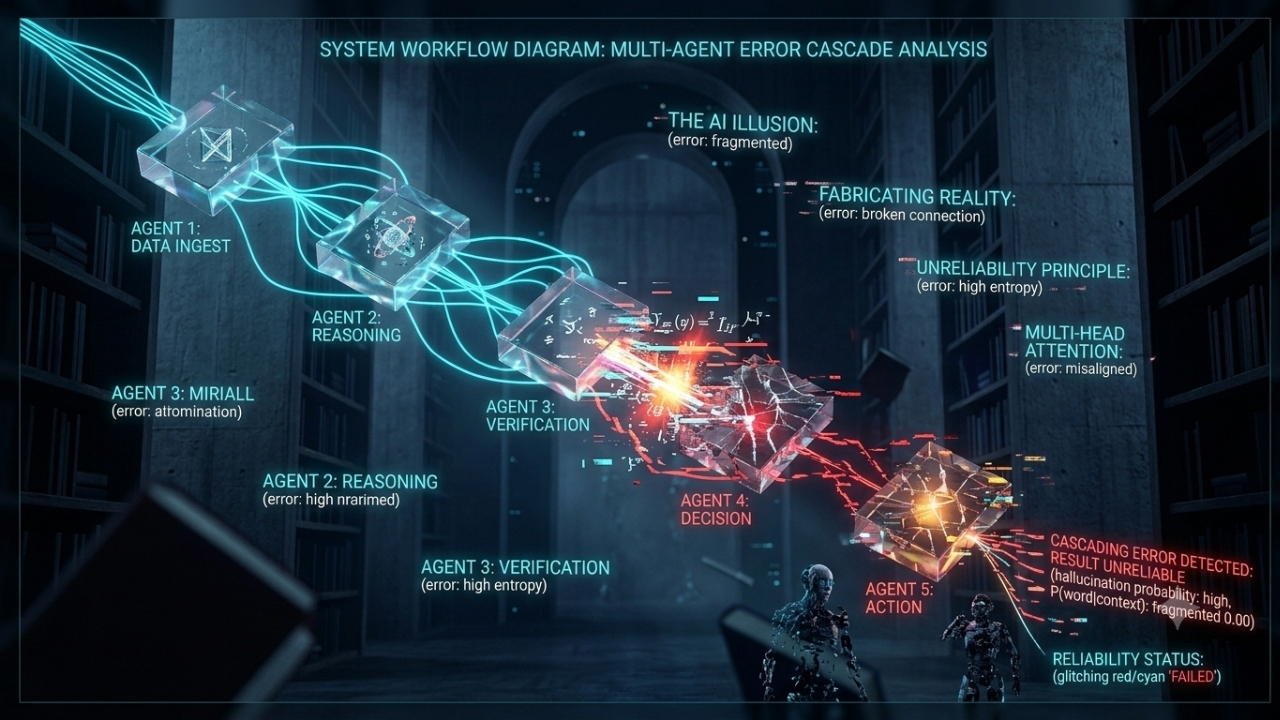
5. Croissance des erreurs dans les systèmes à agents multiples (hallucinations en cascade)
Aujourd'hui, les agents d'intelligence artificielle autonome travaillent ensemble dans les flux de travail enchaînés. Une seule hallucination produite par le premier agent est considérée comme un fait vérifié par les agents suivants et est incluse dans les processus de décision, elle augmente en ajoutant des risques opérationnels et juridiques.
Erreur ChatGPT La vie quotidienne est-elle fiable?
Tous les systèmes d'intelligence artificielle productifs tels que ChatGPT et ainsi de suite peuvent être des erreurs régulièrement.
L'édition de texte est très efficace dans des domaines tels que le développement d'idées, la création de modèles de code, la traduction linguistique et le résumé des concepts de base. Mais il est important de savoir comment les paramètres techniques tels que la température (température) ou la boule p pour améliorer la qualité de sortie du système et contrôler le hasard. Structures de script avancées appliquées pour accroître la cohérence des répondants reçus du modèle et pour contrôler les morts qui tombent à nouveau ChatGPT codes et paramètres cachés Accueil peut être consulté via.
Dans ces domaines nécessitant un mécanisme décisionnel direct, les résultats de l'intelligence artificielle devraient être évalués comme une source finale :
Médecine et santé : le risque de produire de l'information fausse ou spéculative sur la posologie, les symptômes et le diagnostic est élevé.
Droit: Nous pouvons produire des lois non-occlusion ou de fausses idées.
Études académiques : Les soudeurs non existants, les auteurs adaptés et les numéros DOI faux sont les types les plus courants d'hallucination.
Finance : elle peut induire en erreur par le biais de données non confirmées sur le marché et les entreprises.
Méthodes pour réduire le risque d'halusination
Il peut être minimisé avec les bonnes techniques d'utilisation s'il n'est pas possible de réinitialiser complètement la part d'erreur de l'intelligence artificielle. Approches telles que l'identification des rôles, la réflexion étape par étape et la limitation du contexte pour minimiser le risque d'inhalation, techniques d'ingénierie rapides Accueil directement associée à.
Stratégie | Objet | Exemple d'approche de commande |
|---|---|---|
Détermination du rôle et du cadre | La zone de spéculation est étroite. | " Réponse dans le cadre de la législation sur les resmî corrigée. " |
Signaler une instruction inconnue | Empêche le réflexe d'ajustement. | "Si vous n'êtes pas sûr de faire des prédictions, précisez. " |
Examen et contexte du soudage | Efface les limites de la base de données. |
"Adhérer au texte du texte, répondre aux questions. "
Étape de l'exécution mentale
Augmente la cohérence logique.
"Avec les étapes que vous suivez avant d'arriver en ce moment."
Pouvez - vous résoudre le problème de l'halusination?
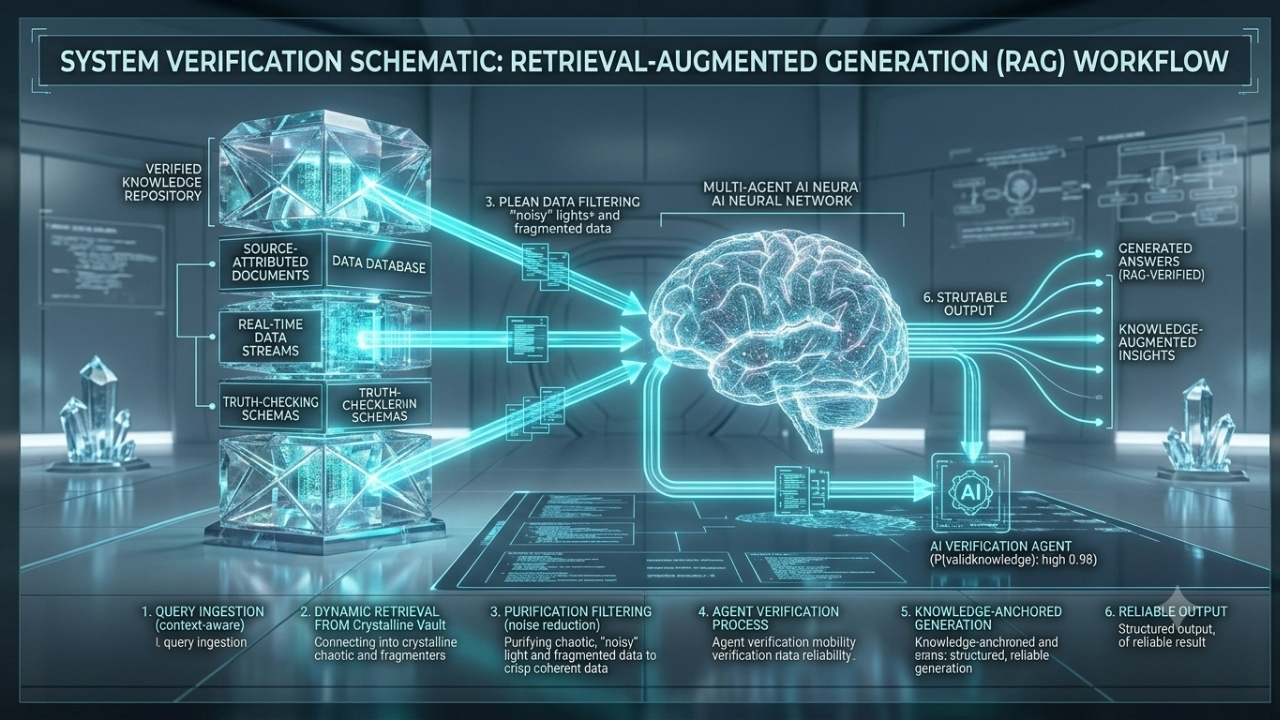
Afin d'améliorer la fiabilité des modèles d'intelligence artificielle et de minimiser le risque d'hallucination, des études intensives de R-D sont menées tant dans le monde universitaire que dans les entreprises technologiques. Aujourd'hui, la solution architecturale la plus courante et fonctionnelle dans ce domaine se distingue par RAG (Retrieval-Augmented Generation / Repurified Production). Le modèle linguistique de la méthode RAG est appliqué à des sources d'information externes fiables, telles que le lien direct entre la taille et les correspondances potentielles dans leur mémoire paramétrique fermée; les bases de données instantanées de l'entreprise, les répertoires Web à jour ou les documents de resmî vérifiés. Après avoir retiré les données brutes pertinentes de ces sources, il configure la réponse en activant sa capacité de synthèse avancée du langage. Ainsi, le réflexe d'espace de remplissage du modèle est largement contrôlé, et l'information est placée sur une base vérifiée.
En plus de l'architecture RAG, la nouvelle génération de techniques éducatives, qui sont transparentes sur les étapes logiques (raisonnantes) des modèles, l'apprentissage de la rétroaction-consolidation (RLHF - Renforcement de l'apprentissage de la rétroaction humaine) et les filtres automatiques de précision que les superviseurs de l'intelligence artificielle sont activés augmentent progressivement leurs taux de précision. De plus, les mécanismes d'autoproduction (auto-correction) qui testent leur logique interne avant de générer la réponse sont intégrés au système.
Malgré tous ces progrès technologiques, les grands modèles linguistiques existants sont essentiellement basés sur la prédiction d'un « amant » sémantique ou d'un « coaching » ; le jeton statistique (kelime/hece) sur d'énormes ensembles de données. Dans ces moteurs possibles qui fonctionnent mathématiquement, aucune erreur ou garantie absolue de précision n'est théoriquement pas possible. Les nouvelles méthodes mises au point ne réinitialisent pas le taux d'hallucination, mais elles peuvent être détectées, limitées et s'introduire dans un partenaire gérable.
Les systèmes d'intelligence artificielle devraient être placés en tant qu'assistants de soutien, non pas en tant qu'autorité absolue de l'information ou que mécanisme correct; accélérer le travail complexe, mais toujours exigé d'être prélevé du filtre humain (humain dans la boucle) et du filtre de pensée critique.
AuteurGemini Ücretli mi? Ücretsiz Sürüm ve Tüm Planlar (2026)
KVKK ve Yapay Zeka: Şirketler Ne Yapmalı?
Articles similaires
Commentaires (0)
Connecte-toi pour commenter.
Se connecter