



Prévisions de l'infrastructure des données : Qu'attendez-vous en 2026?
Traduit automatiquement
 Auteur
L'infrastructure des données est sortie des systèmes de base qui répondent au besoin de stockage et de communication des données en 2026. Ainsi, l'intelligence artificielle est devenue le déterminant fondamental des mécanismes de décision autonomes et des processus d'analyse en temps réel. Aujourd'hui, comme les données ont été faites, elles sont venues directement à la situation pertinente avec la façon dont les données sont modélisées et comment elles sont comprises. Cette conversion; entrepôts de données traditionnels, gazoducs ETL solides et questionner directement la séparation analytique-opérationnelle. Selon les prévisions de 2026, des architectures plus ouvertes, plus modulaires et compatibles avec l'IA dans l'infrastructure de données se démarqueront.
La fin des systèmes d'analyse et d'exploitation vient-elle?
Le concept d'architecture de données classique a été construit sur deux mondes distincts pendant des années. Ils effectuent des opérations quotidiennes Systèmes opérationnels (OLTP) avec rapports et appui à la décision Systèmes d'analyse (OLAP) C'est triable. Cette approche était inévitable pour les retards et les couches d'intégration complexes dans la réplication des données. Mais avec les produits numériques modernes, il a été approché à la fin de cette séparation.
Pourquoi cette discrétion signifie - t - elle?
- Rapports en temps réel et prévisions du tableau de bord
- Les modèles AI ont besoin de données de production en direct
- Streaming et architecte animé d'événementscommunisation des
- Questions sans copie des données (analyse à zéro) approches
Dans la vision de l'infrastructure de données 2026, les données sont maintenant utilisées pour des usages multiples via une seule source fiable sans être étiquetées comme "opérationnel" ou "analytique". Cela rend les formats de données stratégiques pour connecter les couches et les moteurs de requête.
Apache Arrow et ADBC: Nouvelles normes de connexion de données
La colonne vertébrale de l'architecture moderne des données Flèche Apache 2026 prévisions relatives aux infrastructures de donnéesen est la base. Arrow élimine les coûts de conversion entre différents systèmes, ce qui permet de représenter les données sous une forme standard en mémoire.
Pourquoi Apache Arrow est-il important?
- Haute performance analytique grâce à la mise en page de la mémoire en colonne
- Python, Java, C++, Rust
- Partage sans copie des données (copie zéro)
- Structure adaptée aux processus CPU, GPU et vectorisés
- Voir l'écosystème des données comme un langage commun
Que change ADBC avec la connectivité de la base de données Arrow?
ABCest une alternative moderne à l'ODBC et JDBC. Avec cette norme de connexion basée sur Arrow, les données ne passent pas à la pratique, les données d'approche d'application; l'intégration entre moteurs d'analyse est simplifiée et surtout, les obstacles entre la science des données et les systèmes de production sont éliminés.
Open Table Formats: Apache Iceberg Pourquoi 2026 Gagnante?
Iceberg Apache Non seulement les équipes techniques aujourd'hui; CTO et les gestionnaires de données sont également un sujet à l'ordre du jour. Iceberg se distingue par un format de table ouvert qui combine la flexibilité du lac de données (laque de données) et les disciplines de l'entrepôt de données.
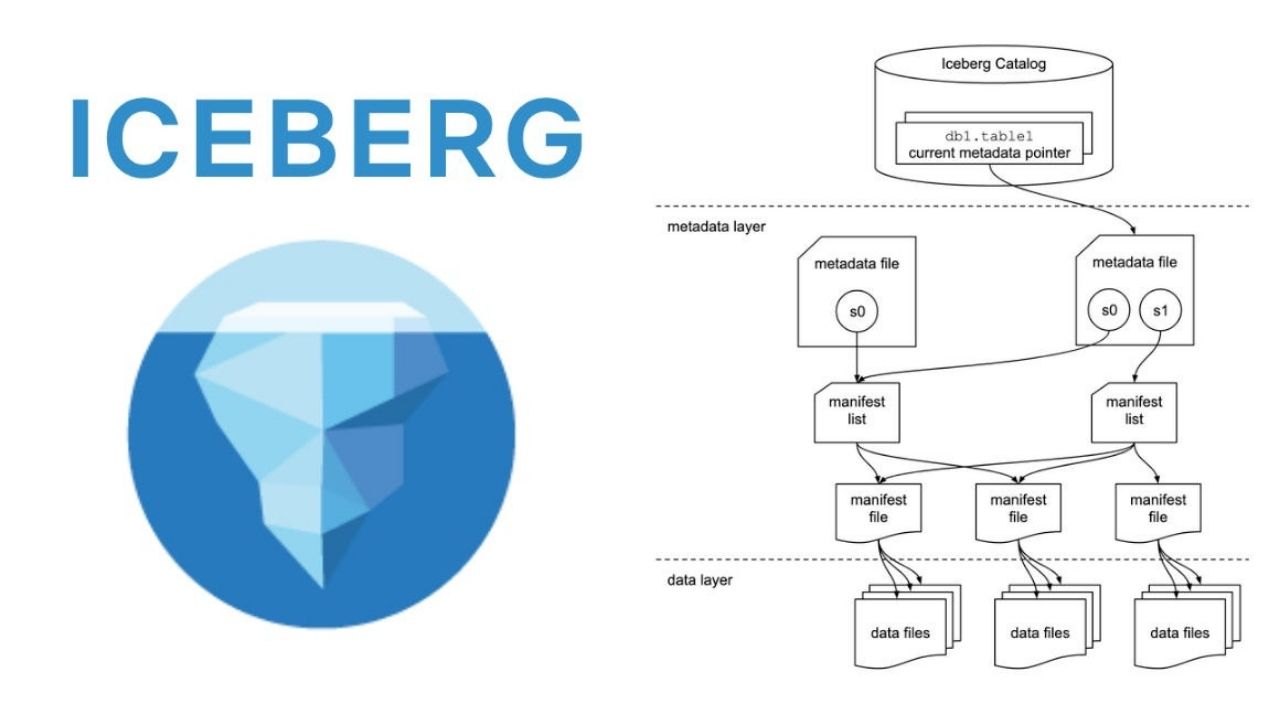
Compétences de base révélées Iceberg
- Opérations de table compatibles ACID Accueil
- Snapshot et support de voyage dans le temps
- Evolution et compatibilité rétrospective
- Faire le niveau de fichier mais dans le comportement de la table
- Faire de la gestion et des tables fiables dans les formats de fichiers comme Parquet
Le concessionnaire est évolutif sans addiction; support multimoteurs comme Spark, Trino, Flink, DuckDB; rassemblant l'analyse en temps réel et par lots au même étage, en 2026, Iceberg est maintenant classé parmi les formats de table ouverts.
DuckDB et DataFusion : fin des entrepôts de données monolytiques
Les entrepôts de données traditionnels étaient des systèmes coûteux et souvent flexibles. Pourtant, de nouvelles tendances dans l'entrepôt de données révèlent l'importance des solutions à échelle en fonction des besoins.
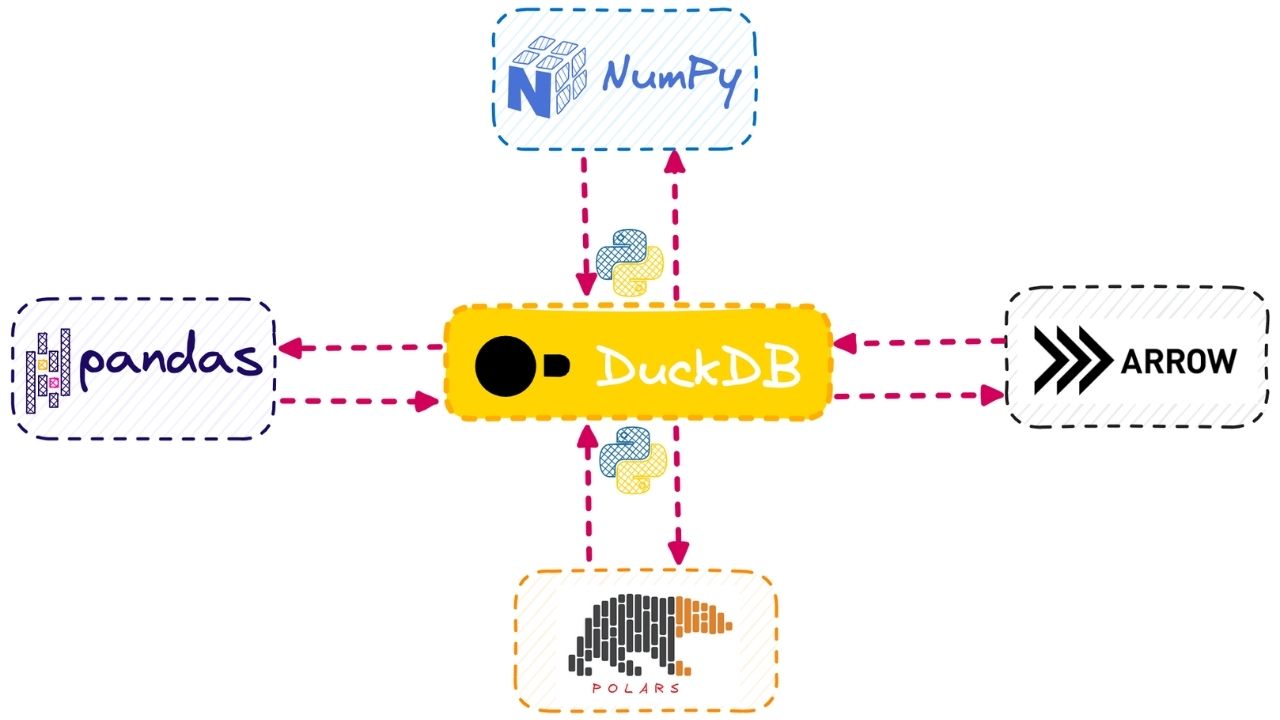
SommaireLes requêtes analytiques sont un moteur de requête serveur qui peut fonctionner directement sur les fichiers:
- Travaux sans installation.
- Demandes directes des tables Parquet et Iceberg.
- Python est compatible avec les outils R et data science.
- Fournit une analyse évolutive à la petite magie.
- Il fait de l'entrepôt de données une composante non-service.
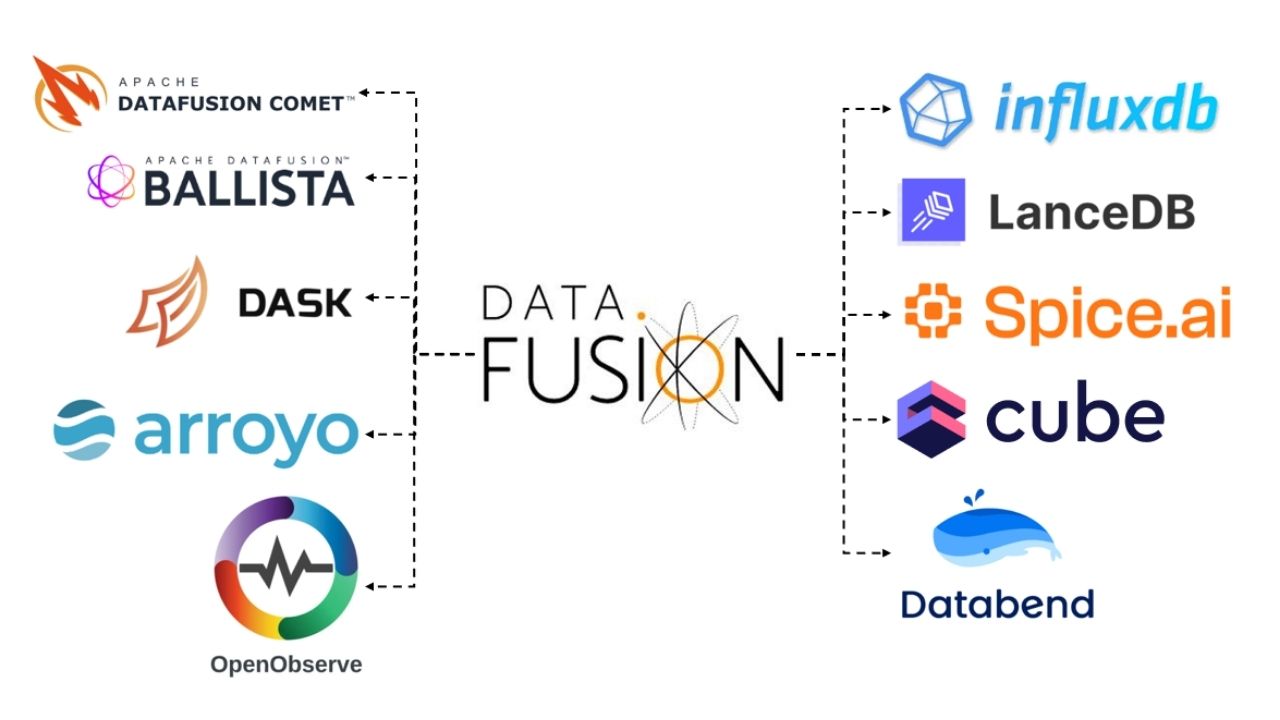
Apache DataFusion est un moteur de requête haute performance construit sur l'écosystème Arrow :
- Rust est basé et fournit la sécurité de la mémoire
- Peut fonctionner dans des architectures intégrées ou distribuées
- Compatible avec les charges de travail de Streaming et d'IA
DuckDB et DonnéesFusion En considérant l'emplacement des entrepôts de données monolithiques analyse composite l'approche est vue.
Pourquoi la pensée critique des données de table pour les agents d'IA?
Les systèmes d'intelligence artificielle en 2026 ne produiront pas seulement du texte; ils interagiront avec les données, la prise de décisions et le domaine d'action Agents de l'IA sera à l'avant-garde. Le succès de ces agents sera directement associé à la qualité de l'infrastructure de données. L'architecture de données d'intelligence artificielle est installée sur les tables Iceberg et les formats de mémoire Arrow. L'ingénierie rapide future ne jouera pas un rôle décisif dans l'ingénierie des données. Les normes ouvertes continueront d'être la condition préalable de l'évolutivité de l'IA. En 2026, l'infrastructure de données est fermée et non monolithique, ouverte et modulaire, basée sur la table, mais laque-native, l'intelligence artificielle et l'analyse en même temps devrait être mariée.
| 2026 Tendances des données | Point d'intérêt principal | Effet attendu |
| Iceberg Apache | Ouvrir les formats de table | Normalisation et succès de la production |
| Stack multimoteur | Stockage et séparation de calcul | Économie et flexibilité |
| Intégration des agents d'IA u | Données configurées (tabulaires) | Accueil Accès rapide et sécurisé aux données |
| Normes ADBC | Couche de connexion des données | Changement de l'ancien système ODBC/JDBC |
AuteurApple Creator Studio: Tek Platformda Yaratıcılık Ekosistemi
Yazılım Mühendisliğinde 2026 AI Trendleri
Articles similaires
Commentaires (0)
Connecte-toi pour commenter.
Se connecter