




Qu'est-ce que Generative AI? Principe de travail et types de modèles
Traduit automatiquement
 Creator
IA génériqueC'est une sorte d'intelligence artificielle qui produit un nouveau contenu (texte, visuel, audio, vidéo ou code) qui ressemble à des moules qui apprennent de grands ensembles de données. L'intelligence artificielle classique classe ou prédit souvent une valeur; l'intelligence artificielle productive crée une nouvelle sortie. Aujourd'hui, les types les plus utilisés sont les grands modèles de langage (LLM), les modèles de diffusion, les GAN et les VAE.
Dernière mise à jour: 18.10.2026
Courte date: ELIZA a été publié en 1966 à partir des premiers programmes de chat, mais il travaillait avec des règles prêtes; ce n'était pas un modèle productif aujourd'hui. Asıl bond VAE (2013), GAN (2014), est venu avec l'architecture des transformateurs (2017) et des modèles de diffusion. L'idée de diffusion a été recommandée en 2015, généralisée avec les travaux du DDPM en 2020. Cette technologie est utilisée dans de nombreuses œuvres de dublajdan contenu éducatif; les risques tels que le faucon profond, le droit d'auteur, le biais et l'ajustement de modèle (halüsination) sont toujours à l'ordre du jour.
Alors, qu'est-ce que c'est que cette AI Generative ? Comment ça marche et quels sont les modèles ? Ici, détails:
Qu'est-ce que Generative AI?
L'Intelligence Artificielle Generative est un domaine d'IA qui se concentre sur la création d'algorithmes et de modèles qui peuvent produire des données nouvelles et réalistes qui ressemblent aux modèles de l'ensemble de données éducatives. Simplement explicite, l'IA générative se réfère à une classe de systèmes d'IA qui produisent des données entièrement nouvelles. Ces systèmes ou modèles sont formés pour apprendre à partir de grands ensembles de données et créer quelque chose de complètement nouveau basé sur cette information. Ainsi, le terme «generative» (produit) est utilisé.
L'IA générative a de nombreuses applications dans l'art, la synthèse d'images, la production de langage naturel, la composition musicale, le codage et bien d'autres domaines. La plupart des types traditionnels d'intelligence artificielle sont conçus pour classer les données existantes ou catégoriser, le but des modèles générateurs d'IA est de produire des œuvres entièrement originales qui n'ont jamais été vues auparavant.
L'IA discriminatoire (intelligence artificielle permanente) et les différences génétiques de l'IA
Comprendre les différences entre l'intelligence artificielle discriminatoire (intelligence artificielle permanente) et l'intelligence artificielle génétique (intelligence artificielle du fabricant) nous aide à mieux saisir les différentes applications de l'intelligence artificielle.
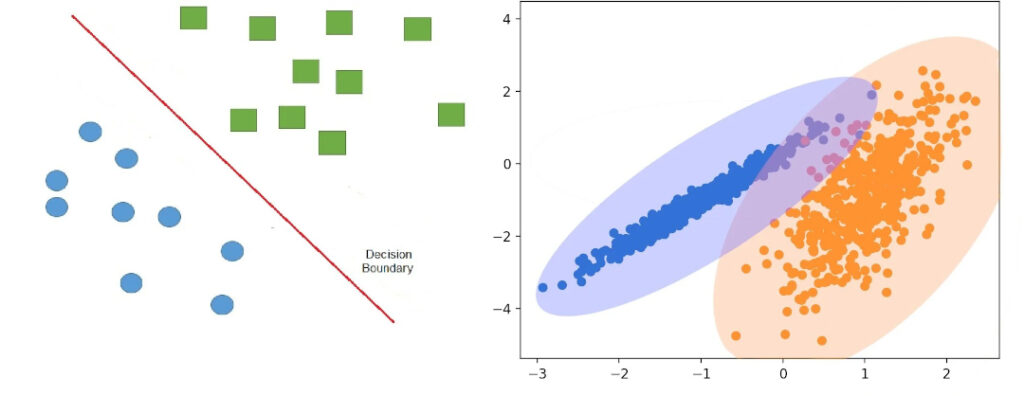
AI discriminatoire modèleIls sont formés à reconnaître les modèles dans les ensembles de données et à prévoir ou à classer de nouveaux exemples en utilisant ces modèles. Par exemple, un modèle AI discriminateur formé sur un ensemble de données contenant des images de chat ou de chien peut classer de nouvelles images comme chat ou chien en fonction des modèles qu'ils apprennent à partir des données d'entrée. Ces modèles sont souvent formés à l'aide de techniques d'apprentissage de la surveillance et sont très efficaces pour des tâches spécifiques. Ils sont principalement utilisés pour résoudre des problèmes spécifiques tels que la classification ou la prédiction.
IA générique S'il est conçu pour apprendre les schémas sous-jacents dans les ensembles de données et produire ces informations similaires à l'ensemble de données original, mais pas entièrement les mêmes nouveaux exemples. Par exemple, un fabricant formé sur les photos de chat algorithme AI peut produire de nouvelles photos de chat, qui ressemble à l'ensemble de données original mais sans copies complètes. Lorsqu'on produit des modèles, on apprend en grande partie à partir de données non marquées, des méthodes autocontrôlées (auto-supervisées) ; par exemple, un modèle linguistique est formé en prédisant la pièce suivante du texte. Les assistants de clavardage prennent une bonne adaptation avec la rétroaction humaine à ce sujet. Cela rend le fabricant AI particulièrement utile dans les applications où les données configurées ou réglementées sont difficiles à effrayer ou à obtenir.
Algorithmes d'apprentissage des machines de surveillanceutilisé lorsque les données sur l'étiquette ne sont pas disponibles. Au lieu de cela, l'algorithme est donné avec un certain nombre de séries de données non structurées. L'algorithme examine les données non structurées et essaie d'identifier les modèles et les structures de façon indépendante sans instructions ni connaissances préalables. Le regroupement et la détection des anomalies sont des exemples de techniques d'apprentissage non supervisées.
Algorithmes d'apprentissage automatique semi-évaluésLorsqu'il y a des données marquées disponibles pour la formation, mais il est utilisé quand il ne suffit pas de former un modèle complet. L'algorithme définit les modèles et les structures dans les données, en utilisant des données marquées avec des données non marquées. La moitié de l'apprentissage en surveillance peut être considérée comme une approche hybride entre la surveillance et les techniques d'apprentissage non supervisées.
En général, l'IA immissive développe la capacité de produire une compréhension plus large et de nouveaux échantillons de données tout en apprenant à résoudre un problème spécifique. Comprendre ces deux types d'IA nous aide à déterminer quelles situations et comment elles peuvent être utilisées efficacement.
Différence fondamentale entre l'intelligence artificielle et l'intelligence artificielle classique
La différence de base est : le modèle classique (secteur) vous donne une étiquette, un score ou une prédiction ; le modèle productif produit un nouveau contenu. Le tableau ci-dessous résume la différence.
Fonctionnalité | Intelligence artificielle classique (aussi) | Intelligence artificielle (IA génétique) |
|---|---|---|
Qu'est-ce que c'est ? | Il classe les données, les scores, les estimations | Produit un nouveau contenu qui ressemble aux données |
Produit | Étiquette, probabilité, nombre (p. ex. «spam» ou «spam») | Texte, visuel, audio, vidéo, code |
Exemples de tâches | Filtre pour pour pourriel, cote de risque de crédit, proposition de produit, prévision de défaut Accueil | Chat, écriture de texte, génération visuelle et vidéo, écriture de code |
Systèmes d'échantillonnage | Filtres e-mail, moteurs de recommandation, classificateurs | ChatGPT, Gemini, Claude, Midjourney, Stable Diffusion |
Bref, lorsque vous dites « intelligence non humaine générative d'IA », vous pouvez penser que les systèmes qui décident ou prédisent mais ne produisent pas de nouveaux contenus.
Principe de travail général de l'IA
L'IA générative peut être considérée comme une version de l'IA qui imite les processus créatifs du cerveau humain. Dans ce domaine, en utilisant diverses techniques, comme les réseaux nerveux et les algorithmes d'apprentissage profond, il est possible d'identifier certains modèles et de produire de nouveaux résultats basés sur eux.
Le processus de formation de l'IA Generative commence généralement par un grand ensemble de données. Ce jeu de données peut contenir des exemples tels que des images, du texte, de l'audio ou des vidéos. Le modèle tente de comprendre les règles de base que le contenu est géré par l'analyse des modèles et des relations dans les données d'entrée. Ensuite, nous produisons de nouvelles données en tirant des exemples de la distribution des possibilités que vous apprenez. Il essaie constamment de maximiser le potentiel de produire la sortie correcte en ajustant ses paramètres.
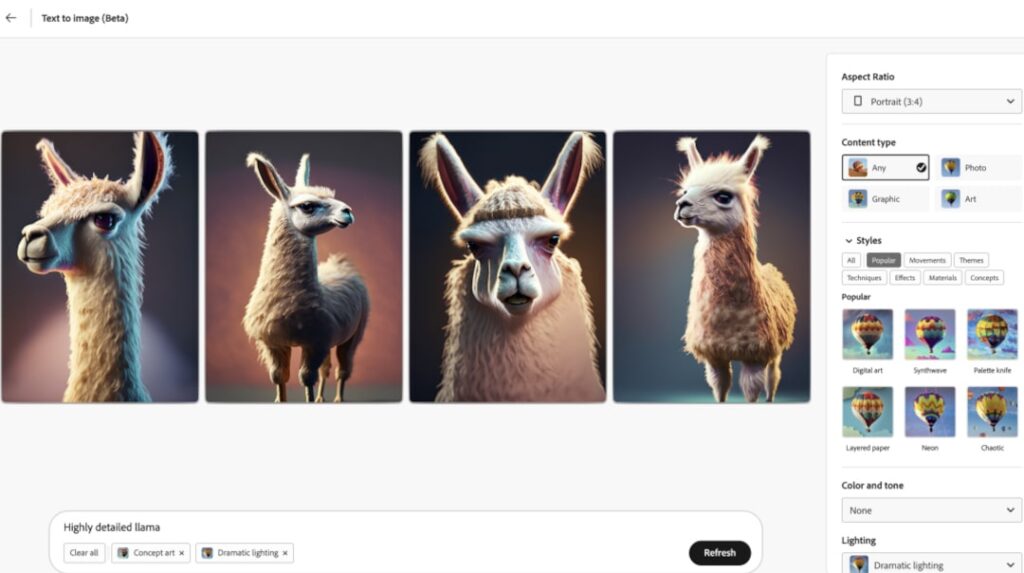
Par exemple, un modèle génératif formé sur un ensemble de données composé d'images lama peut créer de nouvelles images lama en mettant en évidence des exemples de la distribution apprise, puis en perfectionnant la sortie par un processus appelé « papier ». Lors de la suppression, ajuste mieux la sortie du modèle à la sortie souhaitée ou pour corriger toute erreur. Cela garantit que la sortie générée est plus réaliste et mieux adaptée à ce que l'utilisateur veut voir.
L'IA générative a le potentiel de révolutionner la production de contenu créatif. Utilisant l'art, la musique, la littérature et même les découvertes scientifiques, il peut ouvrir la porte à des innovations irréalisables avant. Le travail effectué dans ce domaine permet à l'IA de se transformer en une technologie qui ne peut être qu'un outil analytique, imiter la créativité humaine, voire soutenir.
Quels sont les modèles d'IA génériques?
Les modèles d'IA ne sont pas les seuls. Aujourd'hui, ce type d'intelligence artificielle a été lancé comme différents modèles par différentes sociétés d'intelligence artificielle. Voici le plus connu de ce type:
Type de modèle | Comment ça marche ? | Fort | Exemples connus |
|---|---|---|---|
GAN (2014) | Le séparateur avec le générateur est formé l'un contre l'autre | Production visuelle rapide et nette en une seule étape Accueil | StyleGAN, CycleGAN |
AaUppercase | Compresse les données de l'espace caché, se régénère de là | Variation contrôlée, compression | Encodeur-rupteur d'image sur Stable Diffusion |
Fusion (2015, 2020) | Il crée des visuels en nettoyant le bruit étape par étape | Haute qualité visuelle, guide texte | DALL·E 2, Stable Diffusion |
LLM basé sur les transformateurs (2017) | Il produit du texte en prédisant la pièce suivante (token) | Texte, code, chat, utilisation multilingue m | GPT, Gemini, Llama |
Données de débit (Glow, 2018) | Il utilise des conversions inversées | Calcul complet du potentiel | Glow; Stable Diffusion 3 avec réglage du débit |
Réseaux d'adversaires mondiaux
Les réseaux d'adversaires (GAN) sont un modèle d'intelligence artificielle composé de deux réseaux nerveux : un générateur et un séparateur. Par exemple, lorsque l'on vous demande de créer des photos de chat, le générateur produit une nouvelle image de chat en utilisant un vecteur d'entrée aléatoire.
Ces images peuvent être simples au départ, mais elles deviennent réalistes au fil du temps. Le séparateur fonctionne pour classifier réel ou faux en prenant à la fois de vraies photos de chat et de fausses photos produites.
Les deux réseaux se développent en continu en se faisant concurrence : mieux classer le séparateur, le générateur apprend à créer des images plus inconductrices. Cette structure concurrentielle a provoqué l'utilisation de l'expression "adversaire" appelée le modèle.
Processus de formation des GAN
Le processus de formation des GAN (Generative Adversarial Networks-producted Traction Networks) est une approche assez intéressante et innovante. Ce processus comprend les étapes suivantes:
Démarrer les étiquettes: Générateur (générateur) et distinctif (discriminateur) sont lancés avec des poids aléatoires. L'idée principale ici est que deux réseaux se concurrencent.
Cycle de formation: Le générateur est formé à la combinaison de données réelles et fausses distinctives lors de la création de communautés de données fausses. Le berceau donne un score possible entre 0 et 1, indiquant si les données d'entrée sont réelles ou fausses.
Étendue arrière (Sommaire): Le signal d'erreur de l'obturateur s'étend pour mettre à jour le poids du réseau. Ensuite, le générateur est également entraîné à l'aide du signal de défaut de la distinction et mis à jour son poids.
Échantillonnage: Après la formation du modèle, le générateur peut produire de nouveaux échantillons de données provenant de la distribution apprise.
Les GAN ont été utilisés pour diverses applications telles que la production d'images, de vidéos et de conversations réalistes. L'un des avantages de GAN est qu'ils peuvent produire des exemples de haute qualité et divers grâce à leur capacité à apprendre des distributions complexes et multimodes.
Cependant, l'entraînement des GAN peut être difficile et ils peuvent souffrir de problèmes tels que l'effondrement du mode (écrasement du mode), ici le générateur produit des exemples limités et répétitifs. Diverses modifications et améliorations ont été recommandées pour résoudre ces problèmes, comme les GAN de Wasserstein et les GAN de Style.
Domaines d'application du GAN
GAN-S (Generative Adversarial Networks) est une technologie d'intelligence artificielle composée de deux réseaux, permettant des applications innovantes dans différents domaines. Celles-ci :
Production et manipulation d'images et de vidéos : affichages et faux profonds (faux profonds).
Transfert de style et vidéo de la traduction d'image: Convertir des images en appliquant différents styles.
Récupération de données et synthèse: Utilisé pour améliorer les performances des modèles d'apprentissage contrôlés.
Synthèse et sous-titre Image de Texte : Visualisez le texte écrit ou ajoutez des sous-titres aux images.
Production et conception d'objets 3D : Création d'avatars réalistes et d'environnements virtuels.
Transformation sonore et synthèse sonore : production sonore et musicale.
Développement et conception de jeux : Créez de nouveaux niveaux et personnages.
Applications créatives: Art, musique, production littéraire.
Sécurité et confidentialité: Fausse génération de données et détection de contrefaçon profonde.
Recherche scientifique et simulation : simuler des systèmes complexes et faire des prédictions scientifiques.
CycleGAN est un exemple GAN utilisé pour la traduction d'image en image et peut convertir des images sans données d'entraînement inégalées. L'efficacité du GAN dépend de la qualité des données éducatives, de la complexité de la distribution sous-jacente et de facteurs tels que l'architecture du modèle.
Encodeurs automatiques variables
Les encodeurs automatiques variables sont des modèles régénératifs utilisés dans le domaine de l'intelligence artificielle. Ces modèles peuvent produire de nouveaux extrants qui sont semblables à des ensembles de données, en particulier ils sont efficaces pour explorer les variations correctes de certaines directions dans les données. Les EAV travaillent à travers deux réseaux de nerfs, qui comprennent un encodeur et un solvant pour prendre une image.
Le codeur convertit l'image en une représentation de petite taille appelée « espace secret » et produit une nouvelle image semblable à l'original en utilisant cette représentation du solvant. La particularité de VAE est qu'elle utilise des modèles exceptionnels pour apprendre la distribution sous-jacente aux données éducatives. Ils peuvent ainsi mieux saisir l'incertitude et les variables dans les données. Les EAE offrent un grand potentiel d'applications novatrices dans des domaines comme les arts visuels et la simulation de données.
Processus de formation des EAV
Variable Automatic Encoders (VAEs) est une méthode largement utilisée dans l'apprentissage automatique et est particulièrement efficace dans des applications telles que la production de données, la compression, l'élimination du bruit et l'extraction de propriétés. Le processus de formation des EAE comprend les étapes suivantes:
Codage (encodage) : les données d'entrée sont transmises au réseau d'encodeur (encodeur). Ce réseau compresse les données dans un espace "latent" de taille inférieure. Cet espace caché est basé sur l'hypothèse de distribution gaussienne.
Échantillonnage (échantillonnage) : Une tache aléatoire dans l'espace caché de la distribution gaussienne apprise.
Résoudre le code (décodant): Le réseau de solvants de code (décoder), prend le point échantillonné et le convertit en un nouveau point de données. Code solvant est formé pour reconfigurer les données d'entrée d'origine en utilisant la représentation d'espace caché.
Calculatrice perdue (calcul des pertes) : La fonction de perte pour les EAE consiste en une perte de restructuration et une perte de diversification de KL (écart tête-lecteur). La perte de restructuration mesure dans quelle mesure le solvant code peut restructurer les données d'entrée originales. D'autre part, la perte de diversité KL mesure la différence entre la distribution de l'espace secret appris.
Épandage du dos (Propagation du dos) : Le signal d'erreur de la fonction perdue, se répartit à travers le réseau pour mettre à jour les poids de l'encodeur et du décodeur.
Une fois la formation terminée, VAE peut produire de nouvelles données par échantillonnage à partir de la distribution de l'espace secret appris. Les EAV peuvent également être utilisées dans d'autres applications telles que la compression des données, l'élimination du bruit et l'enlèvement des propriétés. Par exemple, l'application de suppression de bruit d'image peut être faite avec des encodeurs automatiques.
Domaines d'application de VAE
Variable Automatic Encoders (VAEs) est une technologie basée sur les réseaux nerveux artificiels qui a une place importante dans le domaine de l'intelligence artificielle et de l'apprentissage machine. Cette technologie est utilisée dans de nombreux domaines, notamment comme production et manipulation de données. Voici quelques-uns des domaines d'application des EAV:
Production et manipulation d'images : les EAV peuvent produire des images nouvelles et réalistes ou modifier des images existantes. Cela offre une nouvelle créativité dans le domaine de l'art et du design.
Production et prévisions vidéo : les EAV peuvent être utilisées pour créer des contenus vidéo et prévoir des carrés futurs.
Compression des données et suppression du bruit: les EAV sont très efficaces pour réduire les données de compression et de bruit, ce qui nécessite moins d'espace de stockage et augmente la qualité des données.
Détecteur d'anomalies et valeur d'excavation : Les EAV peuvent être utilisées pour détecter des éléments anormaux ou illégaux dans les ensembles de données et les enlever.
Systèmes de recommandation et personnalisation : utilise les EAV pour fournir un contenu personnalisé et des recommandations de produits selon les préférences personnelles.
Extraction de fonctions et représentation : Les EAE sont utilisées pour apprendre des représentations plus significatives et utiles des données.
Production de modèles et d'environnements 3D réalistes : les EAV peuvent être utilisés pour créer des modèles 3D et des environnements virtuels qui ressemblent au monde réel.
Traitement des langues naturelles : Les EAE jouent un rôle important dans le traitement des langues naturelles, y compris la production de texte et la traduction automatique.
Analyse des données biomédicales et découverte de médicaments : Les EAV sont utilisées dans l'analyse des données biomédicales et la découverte de nouveaux candidats pharmaceutiques.
Simulation et prévision en physique et autres sciences : Les EAV sont utilisées pour la simulation et la prévision dans diverses branches scientifiques.
Modèles de diffusion
Les modèles de diffusion nous viennent comme une étape innovante dans le domaine de l'intelligence artificielle. Ces modèles ajoutent du bruit aux données de base pour produire des données synthétiques de haute qualité et apprendre en éliminant ce bruit. Grâce au processus d'extraction du bruit, les modèles de diffusion permettent de mieux comprendre les modèles et les structures de données.
Ces modèles réussissent particulièrement à créer des images. Le modèle de la formation apprend à prédire le bruit ajouté aux données, cet objectif simple rend la formation plus stable que deux concours de réseau dans GAN. Bedeli est plus lent à fonctionner en raison de la production est très avancée. Le modèle DALL·E 2 de OpenAI (2022) et Stable Diffusion (diffusion latente) qui fonctionne dans un espace caché comprimé avant l'image est un exemple de modèles de diffusion qui produisent un visuel à partir du texte. Le premier DALL·E (2021) n'était pas une diffusion, mais un modèle de transformateur autorégressif.
Autres modèles d'IA génériques
Nous avons vu des AI Generative principalement divisés en 3 modèles différents. Mais des modèles d'IA plus innovants et expérimentaux sont également disponibles. Ces modèles sont énumérés en détail ci-dessous.
Modèles autorégrésifs
Les modèles autorégrésifs sont les possibilités des modèles prédictifs basés sur les éléments précédents, chaque élément en produisant un tableau de données à son tour. Dans le domaine du traitement des langues naturelles, elles sont souvent utilisées dans des tâches telles que la production de texte et la traduction linguistique. Ces modèles prédisent la valeur suivante en examinant les valeurs antérieures en un certain nombre. Par exemple, on peut prévoir le prix du lendemain en fonction des prix des jours précédents dans l'analyse chronologique des prix des actions.
Les grands modèles de langage (LLM), utilisant de tels modèles autoregrésifs, produisent des réponses humaines aux commandes. Ils sont formés à de grands ensembles de données textuelles, comme des livres, des articles et des sites Web, et ils sont conçus pour produire de nouveaux textes dans le style et le contenu similaires aux données réelles. Les LLM ont obtenu des résultats positifs dans de nombreux langages tels que la modélisation linguistique, la traduction automatique, la prise de questions et l'abstraction de texte.
Elle est également importante dans les œuvres créatives telles que les capacités de production de texte de haute qualité, les assistants de chat, la dactylographie, l'abstraction et les messages de médias sociaux. Comment former les LLM Accueil Qu'est-ce que le modèle de grande langue (LLM), comment être éduqué? Dans notre article, nous avons expliqué en détail.
Modèles fondés sur les transformateurs
L'architecture Transformer a été introduite en 2017 avec l'article "Attention est tout ce dont vous avez besoin" des chercheurs Google; aujourd'hui, de grands modèles de langage tels que GPT, Gemini et Llama sont installés sur cette architecture. Transformer est une sorte d'architecture de réseau nerveux basée sur son propre mécanisme d'attention. Lorsqu'une entrée est donnée, le mécanisme permet au modèle d'attribuer des poids en parallèle à différentes parties du tableau d'entrée.
Ensuite, le modèle détermine la relation entre ces sections et produit la sortie correspondante à l'entrée spéciale. Les transformateurs sont couramment utilisés pour des tâches NLP telles que la traduction linguistique, la production et la prise de questions. Toutefois, à moins qu'ils ne soient spécialement formés à créer de nouveaux contenus, ils ne peuvent pas seulement être considérés comme des modèles générateurs.
Modèles basés sur le flux
Les modèles basés sur les flux sont une sorte de modèles générateurs d'IA et se concentrent sur l'apprentissage de l'organisation des données dans un ensemble de données. Ces modèles fonctionnent en comprenant les possibilités de valeurs/événements dans l'ensemble de données et en identifiant ce qui se produit souvent. Lors de la production de nouveaux points de données, ils protègent les propriétés statistiques et les caractéristiques des données existantes. La caractéristique de ces modèles est qu'ils appliquent les données existantes peuvent être facilement inversés ou inversés par une conversion d'inversion simple.
Comme la conversion est inversée, ces modèles peuvent calculer pleinement la possibilité d'une donnée et produire l'échantillon à partir d'une distribution de départ simple (par exemple, le bruit aléatoire). Glow publié en 2018 est l'exemple connu de cette approche. Le désavantage est la retenue de l'architecture de l'exigence de chaque couche à inverser.
L'idée d'écoulement est aujourd'hui de différentes façons : Stable Diffusion 3 a été introduit en 2024 comme modèle de transformateur entraîné par la méthode de couplage d'écoulement appelée « flux rectifié ». Ainsi, les approches de diffusion et de flux dans les modèles visuels à jour sont importées. Pour plus de détails Stable Diffusion 3 Voir notre article.
Si vous voulez essayer des outils d'intelligence artificielle tout en produisant Guide de construction visuelle d'intelligence artificielle avec MidjourneyÉtiquettes Comment utiliser DALL·E 2 Outil de création d'images d'intelligence artificielle ? et Création visuelle et vidéo avec intelligence artificielle Vous pouvez consulter nos articles. Définition générale de l'intelligence artificielle Qu'est-ce que l'intelligence artificielle? Notre article est un bon début.
Foire aux questions
Que signifie l'IA Generative?
L'IA générative signifie "intelligence naturelle" en anglais. Il parle de nouveaux systèmes d'intelligence artificielle qui ressemblent à des données qu'ils apprennent.
Quelle est la principale différence entre l'intelligence artificielle classique et l'IA Generative ?
Classique classifie ou prédit les données qui ont l'intelligence artificielle; l'IA générative produit un nouveau contenu. Par exemple, les balises de filtre de spam "spam", un modèle de langue, vous écrit un nouveau courriel.
Quels sont les exemples d'intelligence artificielle sans AI Generative?
Les systèmes tels que les filtres pour pourriels, la cote de risque de crédit, les systèmes de recommandation de produit, la prédiction des défauts et la détection d'objets en image sont des exemples d'intelligence artificielle non professionnelle. Ceux-ci décident ou prédisent, ne produisent pas de nouveau contenu.
Qu'est-ce que GAN (Generative Adversarial Networks) ?
GAN est un modèle productif, introduit en 2014, et formé contre deux réseaux nerveux. Le générateur produit de faux exemples, le séparateur essaie de les séparer de leurs vérités, rendant cette compétition plus réaliste.
ChatGPT est une AI génératrice ?
Oui. ChatGPT est une application d'intelligence artificielle productive qui fonctionne avec de grands modèles de langage basés sur l'architecture du transformateur; il produit un nouveau texte en prédisant les prochaines parties de mots selon la commande que vous donnez.
CreatorMeta’nın Çığır Açan Yeni AI Uygulaması: Duygusal Anlamda İletişim!
GenAI: Çok Yönlü Yapay Zeka Platformunuz
Articles similaires
Commentaires (0)
Connecte-toi pour commenter.
Se connecter