



Solution pour l'halusination dans l'intelligence artificielle: Qu'est-ce que l'architecture RAG?
Traduit automatiquement
 Auteur
Modèles de grande langue (LLM) Bien qu'ils aient une énorme capacité linguistique, ils ne gèlent pas et restent dans l'histoire de l'octroi de licences de données sur l'éducation, et ils peuvent produire de fausses informations qui sont confiantes sur ce qu'ils savent. C'est le RAG architectural qui est devenu la norme de l'industrie aujourd'hui pour résoudre ce problème appelé Halusination et parler de l'intelligence artificielle avec les données actuelles et vérifiées de l'entreprise.
Qu'est-ce que Retrieval-Augmented Generation (RAG) exactement?
Le RAG est un cadre qui permet à un modèle d'intelligence artificielle de s'appliquer à une base de données fiable de l'extérieur avant de répondre. Les modèles linguistiques traditionnels ne répondent qu'aux informations fermées qu'ils apprennent dans la phase éducative et se cachent dans le poids. L'architecture RAG ouvre ce système fermé au monde extérieur ; donne au modèle la possibilité de tester un « livre ouvert » nevi. Ainsi, le problème du manque de données ou de la mise à jour sur la base de la question causée par l'intelligence artificielle est résolu en alimentant les données dynamiques du modèle.
L'importance de l'architecture RAG: 2020 Que nous montre l'article NeurIPS?
Ce concept était au centre du monde de la technologie avec un article révolutionnaire publié par Patrick Lewis et l'équipe dans Meta AI en 2020. « Génération accrue de connaissances Tâches" L'article NeurIPS 2020 a prouvé que les modèles de langue peuvent donner des résultats beaucoup plus réussis en tirant des informations d'une base de données Wikipédia sans avoir à tout mémoriser. Cet article a été le premier indicateur concret que les modèles peuvent saisir le succès à la fine pointe de la technologie sans supprimer le nombre de paramètres dans les trilyons.
Comment fonctionne un système RAG étape par étape?
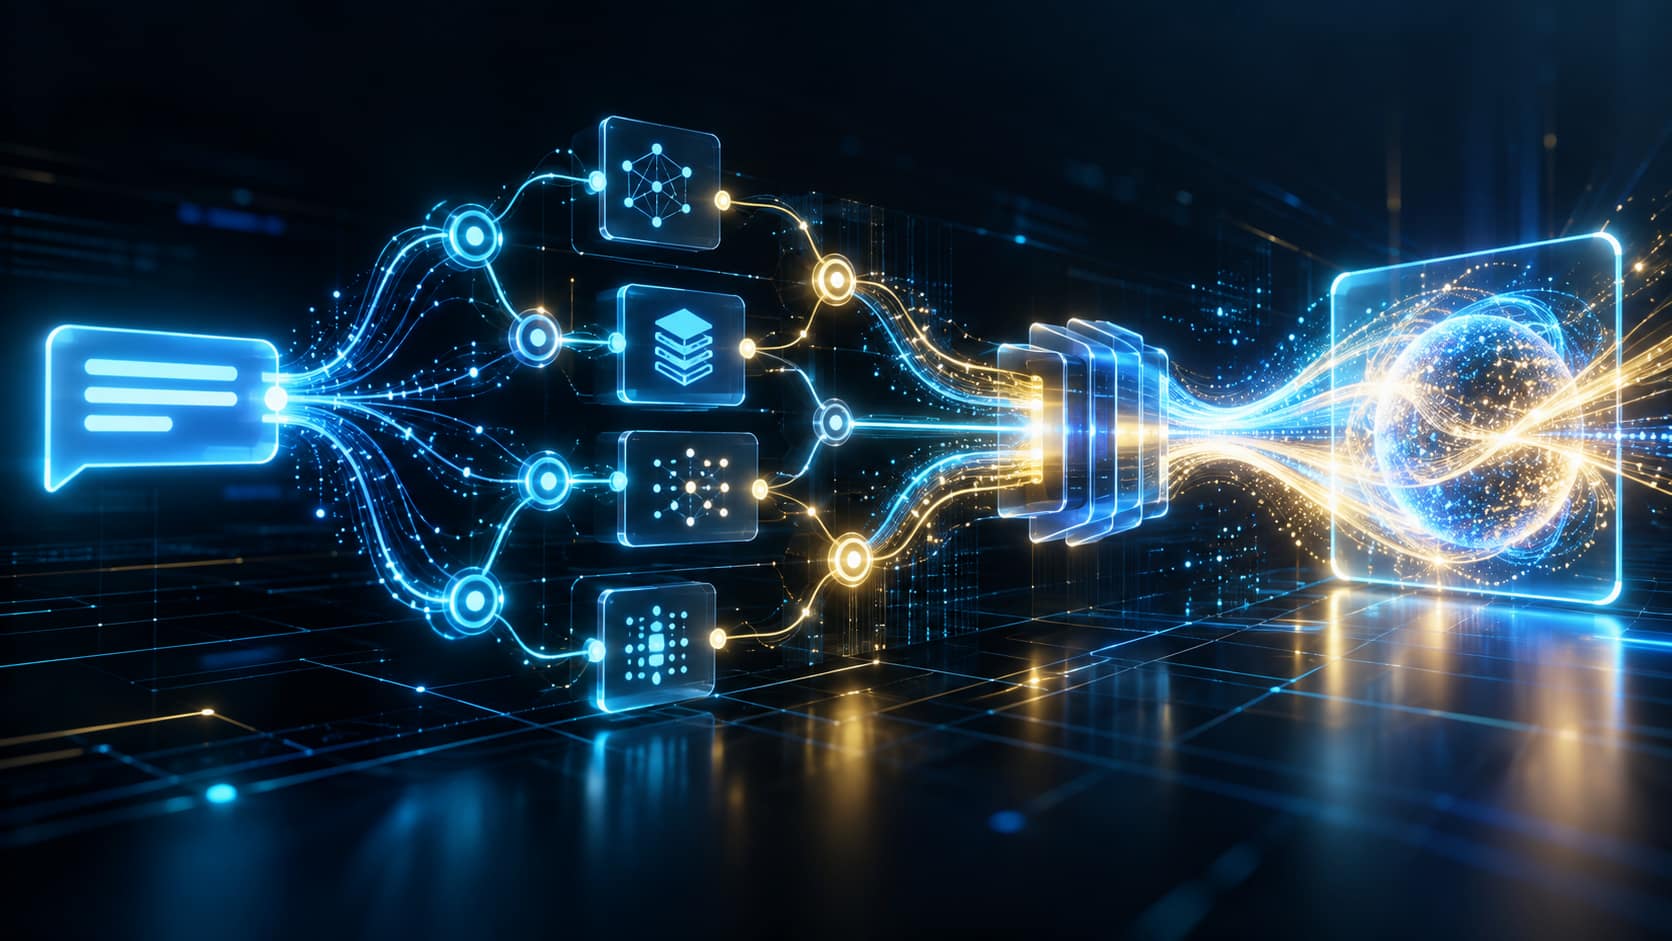
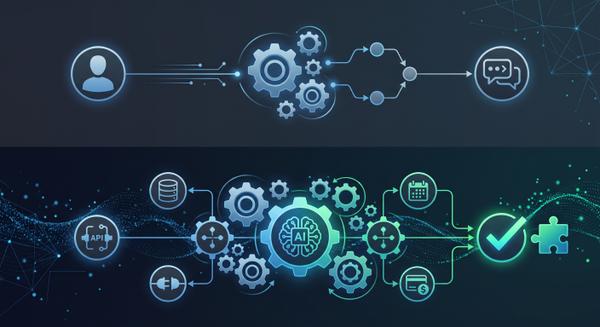
L'architecture RAG se compose de deux phases de base, comme son nom l'indique : Rappel (Retrieval) et Production (Generation). Lorsque l'utilisateur pose une question au système, le modèle arrête le processus au lieu de répondre directement. Le module de rappel fonctionnant avec la logique du moteur de recherche fait les documents les plus appariés de la base de données externe avec la question de l'utilisateur. Ensuite, ces documents à jour sont combinés avec la question originale de l'utilisateur (promptromaation) sont présentés au modèle de grande langue. Le modèle linguistique produit une réponse rationnelle, naturelle et spécifique aux ressources pour l'utilisateur final en lisant ce nouveau contexte précis.
Quel est le rôle des bases de données vectorielles dans le processus RAG?
L'architecture RAG est une base de données vectorielle. Les rapports PDF des entreprises ne peuvent pas rechercher rapidement par un modèle linguistique sous la forme standard d'appels de clients ou de correspondance interne. Ces textes sont convertis en milliers de tableaux numériques (vecteurs) avec une transaction appelée "Pinkdding". Les bases de données vectorielles telles que Pinecone, Milvus ou Weaviate stockent ces séquences numériques. Lorsque l'utilisateur pose une question, la question est immédiatement traduite dans le vecteur et les données significatives les plus proches de la base de données sont jumelées en peu de temps à partir de secondes et renvoyées au système.
Pourquoi RAG est-il dans les grands modèles linguistiques?
Aucune entreprise qui veut intégrer l'intelligence artificielle au niveau de l'entreprise ne peut se permettre le discours du modèle par des hypothèses. L'architecture du RAG élimine le coût du recyclage continu. Au lieu de dépenser des millions de dollars de pouvoir de calcul pour enseigner une table financière ou un modèle à jour, le document correspondant est simplement ajouté à la base de données vectorielles. De plus, le RAG maximise la vérifiabilité du système en ajoutant une référence à J'ai reçu cette information de la 4e page du document X.
Agentic RAG: Où est l'avenir de l'intelligence artificielle?
RAG traditionnel Tout comme une bibliothèque statique qui trouve et apporte des documents à la question posée. Mais la nouvelle génération "Sommaire Les architectures RAG transforment le modèle en une prise de décision. Si le système ne trouve pas suffisamment d'informations dans la première recherche, il peut créer des sous-interrogations auto-nouvelles, rechercher sur Internet ou déclencher une API différente pour vérifier les données. Il se transforme en un agent autonome qui ne se contente pas de lire l'intelligence artificielle, construire et la stratégie de recherche, change les flux de travail des industries de densité d'information.
Que pense la communauté?
Dans l'écosystème des développeurs, RAG a deux points de vue actuels sur l'avenir. La majorité soutient que RAG restera toujours une norme de l'industrie avec l'avantage du coût et de la précision, malgré l'expansion de la fenêtre contextuelle. Une autre coupe est les modèles de nouvelle génération avec des fenêtres de contexte énormes comme 2 millions de jetons (par exemple, Gemini 1.5 Pro) prévoit que l'ensemble de la base de données pourrait réduire le besoin d'infrastructures de base de données vectorielles complexes à l'avenir, comme elle peut le lire à la fois.
Foire aux questions
Quelle est la différence entre RAG et Fine-Tuning (Configuration de Thread)?
Le réglage fin reforme les poids intérieurs pour changer en permanence le comportement ou la structure linguistique du modèle; RAG ne change pas le modèle, offre une mémoire instantanée (lien). Pour ajouter de l'information à jour, RAG est utilisé pour adapter le style de la parole du modèle à l'industrie.
Est-ce cher de construire une architecture RAG ?
Le modèle linguistique est beaucoup plus rentable par rapport à la formation à partir de zéro ou de réglage fin continu. Les bases de données vectorielles et les opérations de rappel (retrieval) peuvent être effectuées efficacement même avec du matériel très bon marché.
Le système RAG réinitialise-t-il complètement les hallucinations?
Elle diminue considérablement si elle est complètement réinitialisée. Le modèle peut parfois mal interpréter les données de l'extérieur ou exécuter le contexte, mais parce qu'il fonctionne en fonction de la source, la détection de l'erreur est beaucoup plus facile et correcte.
AuteurSağlık Sektöründe NLP ve Şeffaflık: Klinik Modellerde Güven
Vibe Coding Uygulamaları 16 Bin Veritabanını Açıkta Bıraktı
Articles similaires
Commentaires (0)
Connecte-toi pour commenter.
Se connecter