Aller au contenu
Retour à la liste des articles
Titans ve MIRAS: AI Uzun Süreli Bellek Sorununu Çözüyor
Data science

Titans et MIRAS : Dépannage de mémoire longue durée

Traduit automatiquement
Büşra Özer
Büşra ÖzerAdmin
4 min de lecture

Dans le monde de l'intelligence artificielle, particulièrement les grands modèles de langage (LLM) oublient l'information passée lors du traitement d'énormes piles de données, ou le coût de se souvenir de cette information est d'atteindre des niveaux astronomiques. Introduit par l'équipe de recherche Google Architecture Titans et Cadre MIRASÉtiquettes "test-temps mémorisation" (test mémorisation instantanée) L'IA promet d'apporter une solution permanente au problème de la mémoire à long terme avec sa capacité.
ai uzun süreli bellek sorunu

Cette nouvelle technologie peut traiter des millions de jetons de contexte (context) sans perte et à grande vitesse en mettant à jour les paramètres de mémoire activement, contrairement aux modèles standard Transformer. Dans cet article, nous examinerons la profondeur technique de Titans et MIRAS, comment l'IA convertit la capacité de modélisation de séquence, et les détails basés sur les ressources académiques de cette innovation.

Qu'est-ce que Titans et MIRAS? Bases techniques et innovations

Architecture de transformation traditionnelle, "attention" (kkat) offre une excellente mémoire à court terme avec le mécanisme; mais le coût de calcul augmente considérablement à mesure que la longueur du tableau augmente. Chercheurs Google par Ali Behrouz, Meisam Razaviyayn et Vahab Mirrokni 4 décembre 2025 a annoncé cette étudeÉtiquettes RNN (Norious Networks with Burning) combiner vitesse et précision des transformateurs.

  • Architecture Titans : C'est l'outil « physique » du système. Contrairement à la mémoire RNN traditionnelle, Titans résume les données passées en utilisant un réseau nerveux profond (capteur multicouche - MLP).
  • Cadre MIRAS : MIRAS est un cadre théorique développé pour généraliser ces approches. Elle définit la modélisation séquentielle comme un problème de « mémoire supplémentaire » (mémoire associative) et distingue l'architecture de la mémoire en quatre composantes principales, y compris l'attention réfléchie (le biais intentionnel), la porte de rétention (porte de rétention) et l'algorithme de mémoire.

Comment les Titans fonctionnent ? Apprentissage actif avec "Surpriz Metriği"

Ce qui rend Titans unique est d'apprendre à se souvenir activement au lieu de stocker des données passivement. Dans ce processus, la tendance à « obtenir des événements inattendus » en psychologie humaine est transformée en un modèle mathématique.

  • Surprise Civilization (Surprise Metric): Le modèle mesure la différence entre les nouvelles données et l'état actuel de la mémoire. Si les données correspondent à une caliba attendue (faible surprise), la mémoire n'est pas mise à jour. Cependant, si les données sont inattendues (haute surprise), cette information est marquée comme « préparée » et est sauvegardée principalement dans la mémoire à long terme.
  • Momentum and Remember Gate: Titans utilise un mécanisme d'impulsion qui prend en compte non seulement cette surprise momentanée, mais aussi le flux de surprises dans le passé. Il applique également la dégradation du poids adaptatif (la barrière d'oubli) qui n'a plus besoin de gérer la capacité de mémoire limitée.

Cadre de MIRAS : Transition vers un paradigme au-delà du MSE

La plupart des modèles disponibles sont basés sur des méthodes normalisées telles que Error Squares Medium (MSE) ou la palpitabilité des points lors de la comparaison des données. MIRAS offre les formats de « cibles uniques » et de nouvelle édition (régularisation) qui dépassent cette restriction. Trois modèles spéciaux ont été développés dans ce cadre :

  1. Oui. Plus résistant aux erreurs (Utilise la perte de Huber), effectue des performances élevées dans les données sales ou non cohérentes.
  2. Mobile : Il vise une mémoire stable à long terme en utilisant des règles plus disciplinées et des sanctions mathématiques complexes (normes générées).
  3. MÉMOIRE: Ils sont difficiles à traiter la mémoire comme une carte de probabilité solide pour maximiser la stabilité de la mémoire.
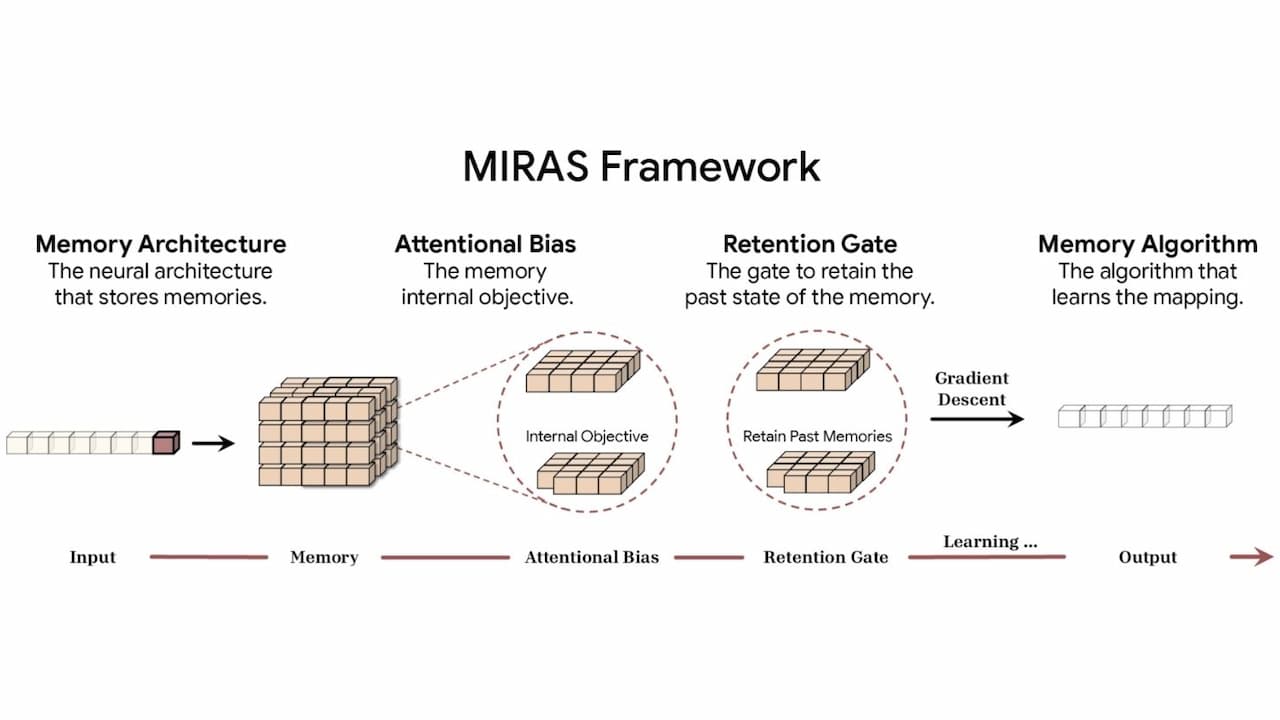
miras framework gorseli

Quels sont les résultats de mémorisation et de rendement?

Les variantes Titans et MIRAS ont été comparées à des architectures de pointe comme Transformer++, Mamba-2 et Gated DeltaNet.

  • Sur Long Connect Rappel: modèles gigantesques tels que Titans, GPT-4 dans BABILong tests de référence laissés derrière, bien qu'il a beaucoup moins de paramètres.
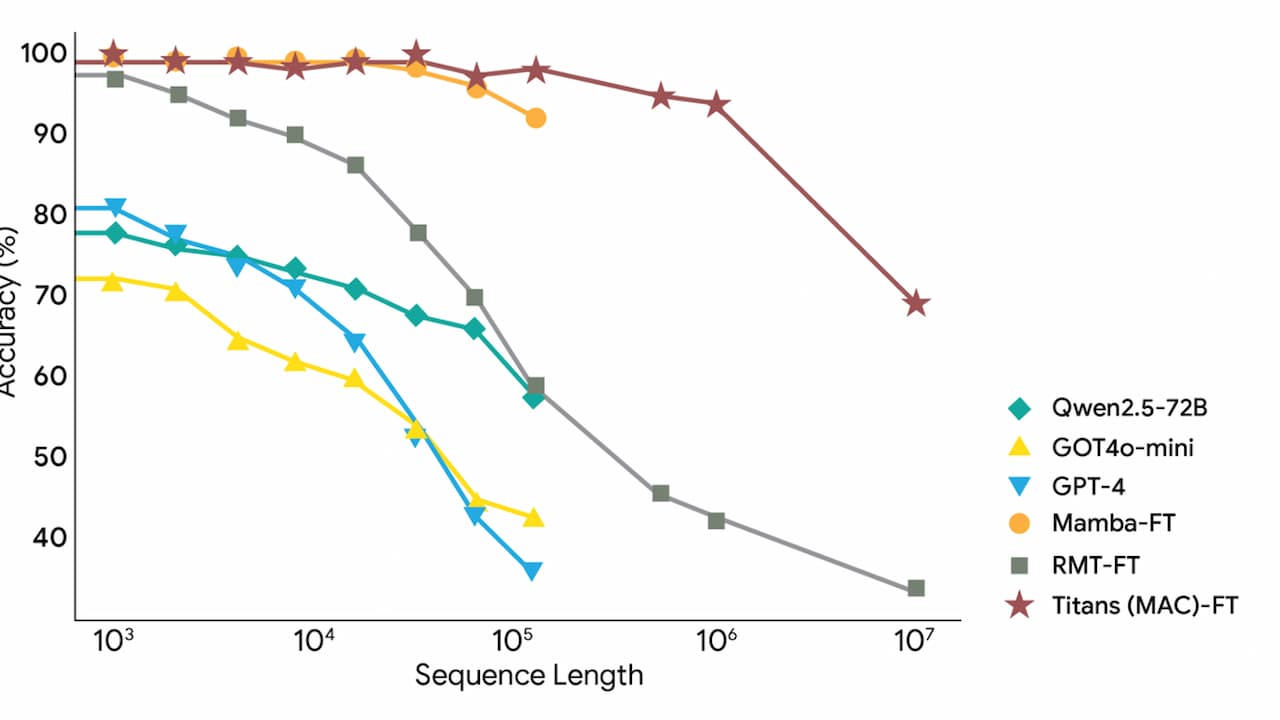
  • Limite de 2 millions de jetons : La recherche a prouvé que Titans peut effectivement élargir les fenêtres de contexte de plus de 2 millions de jetons.
  • La génomique et le succès des séries chronologiques : Les Titans ne se limitent pas seulement aux textes; la modélisation de l'ADN (GenomicsBenchmarks) et les travaux de prévision de séries chronologiques donnent également les meilleurs résultats (de pointe).
  • Performance of Titans on extreme long-context reasoning

    Pourquoi Titans et MIRAS sont-ils l'intelligence artificielle du futur ?

    Les modèles traditionnels devaient supprimer les anciennes informations lorsqu'ils lancent des documents énormes ou ralentissent ou exécutent la fenêtre contextuelle. L'architecture Titans a montré que l'augmentation de la profondeur de mémoire (L M) réduit la complexité et le modèle reste plus "tutarlı".

    Le cadre MIRAS a complété l'anneau perdu entre optimisation en ligne, mémoire relationnelle et conception d'architecture en apportant l'unité théorique au monde de modélisation de l'intelligence artificielle classé. Cela signifie que l'intelligence artificielle n'est pas seulement un système « non champ » qui synthétise et comprend toute l'histoire qui lit.

    Ainsi, le problème de la mémoire à long terme de l'IA normalisera l'utilisation de l'intelligence artificielle à long contexte (IA à long contexte) dans de nombreux domaines, de l'analyse génomique aux examens juridiques complets de documents. Cette révolution de Google Research ouvre une nouvelle page sur l'intelligence artificielle en combinant l'efficacité RNN avec la puissance Transformatrice.

    Dans le monde de l'intelligence artificielle, particulièrement les grands modèles de langage (LLM) oublient l'information passée lors du traitement d'énormes piles de données, ou le coût de se souvenir de cette information est d'atteindre des niveaux astronomiques. Introduit par l'équipe de recherche Google Architecture Titans et Cadre MIRAS Étiquettes "test-temps mémorisation" (test mémorisation instantanée) L'IA promet d'apporter une solution permanente au problème de la mémoire à long terme avec sa capacité. Cette nouvelle technologie peut traiter des millions de jetons de contexte (context) sans perte et à grande vitesse en mettant à jour les paramètres de mémoire activement, contrairement aux modèles standard Transformer. Dans cet article, nous examinerons la profondeur technique de Titans et MIRAS, comment l'IA convertit la capacité de modélisation de séquence, et les détails basés sur les ressources académiques de cette innovation. Qu'est-ce que Titans et MIRAS? Bases techniques et innovations Architecture de transformation traditionnelle, "attention" (kkat) offre une excellente mémoire à court terme avec le mécanisme; mais le coût de calcul augmente considérablement à mesure que la longueur du tableau augmente. Chercheurs Google par Ali Behrouz, Meisam Razaviyayn et Vahab Mirrokni 4 décembre 2025 a annoncé cette étude Étiquettes RNN (Norious Networks with Burning) combiner vitesse et précision des transformateurs. Architecture Titans : C'est l'outil « physique » du système. Contrairement à la mémoire RNN traditionnelle, Titans résume les données passées en utilisant un réseau nerveux profond (capteur multicouche - MLP). Cadre MIRAS : MIRAS est un cadre théorique développé pour généraliser ces approches. Elle définit la modélisation séquentielle comme un problème de « mémoire supplémentaire » (mémoire associative) et distingue l'architecture de la mémoire en quatre composantes principales, y compris l'attention réfléchie (le biais intentionnel), la porte de rétention (porte de rétention) et l'algorithme de mémoire. Comment les Titans fonctionnent ? Apprentissage actif avec "Surpriz Metriği" Ce qui rend Titans unique est d'apprendre à se souvenir activement au lieu de stocker des données passivement. Dans ce processus, la tendance à « obtenir des événements inattendus » en psychologie humaine est transformée en un modèle mathématique. Surprise Civilization (Surprise Metric): Le modèle mesure la différence entre les nouvelles données et l'état actuel de la mémoire. Si les données correspondent à une caliba attendue (faible surprise), la mémoire n'est pas mise à jour. Cependant, si les données sont inattendues (haute surprise), cette information est marquée comme « préparée » et est sauvegardée principalement dans la mémoire à long terme. Momentum and Remember Gate: Titans utilise un mécanisme d'impulsion qui prend en compte non seulement cette surprise momentanée, mais aussi le flux de surprises dans le passé. Il applique également la dégradation du poids adaptatif (la barrière d'oubli) qui n'a plus besoin de gérer la capacité de mémoire limitée. Cadre de MIRAS : Transition vers un paradigme au-delà du MSE La plupart des modèles disponibles sont basés sur des méthodes normalisées telles que Error Squares Medium (MSE) ou la palpitabilité des points lors de la comparaison des données. MIRAS offre les formats de « cibles uniques » et de nouvelle édition (régularisation) qui dépassent cette restriction. Trois modèles spéciaux ont été développés dans ce cadre : Oui. Plus résistant aux erreurs (Utilise la perte de Huber), effectue des performances élevées dans les données sales ou non cohérentes. Mobile : Il vise une mémoire stable à long terme en utilisant des règles plus disciplinées et des sanctions mathématiques complexes (normes générées). MÉMOIRE: Ils sont difficiles à traiter la mémoire comme une carte de probabilité solide pour maximiser la stabilité de la mémoire. Quels sont les résultats de mémorisation et de rendement? Les variantes Titans et MIRAS ont été comparées à des architectures de pointe comme Transformer++, Mamba-2 et Gated DeltaNet. Sur Long Connect Rappel: modèles gigantesques tels que Titans, GPT-4 dans BABILong tests de référence laissés derrière, bien qu'il a beaucoup moins de paramètres. Limite de 2 millions de jetons : La recherche a prouvé que Titans peut effectivement élargir les fenêtres de contexte de plus de 2 millions de jetons. La génomique et le succès des séries chronologiques : Les Titans ne se limitent pas seulement aux textes; la modélisation de l'ADN (GenomicsBenchmarks) et les travaux de prévision de séries chronologiques donnent également les meilleurs résultats (de pointe). Pourquoi Titans et MIRAS sont-ils l'intelligence artificielle du futur ? Les modèles traditionnels devaient supprimer les anciennes informations lorsqu'ils lancent des documents énormes ou ralentissent ou exécutent la fenêtre contextuelle. L'architecture Titans a montré que l'augmentation de la p

    Etiketler:Titans ve MIRAS MimarisiAI Uzun Süreli BellekTest-Time Memorization
    Büşra Özer
    Büşra ÖzerAdmin
    @busraozer

    Commentaires (0)

    Connecte-toi pour commenter.

    Se connecter
    Aucun commentaire pour le moment. Sois le premier à commenter !