Глубинно-ориентированный анализ чувствительности в моделях MoE
Переведено автоматически
 Админ
Большие языковые модели имеют решающее значение для поддержания производительности и эффективности, становясь все более сложными с каждым днем. Хотя архитектура Mixture-of-Experts (MoE) обеспечивает этот баланс, относительная важность каждого слоя MoE в модели была недостаточно понята. Особенно в контексте модели сжатия (модель сжатия) наблюдается отсутствие углубленного анализа. Новое исследование, опубликованное в августе 2026 года, предлагает комплексный точный анализ на основе слоя на модели Qwen3.6-35B-A3B путем заполнения этого пробела и делает значительный шаг для будущей оптимизации BBD.
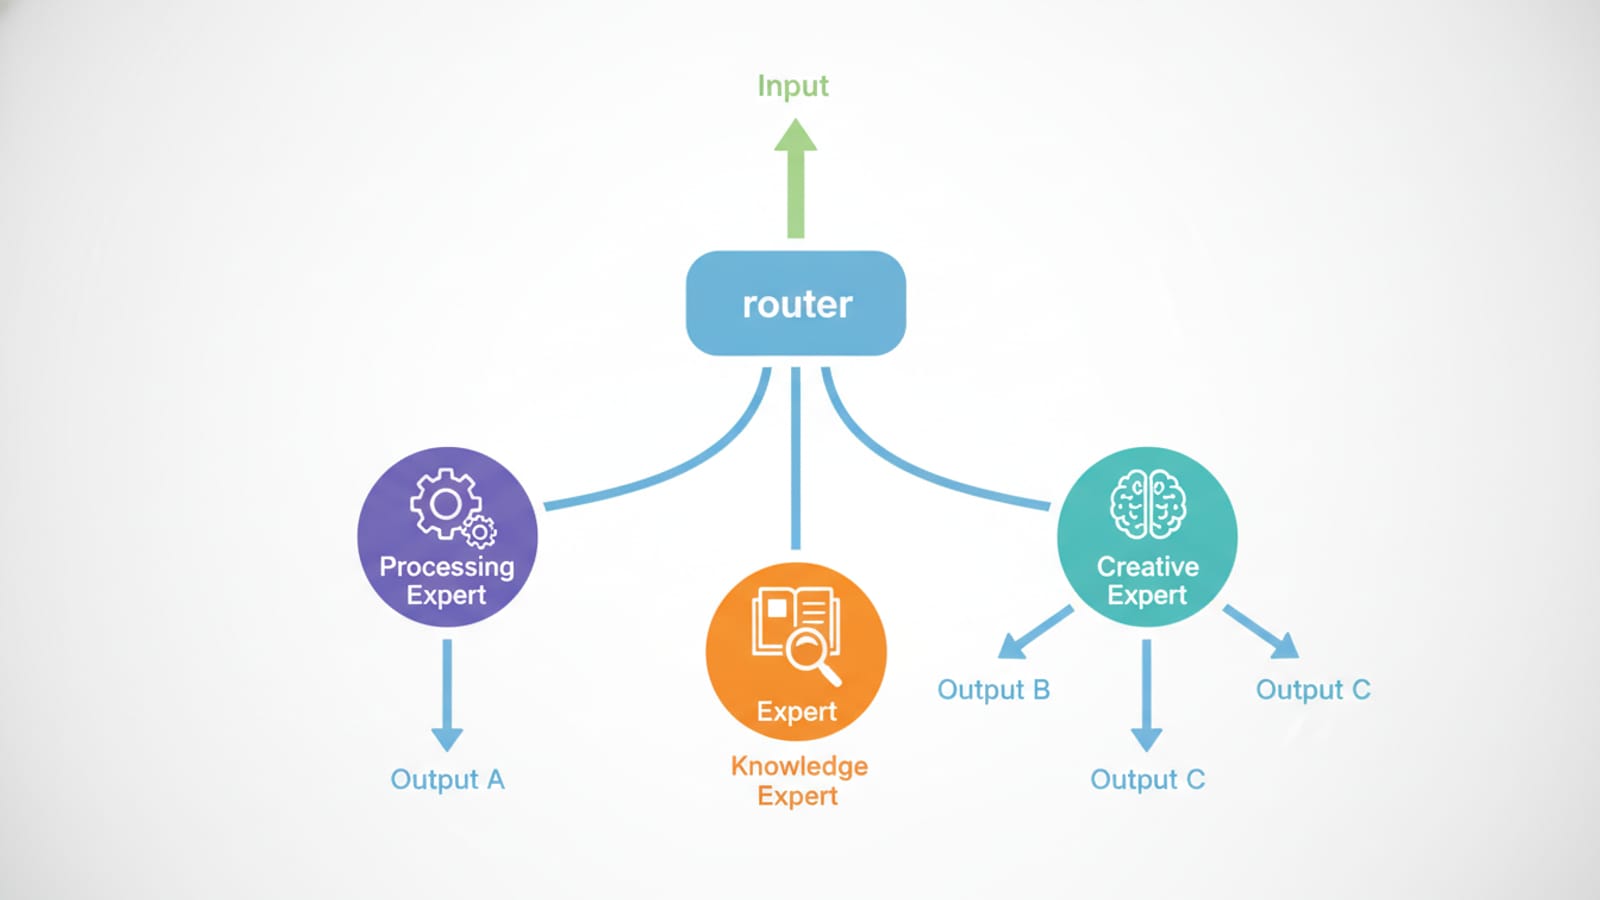
Что такое глубинно-ориентированный анализ чувствительности в моделях MoE?
"Derinlik Oriented Sensitivity Analysis - это методология, которая систематически изучает влияние различных слоев моделей смеси экспертов (МЭ) и экспертов в этих слоях (экспертов) на общую производительность модели. Цель состоит в том, чтобы изучить способы создания небольших или более быстрых моделей без потери производительности, определяя, какие части модели являются более важными. Этот анализ показывает его важность для сложных структур MoE, таких как Qwen3.6-35B-A3B, на основе значений веса (величины) каждого слоя и специалиста.
Смесь экспертов (MoE) Архитектура и принцип работы
MoE - это инновационная структура, которая разделяет большую модель искусственного интеллекта на несколько небольших специализированных подсетей (комановых сетей). Каждый вход (например, текстовый фрагмент) направляется только в наиболее релевантные специализированные сети через механизм перенаправления (маршрутизатор). Подход этой редкой активации (sparseactivation) увеличивает общее количество параметров модели, не увеличивает пропорционально стоимость расчета. Традиционный (преднамеренный) дает более низкую стоимость расчета и более быструю тренировку до 70%, чем BBD. Например, модель Qwen3.6-35B-A3B, 40 слоев MoE, 256 экспертов на слой и имеет структуру «топ-8 маршрутизации», где лучшие 8 экспертов выбираются для каждого токена. Эксперты часто специализируются на более мелких работах, таких как лингвистические процессы или значимые задачи.
Важность сжатия в моделях большого языка (BBD)
Сегодня BBD демонстрируют невероятные таланты, достигая миллиардов параметров. Однако этот размер создает высокие затраты на расчет, энергию и память, которые делают распределение моделей в реальных приложениях. Методы сжатия моделей имеют жизненно важное значение для решения этих проблем и обеспечения более эффективной работы BBD с меньшими ресурсами. Основные методы сжатия включают:
Квантизация (Quantization): Типы параметров данных с более низкой точностью (например, Размер и скорость модели улучшаются за счет преобразования из FP16 в INT-8.
Будама (обрезка): Менее важные параметры или соединения в модели навсегда удаляются. Это снижает сложность и использование ресурсов модели.
Дистилляция информации (дистилляция знаний): Знание более крупной «студенческой» модели обеспечивается сжатием путем передачи меньшей «студенческой» модели.
Анализ чувствительности и магнитно-ориентированный эксперт Маскин г
Целью статьи является определение того, какие слои MoE или эксперты оказывают наибольшее влияние на производительность модели для анализа точности на основе слоев, сжатия модели и оптимизации производительности. Эти типы анализа важны для понимания внутреннего функционирования модели и выявления наиболее важных компонентов. Выражение «Магнатно-ориентированная экспертная маскировка» относится к технике размазывания или анализа, которая включает маскирование или отключение менее важных, оценивая важность весовых значений в соответствии с размером экспертов. Этот подход является способом оптимизации текущей функции тишины в моделях MoE или создания большего разбавления.
Отраслевой контекст: использование Qwen3.6-35B-A3B и MoE
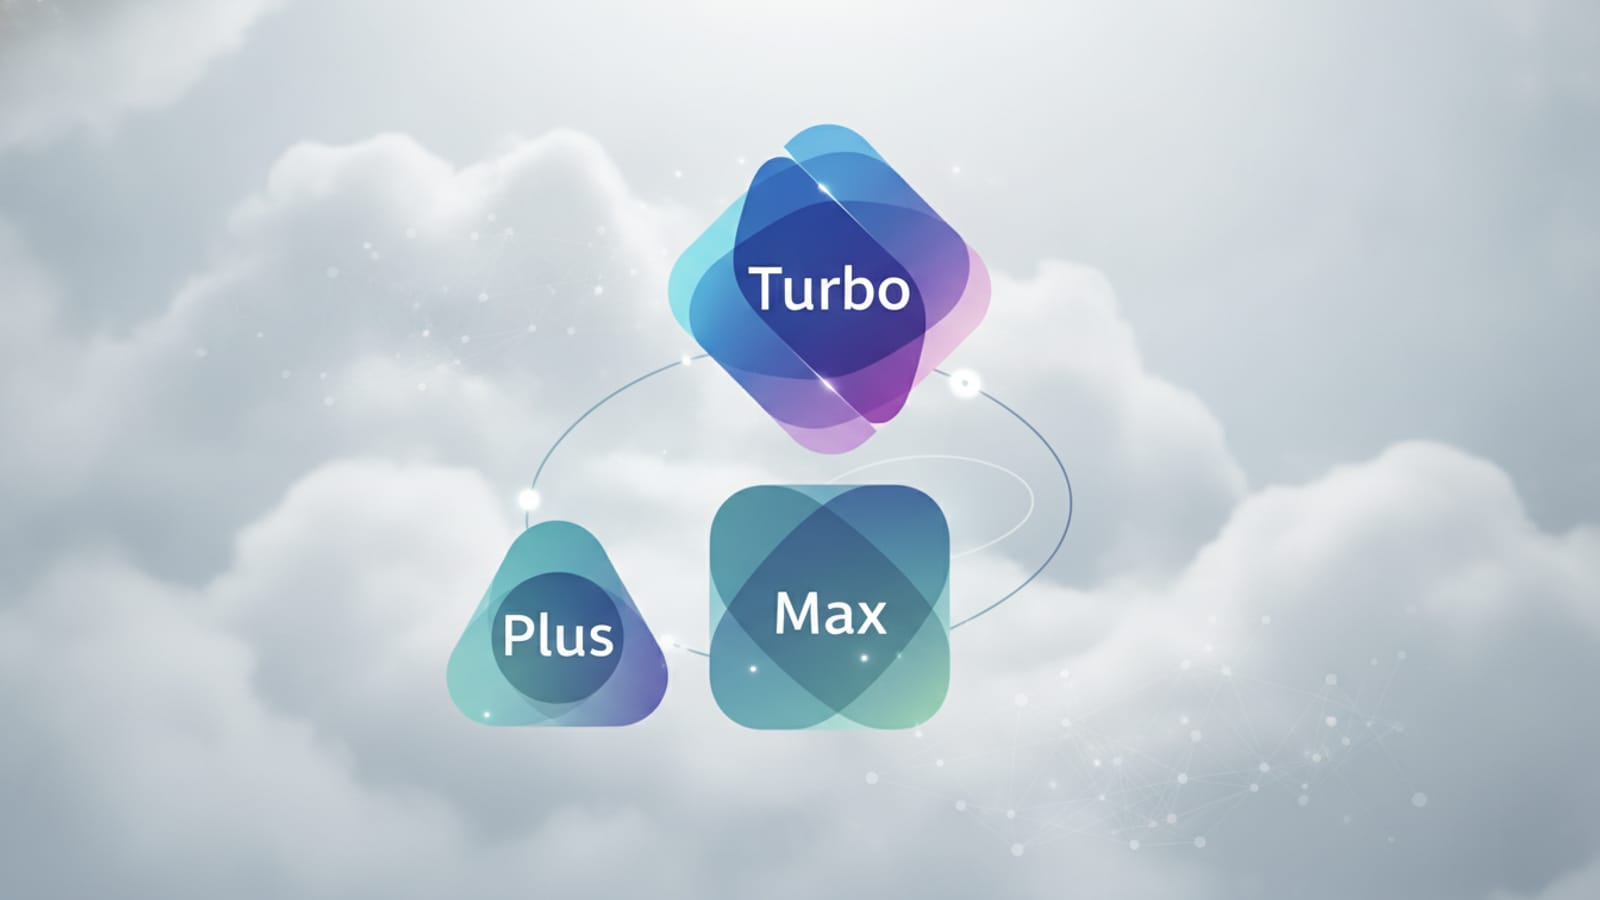
Модель Qwen3.6-35B-A3B, проанализированная Alibaba Cloud, является членом семейства языковых моделей Qwen (Tongyi Qianwen), разработанных Qwen. Семейство Qwen построено на архитектурах, основанных на Трансформере, и особенно признано его многоязычными возможностями, особенно с высокой производительностью в задачах на китайском и английском языках. Этот вариант с 35 миллиардами параметров модели содержит 40 слоев MoE и 256 экспертов на слой. Модели Qwen имеют разные размеры и уровни производительности, такие как Max, Plus и Turbo. Архитектура MoE теперь используется в ведущих моделях, таких как Mixtral 8x7B от Mistral AI, Grok-1 от xAI, DeepSeek-V3 и Databricks.
Что такое сообщество
Сторонники
Сторонники смешанного опыта (MoE) подчеркивают эффективность вычислений и потенциал масштабируемости, которые эти структуры предлагают в соответствии с традиционными интенсивными моделями. MoE делают модели с трилионами еще более управляемыми, обеспечивая более быстрое обучение и время эксплуатации. Таким образом, открывается более широкий спектр использования более крупных и талантливых BBD.
Новости
Некоторые эксперты и критики обращают внимание на сложность и тонкости моделей MoE. Правильная работа механизма маршрутизации (маршрутизатора) создает сложную инженерную задачу для эффективной специализации специалистов и оптимизации всей модели. Кроме того, редкая структура моделей MoE может привести к полной эффективности в некоторых аппаратных архитектурах.
Часто задаваемые вопросы
Почему модели MoE так популярны?
Модели MoE популярны, особенно из-за способности создавать эффективные модели в области моделей большого языка (BBD) с точки зрения высокой производительности и расчета. Благодаря активации креста они позволяют миллиардам параметров работать с меньшими ресурсами и быстро удаляться.
Почему сжатие модели имеет решающее значение для BBD?
Сжатие модели имеет решающее значение для снижения высоких затрат на расчет, память и энергию современных огромных БД. Эти методы позволяют моделям работать на небольших устройствах (например, на мобильных телефонах) и помогают искусственному интеллекту охватить более широкую аудиторию за счет снижения затрат на распространение.
Qwen3.6-35B-A3B Какие характеристики?
Qwen3.6-35B-A3B - отличная языковая модель из семейства Qwen от Alibaba Cloud. Этот вариант с 35 миллиардами параметров предназначен для достижения успеха в особенно эффективных и многоязычных задачах с такими функциями, как слой 40 Mixture-of-Experts (MoE), 256 экспертов на слой и маршрутизация «топ-8».
Что такое магнитная экспертная маскировка?
Магнитно-ориентированная экспертная маскировка менее важна для специалистов, временно или постоянно отключающих технику, оценивая важность специалистов в моделях MoE в зависимости от размера весовых значений. Этот метод помогает определить, какие специалисты в процессах сжатия и оптимизации модели могут передаваться или расставлять приоритеты.
Будущее больших языковых моделей заключается не только в увеличении их размера, но и в формировании их, чтобы сделать их умнее и эффективнее. Точный анализ глубины в моделях MoE может стать важной вехой на этом пути. Понимание вклада производительности каждого уровня и специалиста ищет новые двери для разработчиков для создания более гибких, сильных и устойчивых систем ИИ. Такие исследования предлагают важную информацию для ускорения интеграции технологий искусственного интеллекта в нашу повседневную жизнь.
АдминABD Özel Şirketlere Siber Operasyon Yetkisi Verdi
Yapay Zeka Mühendisliği Olan Üniversiteler 2026