Оккам Устур: Простость — это реальная сила интеллекта
Переведено автоматическиМодели искусственного интеллекта сложны каждый день, один из древнейших философских принципов мира науки до сих пор сохраняет свою актуальность: Оккам УстурЭтот принцип основан на идее, что «простейшее объяснение обычно является наиболее точным», что не должно быть сделано без каких-либо предположений. Итак, как эта мысль кадима формирует современные системы искусственного интеллекта? Occam Ustur является одним из основных принципов, определяющих, как оптимизировать машинное обучение и модели глубокого обучения, а не только философский подход. Искусственный интеллект может обрабатывать больше данных каждый день и принимать более сложные решения. Но в этой сложности есть элемент баланса: Оккам Устур. Этот принцип был открыт британским философом Уильямом Оккамом в 14 веке.Избегайте незнакомых дубликатов, самое простое объяснение обычно верно.основанный на мысли.
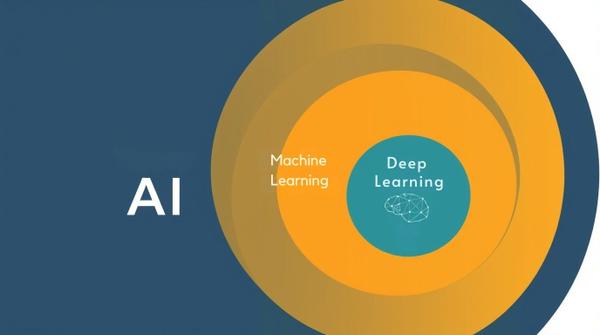
Таким образом, если существует несколько гипотез для объяснения события, предпочтительно, чтобы оно содержало по крайней мере предположение. Для современных сложных моделей искусственного интеллекта это выглядит как почти интуитивное предупреждение, потому что одна из самых больших проблем современного ИИ неэффективна. Целью моделей в системах машинного обучения (ML) и глубокого обучения является понимание данных. Сегодня эффект Оккама Устура отчетливо виден в промышленных приложениях, а не только в теории. В эпоху больших данных модели, обученные данным в огромных размерах, стали жизненно важным инструментом для сохранения понятности, масштабируемости и энергии. Например, в моделях на основе трансформеров Google или в серии GPT OpenAI эта мысль напрямую связана с увеличением скорости обучения и эффективности с архитектурной простотой.
Математика против Оккама Устура в искусственном интеллекте
Одним из важнейших факторов, определяющих успешность моделей искусственного интеллекта, является баланс между сложностью и точностью. Вот один из древнейших и наиболее эффективных философских принципов, используемых для обеспечения этого баланса. Британский философ в 14 веке Уильям ОккамЭтот принцип раскрывается на основе мысли о «неприемлемых предположениях». Короче говоря, если существует несколько гипотез, объясняющих проблему, то самая простая из них считается наиболее точной. Этот подход напрямую связан с теорией статистического обучения, которая является основой современного ИИ.
Модели машинного обучения создают сложные функции для поиска изображений в данных, но модель не справляется с новыми данными, когда она адаптируется к набору данных. Occam Ustur в основном ниже, чем ошибка обобщения более простых моделей.
Эта идея объясняется принципами Колмогорова «Комплексность и минимальная длина описания (MDL)». Колмогоров Сложность утверждает, что подход MDL является лучшей моделью «самого короткого кода», который должен объяснять данные. Так что если мы можем выразить модель как короткую и простую, то модель считается такой прочной. Это основа методов регуляризации (выравнивания), используемых в современном искусственном интеллекте. Сегодня этот принцип применяется в моделях машинного обучения:
ДомойРегуляризация L1 и L2Предотвращает то, что модель имеет больше параметров, упрощает вес.
ДомойБлизкие тегивременное отключение некоторых нейронов в моделях глубокого обучения, снижение ненужной зависимости;
ДомойМодельная обрезка и дистилляцияУпростить сложную структуру больших моделей, повысить эффективность без ущерба для производительности.
Почему Оккам Устур? Сила простоты в искусственном интеллекте
Оккам Устура стал одним из основных инженерных законов современного искусственного интеллекта, а не только философским принципом. Цель искусственного интеллекта состоит в том, чтобы создавать модели, которые дают надежные и прозрачные результаты, а не только делать точные прогнозы. Здесь в этот момент активизируется превосходство простых моделей. Системы искусственного интеллекта имеют сложные структуры, такие как глубокое обучение и большие языковые модели (LLM) и риск преодоления данных. Эта ситуация называется переобучением и заставляет модель запоминать. Принцип Оккама Устура гарантирует, что модель защищает баланс смещения и дисперсии, устраняя этот чрезмерный беспорядок. Таким образом, модель фиксирует основные изображения данных, но она не апеллирует к общему шуму. Этот принцип оказывает непосредственное влияние как на академический мир, так и на технологические гиганты. Например:
- Крупные компании искусственного интеллекта, такие как OpenAI и Anthropic, применяют методы «модельного сжатия» (компрессия модели) и «дисперсии знаний» (дистилляция информации). С помощью этих методов информация, полученная из больших моделей, является меньшей, простой моделью, обеспечивающей как энергоэффективность, так и прозрачность.
- Исследователи Google DeepMind подчеркнули, что в статье, в которой они вышли в 2024 году, с названием «Бритва Оккама в нейронном масштабировании», размер моделей искусственного интеллекта увеличивает не точность, а шум. Поэтому иногда большие данные или большая модель не означают лучшего результата.
- В исследовании, проведенном Массачусетским технологическим институтом и Стэнфордом, было показано, что упрощенные модели более последовательны в процессах принятия этических решений в соответствии со сложными моделями. Больше параметров делает системные решения неотключаемыми, в то время как простые модели имеют более удобную структуру для наблюдения человека.
Важность Occam Ustur не только ограничена техническими характеристиками, но и охватывает этические и безопасные размеры. Сегодня системы ИИ используются в таких важных областях, как здравоохранение, финансы и право. Если эти системы спроектированы с ненужной сложностью, процессы принятия решений не могут быть поняты как и как. Эта ситуация дает ИИ объяснимость (объяснимость). Простые, но эффективные модели будут формировать искусственный интеллект будущего не только с точки зрения вычислительной мощности, но и с точки зрения этики и доверия. Потому что когда сложная система выходит из строя, становится почти невозможно объяснить, почему. Однако простая модель предлагает как наблюдение за людьми, так и предсказуемую структуру.
Как применять Occam Ustur в моделях искусственного интеллекта?
Occam Ustur применяется не только как философская концепция в системах искусственного интеллекта, но и как технический принцип, который увеличивает мощность обобщения за счет снижения сложности модели. Современное машинное обучение использует этот принцип в особенно больших языковых моделях (LLM), глубоких нервных сетях (DNN) и потенциальных системах. Вот что соответствует Оккаму Устуре в области искусственного интеллекта:
1. Методы регуляризации (регуляризации):
- L1 (Лассо) Регуляризация:Скачать ненужные параметры в модели 0 кОсобенности выбора HomeПравда. Таким образом, они остаются входными данными, которые действительно вносят свой вклад.
- L2 (Ridge) Регуляризация:Уравновешивает эффект параметров за счет уменьшения весов. Это уменьшает существование модели и обеспечивает более простое представление.
- Бросить:временно устраняет влияние случайных нейронов во время тренировки на нервные сети. Таким образом, модель учится по-разному в каждом учебном туре и показывает простое, но сильное представление.
2.2 Модель Будама и сжатие (Pruning & Compression):
- Весовая обрезка (Weight Budama):Весы с небольшим значением снимаются с модели. Таким образом, точность остается практически стабильной при уменьшении размера модели.
- Нейронная обрезка:Нейроны, которые способствуют снижению, полностью удаляются из сети. Таким образом, сеть становится более стройной.
3. Model Seçimi ve Bayesian Yaklaşım
- Daha az parametreye sahip modeller, aşırı esnek olmadıkları için daha güçlü genelleme sağlar.
- Bayesian Information Criterion (BIC) veya Akaike Information Criterion (AIC) gibi ölçütler, karmaşık modelleri cezalandırarak basit ama etkili olanları ödüllendirir.
- Bu sayede, model seçimi sürecinde Occam Usturası doğrudan istatistiksel olarak temsil edilir.
4. Gerçek Dünya Uygulamaları
- OpenAI, GPT modellerinde gereksiz parametrelerin çıkarıldığı “model distillation” süreciyle verimliliği %40’a kadar artırıyor.
- Google DeepMind, AlphaZero’nun karmaşık oyun stratejilerini sadeleştirip genelleştirerek daha az veriden daha doğru sonuç almayı başardı.
- Meta (Facebook), model sıkıştırma ve quantization yöntemleriyle enerji tüketimini azaltırken performansı koruyor.
Bu örnekler, Occam Usturası’nın yalnızca teorik değil, endüstri standardı haline geldiğini kanıtlıyor. Occam Usturası, yapay zekada yalnızca bir felsefi ilke değil, aynı zamanda modelin başarısını belirleyen matematiksel bir kural haline gelmiştir. En iyi yapay zeka sistemleri, karmaşayı büyütmek yerine anlamı sadeleştiren, veriden öz bilgiyi çıkaran sistemlerdir. Düzenlileştirme, model sıkıştırma ve Bayesian yaklaşım gibi yöntemler, bu sadeleşmenin teknik karşılıklarıdır. Nihayetinde, yapay zekanın evrimi bize şunu öğretiyor: Gerçek zeka, karmaşık olanda değil doğruyu basitte bulabilme gücünde yatar.
Yapay Zeka Küresel Algısı: UNDP'den Kritik Bulgular
Google Gemini 3 Duyuruldu: İşte Yeni Özellikleri ve Farkı