Почему искусственный интеллект знает неправильную информацию?
Переведено автоматически
 Автор
В исследованиях с большими языковыми моделями (LLM) ответы, предлагаемые в рабочих процессах или ежедневных процессах обучения, могут рассматриваться как высококомпетентные, беглые и убедительные. Однако при детальном рассмотрении данного текста может возникнуть академическое исследование, показанное в источнике, что решение суда или историческое событие является полностью вымышленным.
Эта ситуация вызывает у пользователей критический вопрос: делает ли ИИ ошибки, надежен ли искусственный интеллект?
Инструменты искусственного интеллекта не являются комбинацией механизма контроля точности или классической поисковой системы. Знание принципов работы, лежащих в основе этих систем, облегчает ответ на вопрос о том, что такое галлюцинация искусственного интеллекта, и передает результаты, полученные от правильных сеток.
Что такое искусственный интеллект?
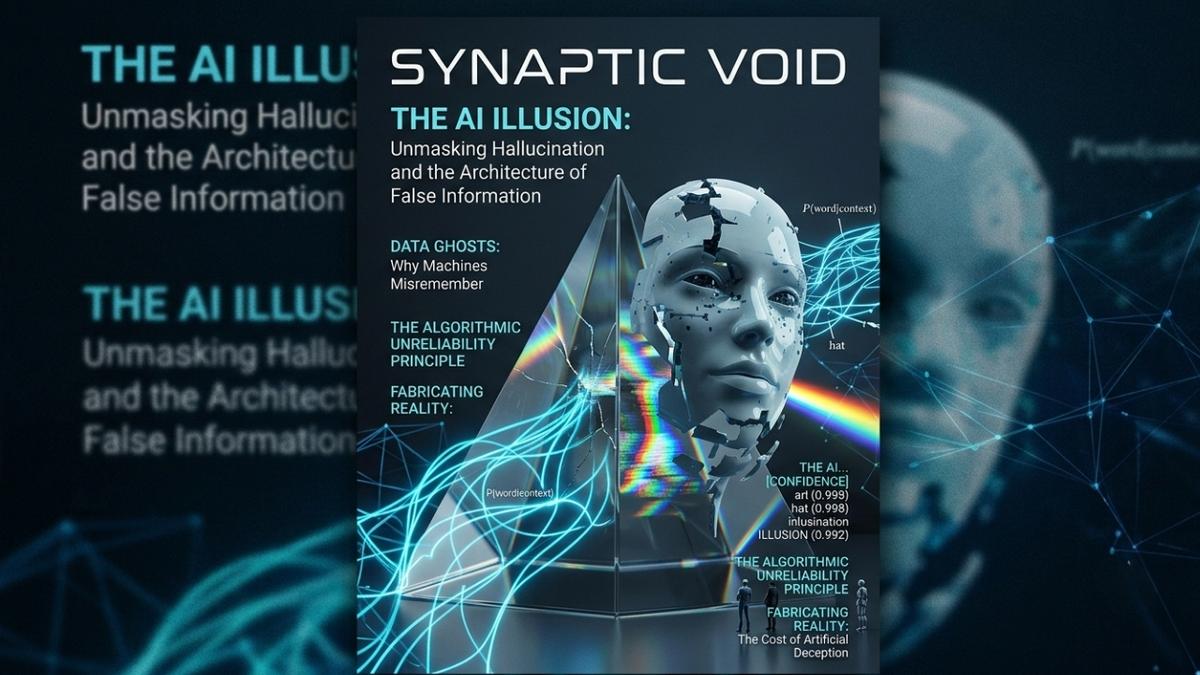
Галлюцинации искусственного интеллекта в технологической литературе — это условие, что модель искусственного интеллекта не существует в реальности, логически базовая или вербально неправильная информация чрезвычайно уверенна, последовательна и свободно реализуется с повествованием.
В отличие от здравомыслия в человеческой психологии, этот процесс не является сознательной иллюзией или преднамеренным обманом. Модель полностью отрывается от казуальной реальности, математически конструируя наиболее логичный массив слов.
Анализ галлюцинаций искусственного интеллекта IBM Home Эти модели не могут отличить неправильное от правильного, как в человеческом разуме. Системы только вычисляют, какие спутники к изображениям образовательных данных (паттернов) и заполняют пробелы через «конфабуляцию» (зеркало), когда они сталкиваются с информационным пробелом. Например, в случае с адвокатом, подготовленным с использованием ChatGPT в США в 2023 году, модель была идентифицирована, что несуществующие идеи, номера файлов и поддельные судебные решения не реализованы. Поскольку модель несовершенным образом имитирует структуру реальных юридических текстов, появившийся на первый взгляд поддельный текст не отличился.
Разница между искусственным интеллектом и обычной ошибкой
Любая неправильная реакция на искусственный интеллект не оценивается в категории галлюцинации. Старая популяция модели находится в пределах «короткой ошибки», чтобы дать информацию языка в переводе или отразиться в техническом расчете. Обычные ошибки в основном можно отслеживать и исправлять с помощью отсутствующих данных или правил транзакций в образовательном наборе.
Галузинация заключается в том, что, несмотря на то, что на полу модели нет реальных данных, она обеспечивает точный тон реальности. Это делает обнаружение галлюцинаций намного сложнее, чем обычные ошибки.
Почему искусственный интеллект знает неправильную информацию?
Прежде всего, чтобы понять, что искусственный интеллект производит ложные выходы. Основы и процесс разработки технологии искусственного интеллекта Тебе нужно знать об этом. Когда модели в основном понимают, что существует архитектура обработки одних данных и вычисления вероятности, логика долей ошибок также понятна:
1.Статистический прогноз и возможный манекен
Большие языковые модели работают с принципом предсказания следующего слова (токена). Модель, Это наиболее вероятно, чтобы прийти к какому слову в статистически после выражения? Основное внимание уделяется ответу на вопрос. Фактическая точность приоритетного предложения для модели не является языковой структурой и в терминах смыслового ядра. При логическом исполнении статистическая вероятность возникает при кровле.
2. 2.Идеальные, нестабильные или сверхспутниковые (переобучающие) данные
Модели обучаются путем сканирования открытых ресурсов, статей и цифровых текстов в интернет-среде. Неправильная информация, содержащаяся в учебном пуле, принимается в качестве общих правил моделью предрассудков или противоречивых утверждений. Кроме того, при адаптации модели к данным образования (переобучение) теряется способность обобщать и устанавливать неправильные связи по ненормальным корреляциям.
3. Обеспечение преодоления соответствия пользовательским вводам
При производстве модели оптимизируются для обеспечения бесперебойного ответа на команду пользователя (быстро). Вместо того, чтобы упоминать, что чаще всего не знает, пользователь ответит, приняв точность запрашиваемой проблемы. Например, когда основной или вымышленный вопрос направлен, вместо того, чтобы отвергать модельный вопрос, пишется вымышленный сценарий, который соответствует предположению о проблеме.
4.Безопасность на открытом воздухе и манипуляции с плохими целями (быстрая инъекция)
Искусственный интеллект производит ложную или вводящую в заблуждение информацию не всегда из-за отсутствия образования модели. Манипуляции снаружи также могут вызвать галлюцинации. С помощью вражеских методов атаки, таких как «быстрый» впрыск, можно манипулировать уровнями безопасности модели и гарантировать, что система производит полностью вымышленные, управляемые или вредные выходы. Понять хрупкость и защитные механизмы от подобных вмешательств систем искусственного интеллекта Что такое безопасность ИИ и что можно взломать Это должно быть рассмотрено всеобъемлющим образом. Фильтры безопасности быстро устраняют согласованность информации в моделях, которые удаляются или манипулируются.
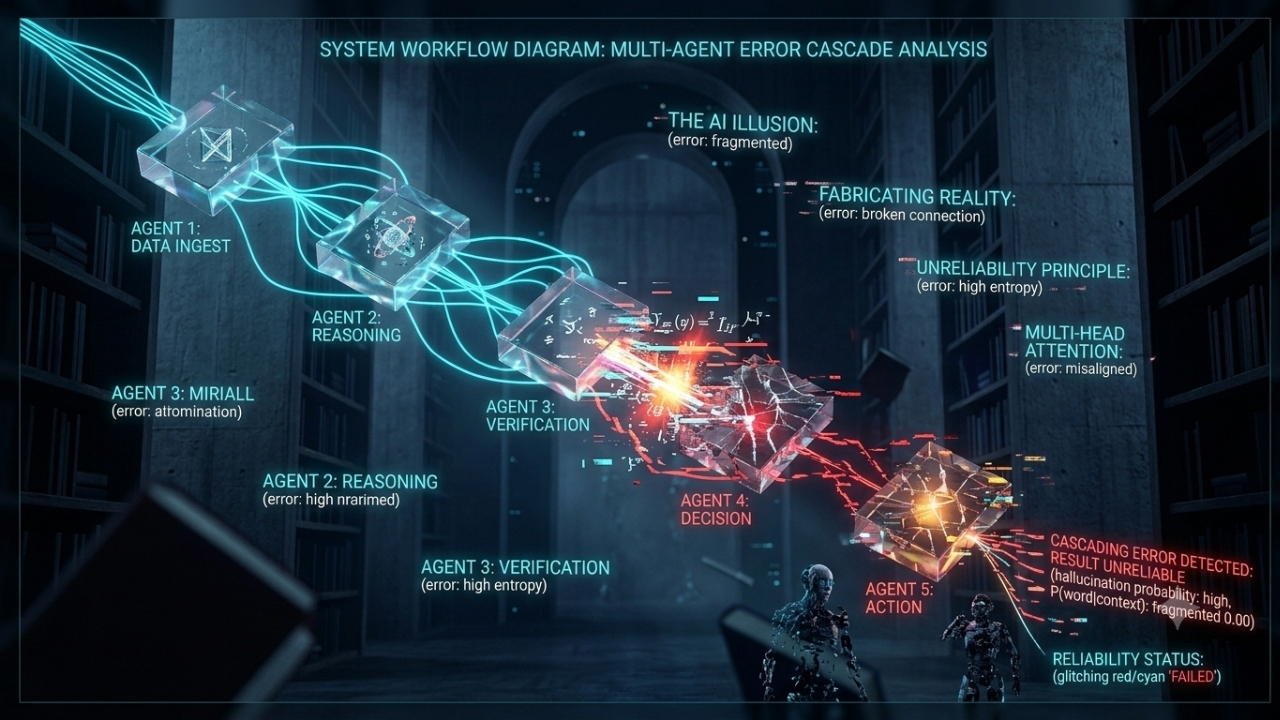
5. Рост ошибок в системах с несколькими агентами (каскадные галлюцинации)
Сегодня автономные агенты искусственного интеллекта работают вместе в цепочке рабочих процессов. Одна галлюцинация, произведенная первым агентом, считается фактом, проверенным следующими агентами, и включается в процессы принятия решений.
Ошибка ChatGPT: надежна ли повседневная жизнь?
Все продуктивные системы искусственного интеллекта, такие как ChatGPT и т. д., могут регулярно ошибаться.
Редактирование текста очень эффективно в таких областях, как разработка идей, создание шаблонов кода, перевод языка и краткое изложение основных концепций. Но важно знать, как технические настройки, такие как температура (температура) или шар p, улучшают качество вывода системы и контролируют случайность. Продвинутые структуры сценариев, применяемые для повышения согласованности респондентов, полученных от модели, и для контроля падений, которые снова падают. ChatGPT Скрытые коды и параметры Доступ можно получить через.
В этих областях, требующих прямого механизма принятия решений, результаты искусственного интеллекта должны оцениваться как конечный источник:
Риск получения ложной или спекулятивной информации о дозировке, симптомах и диагностике высок.
Закон: Мы можем создавать законы о непривязанности или поддельные идеи.
Академические исследования: несуществующие сварщики, подходящие писатели и поддельные номера DOI являются наиболее распространенными типами галлюцинаций.
Финансы могут вводить в заблуждение с помощью неподтвержденных данных о рынке и компании.
Методы снижения риска галлюзинации
Это может быть сведено к минимуму с помощью правильных методов использования, если невозможно полностью сбросить долю ошибок искусственного интеллекта. Такие подходы, как определение роли, пошаговое мышление и ограничение контекста в минимизации риска ингаляций, основные Быстрые инженерные технологии Home непосредственно связанных с ним.
Стратегия | Цель | Пример командного подхода |
|---|---|---|
Роль и определение рамки | Область спекуляций узкая. | "Ответить в рамках исправленного законодательства resmî". |
Неизвестная инструкция | Предотвращает подгонку рефлекса. | Если вы не уверены, что вы не уверены, чтобы сделать прогноз, укажите. |
Обзор сварки и контекстура | Ограничения базы данных. |
Придерживаясь текста в тексте, ответьте на вопросы об этом.
Шаг умственной казни
Повышение логической согласованности.
«С шагами, которые вы следуете, прежде чем прибыть в данный момент».
Можно ли решить проблему галлюзинации?
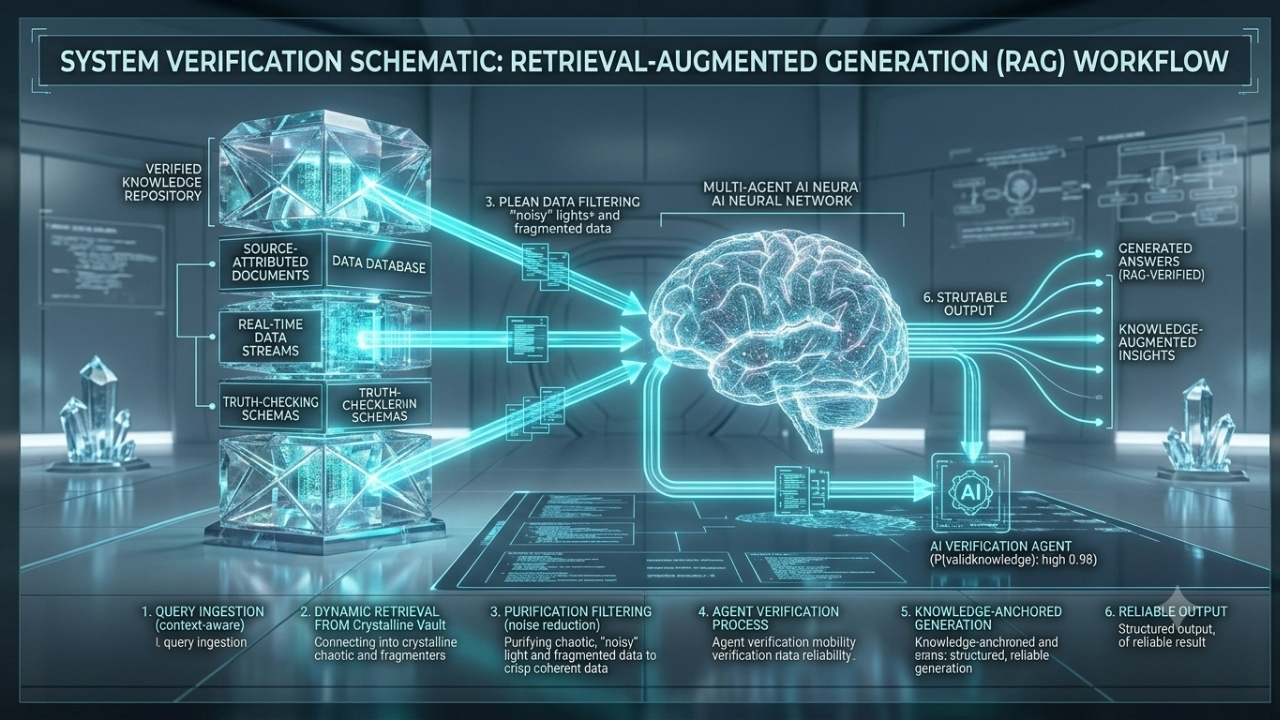
В целях повышения надежности моделей искусственного интеллекта и минимизации риска галлюцинаций проводятся интенсивные исследования и разработки как в академическом мире, так и в технологических компаниях. На сегодняшний день наиболее распространенным и функциональным архитектурным решением в этой области является RAG (Retrieval-Augmented Generation / Repurified Production). Языковая модель в методе RAG применяется к надежным внешним источникам информации, таким как прямая связь талии с потенциальными совпадениями в их закрытой параметрической памяти; запросы мгновенных баз данных компании, современные веб-каталоги или проверенные документы resmî. После извлечения соответствующих исходных данных из этих источников он конфигурирует ответ, активируя свою передовую способность синтеза языка. Таким образом, рефлекс заполнения пространства модели в значительной степени контролируется, и информация размещается на проверенной основе.
В дополнение к архитектуре RAG, новое поколение образовательных методов, которые прозрачны в отношении логических (разумных) шагов моделей, обучения консолидации обратной связи (RLHF - Reinforcement Learning from Human Feedback) и автоматических фильтров точности, которые активируются руководителями искусственного интеллекта, постепенно увеличивают их показатели точности. Кроме того, в систему интегрированы механизмы самопроизводства (самокоррекции), которые модели проверяют свою внутреннюю логику перед генерацией ответа.
Несмотря на все эти технологические достижения, существующие большие языковые модели в основном основаны на предсказании семантического «анинга» или «коучинга»; статистический токен (келим/гес) на огромных наборах данных. В этих возможных двигателях, которые работают математически, нулевая ошибка или абсолютная гарантия точности теоретически невозможны. Разработанные новые методы не сбрасывают скорость галлюцинации; только она может быть обнаружена, ограничена и втягивается в управляемого партнера.
Системы искусственного интеллекта должны позиционироваться как вспомогательные помощники, а не как абсолютный информационный авторитет или правильный механизм; ускоряя сложную работу, но всегда необходимо брать из человеческого фильтра (human-in-the-loop) и фильтра критического мышления.
АвторGemini Ücretli mi? Ücretsiz Sürüm ve Tüm Planlar (2026)
KVKK ve Yapay Zeka: Şirketler Ne Yapmalı?