Прогнозы инфраструктуры данных: что ждет вас в 2026 году?
Переведено автоматически
 Автор
Инфраструктура данных была вне фоновых систем, которые отвечают потребностям хранения данных и отчетности в 2026 году. Таким образом, искусственный интеллект стал основным детерминантом автономных механизмов принятия решений и аналитических процессов в реальном времени. Сегодня, с тех пор, как данные были сделаны, это пришло непосредственно к соответствующей ситуации с тем, как данные моделируются и как они понимаются. Это преобразование; традиционные хранилища данных, Твердые трубопроводы ETL и прямо ставит под вопрос аналитическо-оперативное разделение. По прогнозам на 2026 год, будут выделяться более открытые, более модульные и ИИ-совместимые архитектуры в инфраструктуре данных.
Наступает ли конец аналитическим и операционным системам?
В течение многих лет концепция классической архитектуры данных строилась на двух отдельных мирах. Они выполняют ежедневные операции Операционные системы (OLTP) с отчетностью и поддержкой принятия решений Аналитические системы (OLAP) сортируемый. Такой подход был неизбежен для задержек и сложных уровней интеграции в репликации данных. Но с современными цифровыми продуктами дело дошло до конца этого разделения.
Почему это дискретное значение?
- Отчетность в реальном времени и прогноз приборной панели
- Модели ИИ нуждаются в данных о реальном производстве
- Стриминг и управляемый событиями архитекторобобщение
- Вопросы без копирования данных (аналитика с нулевой копией)
В концепции инфраструктуры данных 2026 года данные в настоящее время используются для многоцелевого использования через единый надежный источник без маркировки «операционный» или «аналитический». Это делает форматы данных стратегическими для подключения слоев и двигателей запросов.
Apache Arrow и ADBC: новые стандарты подключения к данным
Спина современной архитектуры данных Apache Arrow Прогноз развития инфраструктуры данных 2026 годаявляется его основой. Arrow устраняет затраты на преобразование между различными системами, позволяя представлять данные в колоночной и стандартной форме в памяти.
Почему Apache Arrow так важна?
- Высокая аналитическая производительность благодаря компоновке памяти на основе столбцов
- Python, Java, C++, Rust
- Обмен без копирования данных (ноль копирования)
- Подходящая структура для CPU, GPU и векторизованных процессов
- Экосистема данных как общий язык
Что изменяет ADBC с подключением к базе данных Arrow?
ADBCЭто современная альтернатива ODBC и JDBC. При этом стандарт связи на базе Arrow данные не переходят в практику, приложение подходит к данным; упрощается интеграция между аналитическими двигателями и, самое главное, устраняются барьеры между наукой о данных и производственными системами.
Открытые таблицы: Апач Айсберг Почему 2026 победитель?
Апач Айсберг Сегодня в повестке дня не только технические команды, но и технический директор и менеджеры данных. Iceberg выделяется как формат открытой таблицы, который сочетает в себе гибкость озера данных (лак данных); дисциплины хранилища данных.
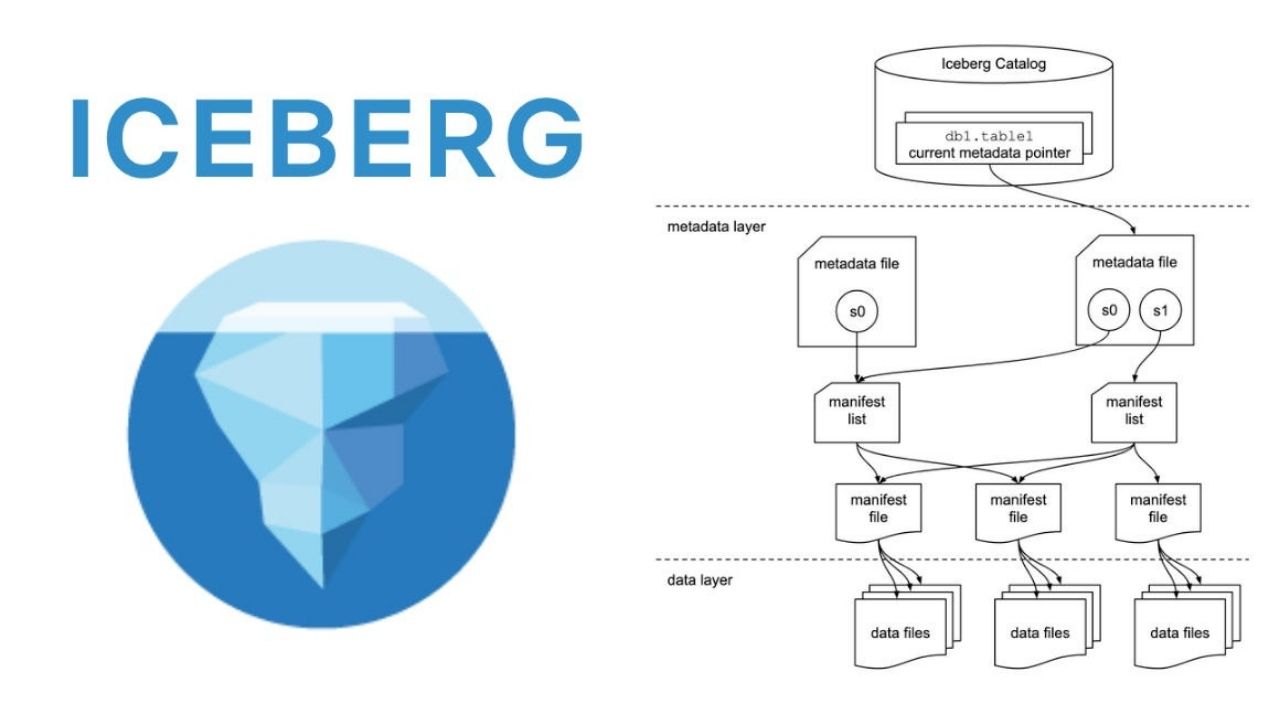
Обнаружены основные компетенции айсберга
- Совместимые настольные операции Home
- Снимок и поддержка путешествий во времени
- Эволюция и ретроспективная совместимость
- Создайте уровень файла, но в поведении таблицы
- Сделайте управление и надежные таблицы в форматах файлов, таких как Parquet.
Дилер масштабируется без зависимости; мультимоторная поддержка, такая как Spark, Trino, Flink, DuckDB; объединение аналитики в реальном времени и пакетной аналитики на одном этаже, в 2026 году Iceberg теперь входит в число форматов открытых столов.
DuckDB и DataFusion: Конец монолитных хранилищ данных
Традиционные хранилища данных были дорогими и часто гибкими системами. Тем не менее, новые тенденции в хранилище данных показывают важность масштабируемых решений в соответствии с потребностями.
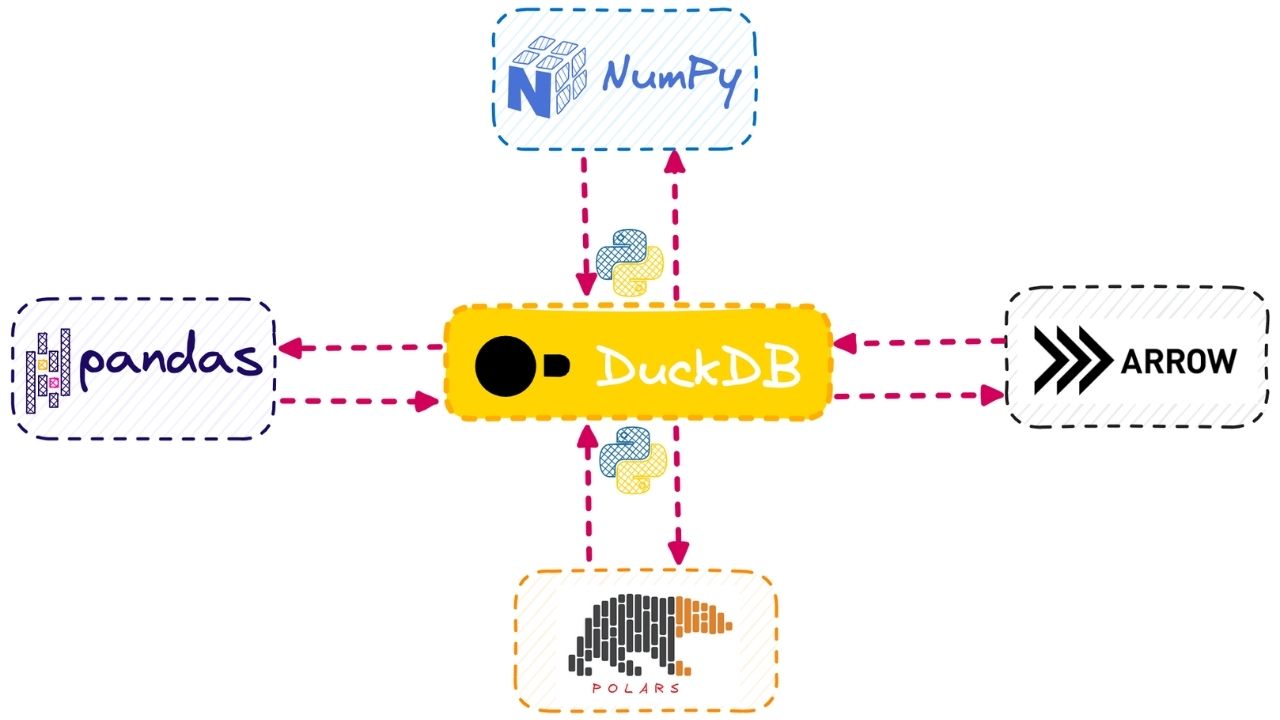
ДомойАналитические запросы - это серверный механизм запросов, который может работать непосредственно на файлах:
- Работает без установки.
- Прямые запросы к таблицам Паркет и Айсберг.
- Python совместим с инструментами R и Data Science.
- Предоставляет масштабируемую аналитику для небольшой магии.
- Это делает хранилище данных несервисным компонентом.
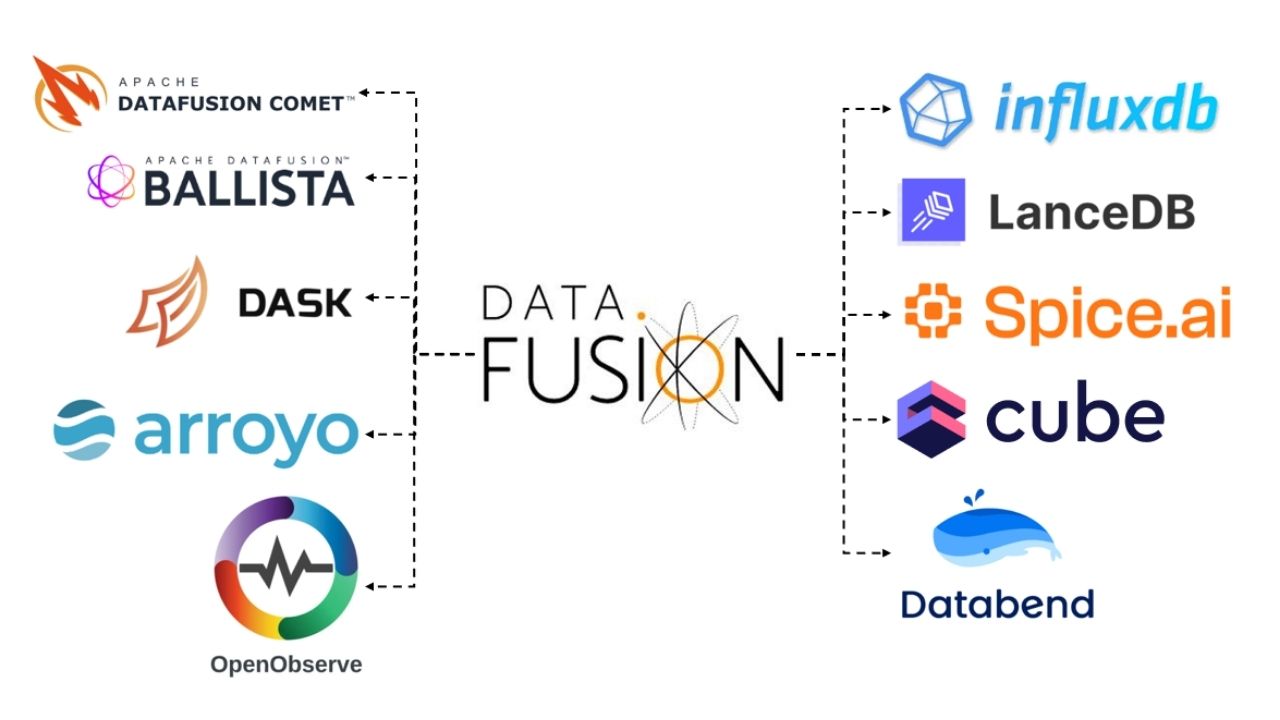
Apache DataFusion - это высокопроизводительный движок запросов, построенный на экосистеме Arrow:
- Rust обеспечивает безопасность памяти
- Может работать во встроенных или распределенных архитектурах
- Совместимость с потоковой передачей и рабочими нагрузками AI
DuckDB и DataFusion При рассмотрении местоположения монолитных хранилищ данных Сводная аналитика Подход виден.
Почему критическое мышление данных таблиц для ИИ-агентов?
Системы искусственного интеллекта в 2026 году будут производить не только текст, но и взаимодействие с данными, принятие решений и область действия. Агенты ИИ Он выйдет на передний план. Успех этих агентов будет напрямую связан с качеством инфраструктуры данных. Архитектура данных искусственного интеллекта установлена на таблицах Айсберга и в форматах памяти Arrow. Будущая оперативная инженерия не будет играть решающей роли в разработке данных. Кроме того, открытые стандарты будут оставаться предпосылкой масштабируемости ИИ. В 2026 году инфраструктура данных закрыта, и ожидается, что брак будет заключаться не в монолитном, открытом и модульном, настольном, а в лаковом, искусственном интеллекте и анализе одновременно.
| 2026 Тенденции данных | Основная точка фокусировки | Ожидаемый эффект |
| Апач Айсберг | Форматы открытых столов | Стандартизация и успех производства |
| Многомоторный стек | Хранение и компьютерное разделение | Экономия затрат и гибкость |
| Интеграция агентов u | Конфигурированные (табличные) данные | Быстрый и безопасный доступ к данным |
| Стандарты ADBC | Уровень подключения данных | Смена старых систем ODBC/JDBC |
АвторApple Creator Studio: Tek Platformda Yaratıcılık Ekosistemi
Yazılım Mühendisliğinde 2026 AI Trendleri