Решение для галюзинации в искусственном интеллекте: что такое архитектура RAG?
Переведено автоматически
 Автор
Большие языковые модели (LLM) Хотя они обладают огромными языковыми способностями, они не замирают и не остаются в истории лицензирования образовательных данных, и они могут производить ложную информацию, которая уверена в том, что они знают. Именно архитектурный RAG стал сегодня отраслевым стандартом для решения этой проблемы под названием Halusination и разговоров об искусственном интеллекте с текущими, проверенными данными компании.
Что такое Retrieval-Augmented Generation (RAG)?
RAG - это фреймворк, который позволяет модели искусственного интеллекта применять к доверенной базе данных информации извне перед ответом. Традиционные языковые модели реагируют только на закрытую информацию, которую они изучают на этапе обучения. Архитектура RAG открывает эту замкнутую систему внешнему миру; дает модели возможность протестировать неви «открытую книгу». Таким образом, проблема дефицита данных или обновления на основе вопроса, вызванного искусственным интеллектом, решается путем подачи динамических данных из модели.
Важность архитектуры RAG: что показывает нам статья NeurIPS 2020?
Эта концепция оказалась в центре технологического мира благодаря прорывной статье, опубликованной Патриком Льюисом и командой Meta AI в 2020 году. "Поколение, дополненное поиском, для наукоемкой НЛП Задачи" Статья NeurIPS 2020 доказала, что языковые модели могут дать гораздо более успешные результаты, извлекая информацию из базы данных Википедии. Эта статья стала первым конкретным показателем того, что модели могут фиксировать современный успех без удаления числа параметров в трилионы.
Как работает система RAG шаг за шагом?
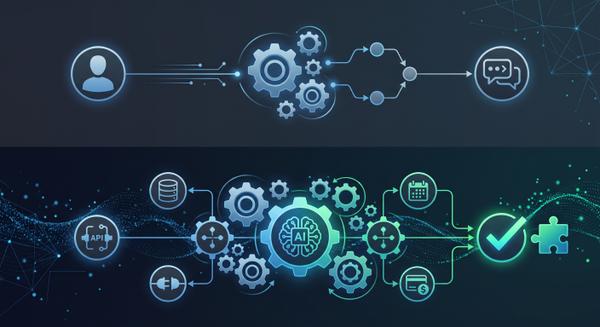
Архитектура RAG состоит из двух основных этапов, как следует из ее названия: «Вспомнить» (Retrieval) и «Производство» (Generation). Когда пользователь задает вопрос системе, модель останавливает процесс, а не отвечает напрямую. Модуль отзыва, работающий с логикой поисковой системы, делает наиболее подходящими документы из внешней базы данных с вопросом пользователя. Затем эти актуальные документы в сочетании с оригинальным вопросом пользователя (промпромацией) представляются в большую языковую модель. Языковая модель обеспечивает упорядоченную, естественную и ресурсную реакцию на конечных пользователей, читая этот новый и точный контекст.
Какова роль векторных баз данных в процессе RAG?
Архитектура RAG представляет собой векторную базу данных. Отчеты компаний в формате PDF не могут быстро искать по языковой модели в стандартной форме звонков клиентов или внутренней переписки. Эти тексты преобразуются в тысячи цифровых массивов (векторов) с транзакцией под названием «Pinkdding». Векторные базы данных, такие как Pinecone, Milvus или Weaviate, хранят эти числовые последовательности. Когда пользователь задает вопрос, вопрос мгновенно переводится в вектор и ближайшие значимые данные в базе данных спариваются за короткое время с секунд и возвращаются в систему.
Почему RAG используется в больших языковых моделях?
Ни одна компания, которая хочет интегрировать искусственный интеллект на корпоративном уровне, не может позволить себе высказывание модели через предположения. Архитектура RAG исключает затраты на непрерывную переподготовку. Вместо того, чтобы тратить миллионы долларов вычислительной мощности на обучение финансовой таблице или современной модели, соответствующий документ просто добавляется в векторную базу данных. Кроме того, RAG максимизирует проверяемость системы, добавляя ссылку на «Я получил эту информацию с 4-й страницы документа X».
RAG: где будущее искусственного интеллекта?
Традиционный RAG Так же, как и статическая библиотека, которая находит и приносит документы на заданный вопрос. Но новое поколение "Домой Архитектура RAG преобразует модель в процесс принятия решений. Если система не находит достаточно информации в первом поиске, она может создать новые запросы, поиск в Интернете или запустить другой API для проверки данных. Он превращается в автономного агента, который не только считывает искусственный интеллект, строит и исследует стратегию, меняет рабочие потоки информационных отраслей.
Что думает сообщество?
В экосистеме разработчиков RAG имеет два основных текущих взгляда на будущее. Большинство утверждает, что RAG всегда будет оставаться отраслевым стандартом с преимуществом стоимости и точности, несмотря на расширение окна контекста. Еще одним сокращением являются модели нового поколения с огромными окнами контекста, такими как 2 миллиона токенов. Домой Дом дома 1.5 Pro) предсказывает, что в будущем вся база данных может уменьшить потребность в сложных векторных инфраструктурах баз данных, поскольку она может читать сразу.
Часто задаваемые вопросы
В чем разница между RAG и Fine-Tuning (настройка потока)?
Точная настройка перенастраивает внутренние веса для постоянного изменения поведения или языковой структуры модели; RAG не изменяет модель, предлагает мгновенную память (ссылку). Чтобы добавить актуальную информацию, RAG используется для адаптации речевого стиля модели в отрасли.
Стоит ли строить архитектуру RAG?
Языковая модель намного более экономична по сравнению с поездом с нуля или непрерывной тонкой настройкой. Векторные базы данных и операции отзыва (поисков) могут выполняться эффективно даже при достаточно дешевом оборудовании.
Система RAG полностью сбрасывает галлюцинации?
Он значительно уменьшается, если полностью сбросить. Модель может иногда неправильно интерпретировать данные извне или запускать контекст, но поскольку она работает на основе источника, обнаружение ошибки намного проще и исправимо.
АвторSağlık Sektöründe NLP ve Şeffaflık: Klinik Modellerde Güven
Vibe Coding Uygulamaları 16 Bin Veritabanını Açıkta Bıraktı