Большие языковые модели (LLM) При обсуждении надежности операционных систем обычно акцент делается на количество параметров или обучающих данных модели. Но чаще всего возникает очень простая техническая деталь, которая упускает из виду: в каком формате мы предлагаем данные модели? Сравнение формата данных LLM является критическим элементом, который не только реагирует на «умную» систему искусственного интеллекта, но и напрямую определяет эксплуатационные расходы.
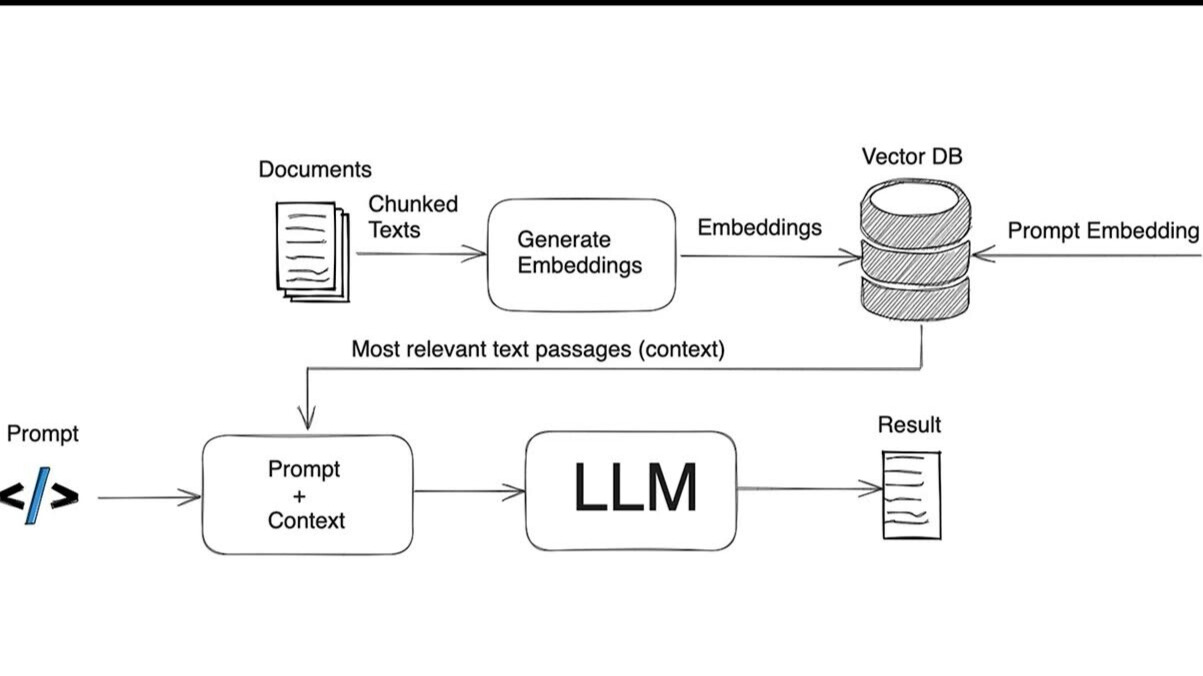
Особенно в процессах оптимизации трубопроводов RAG, таблицах или иерархических данных. (JSON, CSV, Markdown и т.д.) Способ перехода на модель влияет на общий успех системы. Выбор неправильного формата может снизить долю точности данных искусственного интеллекта в результате неправильной интерпретации модели или излишне высокой Стоимость токена LLM С вашим бюджетом. В этом глубоком обзоре мы анализируем производительность различных форматов данных с техническими данными и результатами тестов.
Какой формат предпочитает LLM-таблицы?
1000 различных вопросов о моделях искусственного интеллекта через 1000 зарегистрированных наборов данных контролируемые экспериментыВыявляет влияние выбора формата на точность системы.
- Формат Markdown-KV (Key-Value): В проведенных испытаниях было зафиксировано 60,7% точности. Ключ к каждой записи, а не классические таблицы: эта структура, которая предлагает пары значений, облегчает модель для установления связи между данными.
- XML и INI: Он следует за Markdown-KV с точностью около 56%. Стоимость XML довольно высока.
- CSV и JSONL Performance: Удивительно, но наиболее часто используемая производительность CSV JSONL в науке о данных оставалась довольно низкой. CSV 44,3%, JSONL с точностью 45%. Это указывает на то, что LLM вынуждены ощущать необработанные данные, разделенные запятой.
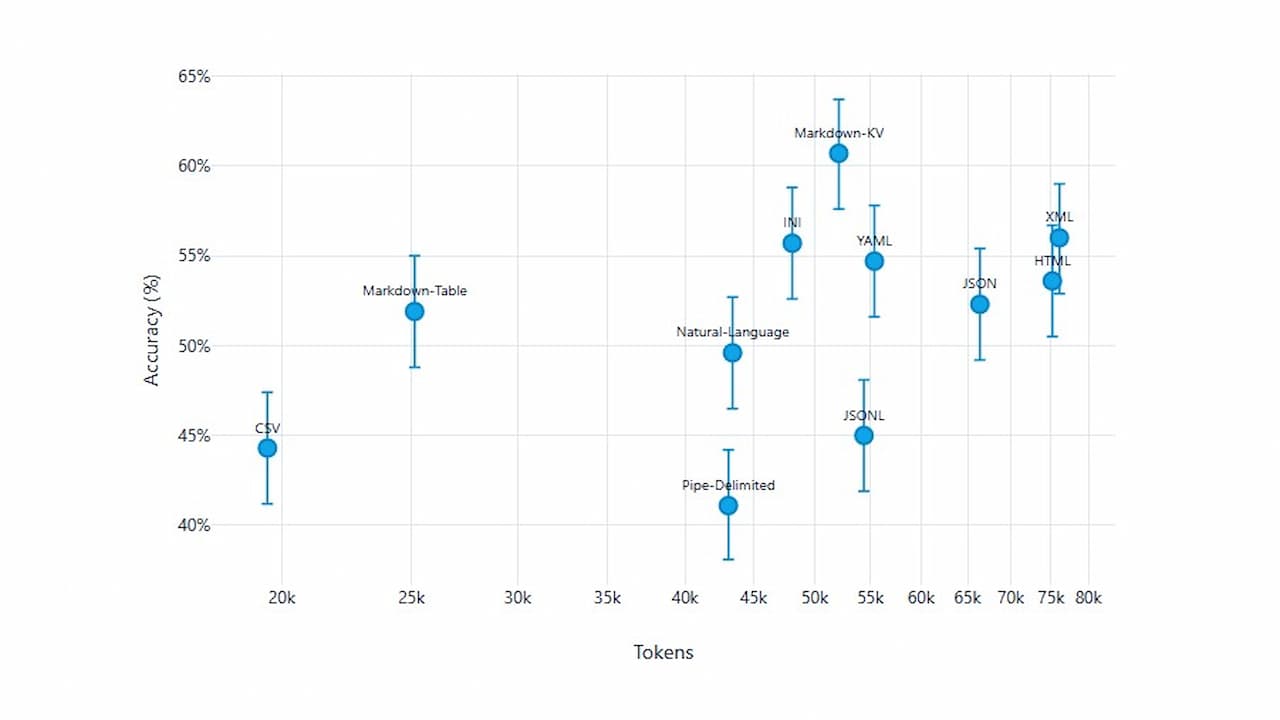
Эффективность токенов: CSV, формат, потребляющий как минимум токены (19 524 токенов) Хотя он имеет один из самых низких показателей точности. Markdown-KV обеспечивает 16-балльную точность, хотя он потребляет в 2,7 раза больше токенов, чем CSV.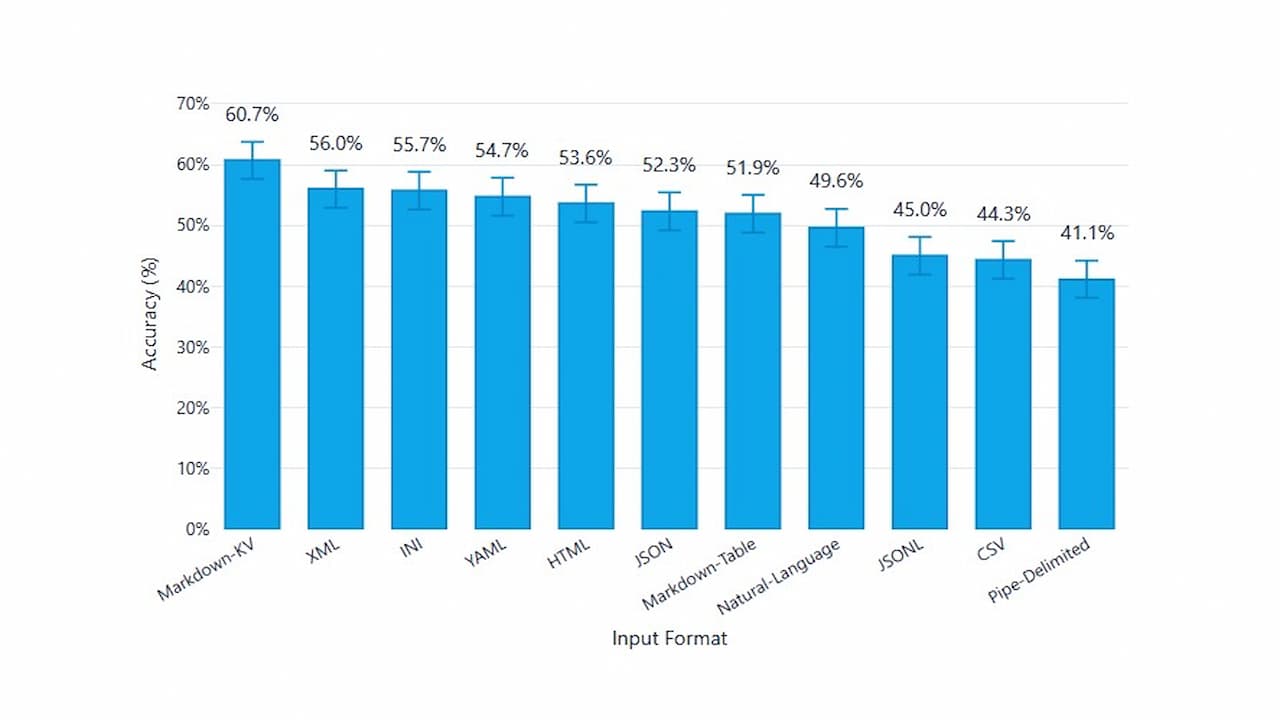
Какой формат лучше всего подходит для хаварки (внутренних) данных?
Современные системы ИИ, как правило, требуются для обработки внутренних данных, таких как ответы API или файлы конфигурации. Сравнение форматов данных LLM предлагает различные результаты от модели к модели.
- Лидер по точности YAML: GPT-5 Nano и Gemini 2.5 Flash Lite Домой показали высочайшую производительность. Визуальная иерархия на основе входа обеспечивает сложные структуры модели «см.».
- Чемпион по расходам: Markdown был самым токен-эффективным форматом во всех моделях. 34-38% от JSON потребляют на 10% меньше токенов от YAML. Идеально подходит для тех, кто хочет минимизировать затраты при сохранении необходимой точности.
- Бедность Джона: Несмотря на широкое использование ДжонОн показал худшую производительность, чем ожидалось, в моделях GPT-5 и Gemini. Только Llama 3.2 дал JSON приемлемые результаты, поскольку точность формата в модели 3B Instruct низкая.
- Сколько стоит XML: XML имеет как самое высокое потребление токенов, так и показатели точности, как правило, включены в последний ряд. Повторные структуры меток () могут распределять механизм внимания модели (внимание).
Как выбор формата влияет на точность трубопровода RAG?
- Что затрагивается? Точность системы RAG (Retrieval-Augmented Generation) зависит от того, как подавать полученную информацию в модель. Неправильный формат приводит модель к неправильной отчетности, основанной на «галфляции».
- Почему важно? Снижение точности данных искусственного интеллекта на 10% может означать катастрофу для бота обслуживания клиентов или инструмента финансового анализа.
Как оптимизировать? Если точность важна прежде всего, следует использовать Markdown-KV или YAML. Если бюджет ограничен, а данные плотные, таблицы Markdown являются хорошим средним способом.Где использовать? Эта оптимизация жизненно важна в любой момент, когда результаты запроса базы данных передаются в LLM.Кто знает? Инженеры данных и архитекторы ИИ должны преобразовать формат данных на этапе разработки в стандарт.Стоимость токена и баланс производительности
Потребление токенов форматов данных — это прямые эксплуатационные расходы. Например, формат XML требует на 80% больше токенов, чем Markdown. Это означает, что вы платите почти в два раза больше денег за обработку одних и тех же данных.
Матрица производительности:
- Приоритет точности (высокий бюджет): Markdown-KV (для листов), YAML (для данных Nested).
- Приоритет баланса: Таблицы разметки.
- Низкая точность (Low Accuracy Acceptance): CSV или JSONL.
Стратегические рекомендации по применению
По результатам сравнения форматов данных LLM использование CSV или JSON может ограничить возможности вашей системы. Рекомендуется следовать этим шагам при сохранении технической глубины:
- Если данные таблицы интенсивно используются в вашей системе, добавьте промежуточный слой, который преобразует данные в формат Markdown-KV перед отправкой в модель.
- Стандартизировать формат YAML для сложных конфигурационных файлов или каталогов.
- Ваша модель (GPT, Llama, Gemini и т.д.) Сделайте небольшие тесты с собственным набором данных, чтобы определить, какой формат более отзывчив.
- Загрузите минимум использования XML, чтобы предотвратить ненужные потери токенов.
Домой "правильно" Нет формата, но в соответствии с вашими целями "оптимизировать" Формат. Если точность критична, YAML и Markdown-KV являются самыми сильными стандартами в мире ИИ на 2025 год и позже, если стоимость критична. Успех системы зависит не только от наличия данных, но и от того, потребляет ли модель их в наиболее чистом и понятном виде.
Большие языковые модели (LLM) При обсуждении надежности операционных систем обычно акцент делается на количество параметров или обучающих данных модели. Но чаще всего возникает очень простая техническая деталь, которая упускает из виду: в каком формате мы предлагаем данные модели? Сравнение формата данных LLM является критическим элементом, который не только реагирует на «умную» систему искусственного интеллекта, но и напрямую определяет эксплуатационные расходы. Особенно в процессах оптимизации трубопроводов RAG, таблицах или иерархических данных. (JSON, CSV, Markdown и т.д.) Способ перехода на модель влияет на общий успех системы. Выбор неправильного формата может снизить долю точности данных искусственного интеллекта в результате неправильной интерпретации модели или излишне высокой Стоимость токена LLM С вашим бюджетом. В этом глубоком обзоре мы анализируем производительность различных форматов данных с техническими данными и результатами тестов. Какой формат предпочитает LLM-таблицы? 1000 различных вопросов о моделях искусственного интеллекта через 1000 зарегистрированных наборов данных контролируемые эксперименты Выявляет влияние выбора формата на точность системы. Формат Markdown-KV (Key-Value): В проведенных испытаниях было зафиксировано 60,7% точности. Ключ к каждой записи, а не классические таблицы: эта структура, которая предлагает пары значений, облегчает модель для установления связи между данными. XML и INI: Он следует за Markdown-KV с точностью около 56%. Стоимость XML довольно высока. CSV и JSONL Performance: Удивительно, но наиболее часто используемая производительность CSV JSONL в науке о данных оставалась довольно низкой. CSV 44,3%, JSONL с точностью 45%. Это указывает на то, что LLM вынуждены ощущать необработанные данные, разделенные запятой. Эффективность токенов: CSV, формат, потребляющий как минимум токены (19 524 токенов) Хотя он имеет один из самых низких показателей точности. Markdown-KV обеспечивает 16-балльную точность, хотя он потребляет в 2,7 раза больше токенов, чем CSV. Какой формат лучше всего подходит для хаварки (внутренних) данных? Современные системы ИИ, как правило, требуются для обработки внутренних данных, таких как ответы API или файлы конфигурации. Сравнение форматов данных LLM предлагает различные результаты от модели к модели. Лидер по точности YAML: GPT-5 Nano и Gemini 2.5 Flash Lite Домой показали высочайшую производительность. Визуальная иерархия на основе входа обеспечивает сложные структуры модели «см.». Чемпион по расходам: Markdown был самым токен-эффективным форматом во всех моделях. 34-38% от JSON потребляют на 10% меньше токенов от YAML. Идеально подходит для тех, кто хочет минимизировать затраты при сохранении необходимой точности. Бедность Джона: Несмотря на широкое использование Джон Он показал худшую производительность, чем ожидалось, в моделях GPT-5 и Gemini. Только Llama 3.2 дал JSON приемлемые результаты, поскольку точность формата в модели 3B Instruct низкая. Сколько стоит XML: XML имеет как самое высокое потребление токенов, так и показатели точности, как правило, включены в последний ряд. Повторные структуры меток ( ) могут распределять механизм внимания модели (внимание). Как выбор формата влияет на точность трубопровода RAG? Что затрагивается? Точность системы RAG (Retrieval-Augmented Generation) зависит от того, как подавать полученную информацию в модель. Неправильный формат приводит модель к неправильной отчетности, основанной на «галфляции». Почему важно? Снижение точности данных искусственного интеллекта на 10% может означать катастрофу для бота обслуживания клиентов или инструмента финансового анализа. Как оптимизировать? Если точность важна прежде всего, следует использовать Markdown-KV или YAML. Если бюджет ограничен, а данные плотные, таблицы Markdown являются хорошим средним способом. Где использовать? Эта оптимизация жизненно важна в любой момент, когда результаты запроса базы данных передаются в LLM. Кто знает? Инженеры данных и архитекторы ИИ должны преобразовать формат данных на этапе разработки в стандарт. Стоимость токена и баланс производительности Потребление токенов форматов данных — это прямые эксплуатационные расходы. Например, формат XML требует на 80% больше токенов, чем Markdown. Это означает, что вы платите почти в два раза больше денег за обработку одних и тех же данных. Матрица производительности: Приоритет точности (высокий бюджет): Markdown-KV (для листов), YAML (для данных Nested). Приоритет баланса: Таблицы разметки. Низкая точность (Low Accuracy Acceptance): CSV или JSONL. Стратегические рекомендации по применению По результатам сравнения форматов данных LLM использование CSV или JSON может ограничить возможности вашей системы. Рекомендуется следовать этим шагам при сохранении технической глубины: Если данные таблицы интенсивно используются в вашей системе, добавьте промежуточный слой, который преобразует данные в формат Markdown-KV перед отправкой в модель. Стандартизировать формат YAML для сложных конфигурац





 Админ