Турецкие модели искусственного интеллекта: BİLGE, Kumru, T3 AI и другие
Переведено автоматически
 Автор
Большие языковые модели имеют очень простой факт, который они пересматривают, скрещивая мир: Независимо от того, насколько талантливы гигантские модели с выходами из силиконовой долины, работа становится другой, когда дело доходит до английского языка. Большинство из нас замечали странные переводные кохановые фразы, которые складываются при работе с этими моделями, лишенными смысла идиомами или просто распространяющими простую техническую проблему на ненужное место. Здесь на данный момент отечественные проекты в области искусственного интеллекта стали техническим обязательством, а не только национальной гордостью.
Сегодня экосистема искусственного интеллекта, разработанная в Турции, не является простым интерфейсом перед моделями OpenAI или Anthropic. Сильная инфраструктура построена с помощью сообществ с открытым исходным кодом, обученных с собственным весом и ориентированных непосредственно на современную структуру турецкого языка.
Как с Денерсином?
Краткая таблица: как получить доступ к этой модели сегодня и включена ли модель (14.10.2026).
Домой | разработчик | Как получить доступ? | Вне помещений / Indoor |
|---|---|---|---|
Новости | Тубитак | еще не открыты для общего использования; для пилотных проектов © Copyright 2018. Все права защищены. Скриншоты Tubitak Ticket | Закрыть |
Домой У | ВНГРС | Домой Kumru-2B на обнимающем лице | 7,4B off, 2B open (Apache 2.0) |
T3 AI AI | Фонд T3 и Baykar | Открыта как бета-версия социальной платформы «ТЭКНОФЕСТ» в 11.07.2025 | Цель с открытым исходным кодом; не разделяет загружаемый вес |
Трендиол LLM | Домой | Обнимающее лицозагружаемый | Вес на открытом воздухе |
Домой | Университет Босфора ТАБИЛАБ |
Обнимающее лицозагружаемый
Открытое, некоммерческое академическое использование
Домой
Домой
Частные учреждения, платформа, встроенная в институт
Закрыть
Почему глобальных моделей пока нет?
В то время как глобальные ИИ обучаются с трилионами, небольшая часть этих данных состоит из турецких. Эта ситуация порождает две основные проблемы:
Токены и высокие счета:
Токены, разработанные по-английски, не могут решить корень и дополнительную логику турецкого языка. Простое слово делит 3-4 части (токена). Это добавляет как счета за использование API, так и увеличивает время генерации ответа системы в баре.
Культурно-правовой контекст:
Довольно рискованно проводить анализ контрактов, подходящих для турецкого Коммерческого кодекса глобальной модели, или классифицировать жалобу клиента с правильным чувством. Потому что модель ссылается на западную культуру и логику американского права как на дефолт.
Чтобы ликвидировать этот дефицит, академия сосредоточилась на разработке турецких моделей искусственного интеллекта путем объединения общественных и независимых инициатив в Турции.
Что работает на сайте? Избранные модели Native
Проекты искусственного интеллекта в Турции HomeРеагирует на различные потребности, от поддерживаемых государством крупномасштабных инфраструктур до гибких решений.
1. BİLGE: семейство языковых моделей от TÜBİTAK
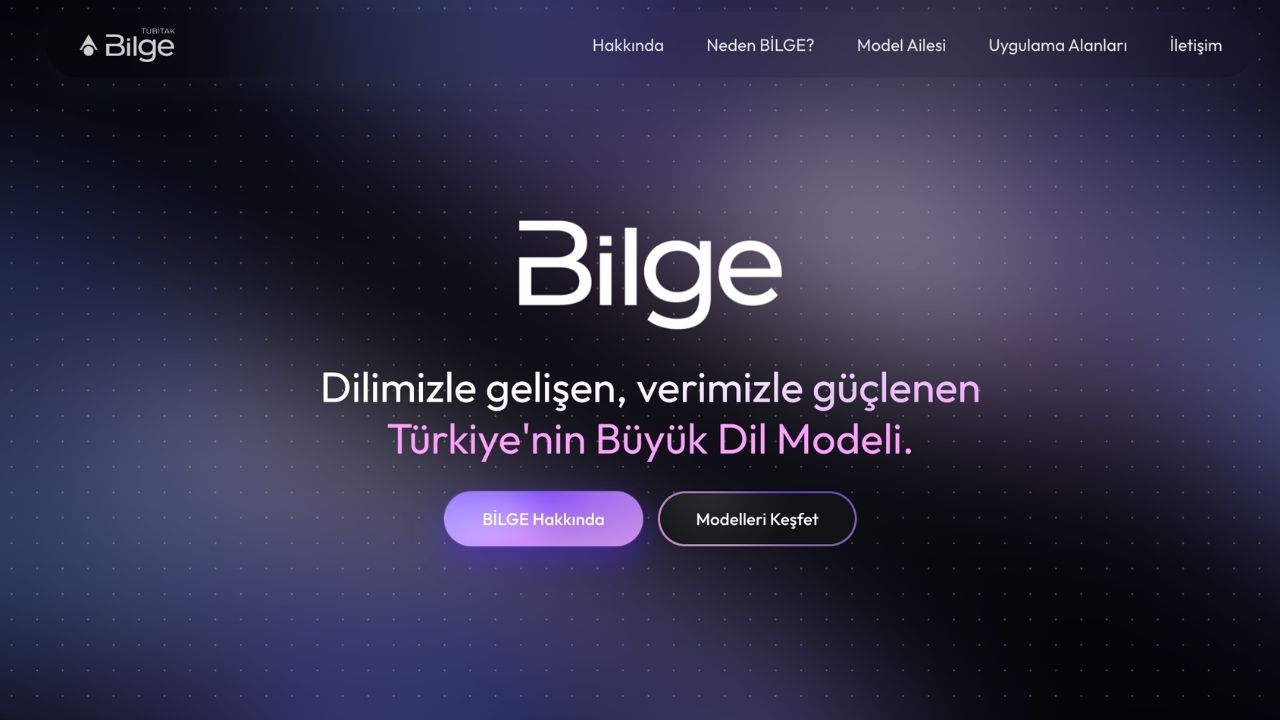
Наиболее конкретный и всеобъемлющий шаг со стороны общественности осуществляется компанией TÜBİTAK BİLGEM. Новости Проект был. Самая большая претензия BİLGE заключается в использовании турецкого языка в качестве родного языка без перевода с другого языка.
Разные размеры для разных потребностей:
BİLGE – это не одна модель, это семья. С 1B, предназначенным для мобильных и конечных устройств, баланс производительности и эффективности был обучен с 9B до нуля. BİLGE 27B был разработан методом непрерывного предварительного обучения с турецкими данными. Разработанный для сложных логических задач, BİLGE 122B все еще находится в стадии разработки.
Devasa English Korpus:
Обучение началось с около 1 трлн словарного запаса сырых турецких данных. Из этого пула было выбрано 250 миллиардов высококачественных токенов, а данные были обогащены 500 миллиардами синтетических данных. Цель состоит в том, чтобы понять идиомы, приложения и технические термины модели в турецком контексте.
Низкая энергия и стоимость:
Он нацелен на то, чтобы тратить меньше вычислительной мощности, потому что он использует токен, соответствующий турецкому. Государственные учреждения предназначены для корпоративных приложений, где безопасность данных имеет решающее значение.
Статус доступа: По состоянию на 14.10.2026, BİLGE не открыт для общего использования. Для пилотных проектов по данным официального сайта можно связаться с TUBITAK TICKET. Объявления, связанные с доступом, были объявлены только с официальных каналов TÜBİTAK с Министерством промышленности и технологий.
2.2 Kumru AI: быстрый, сфокусированный и легкий
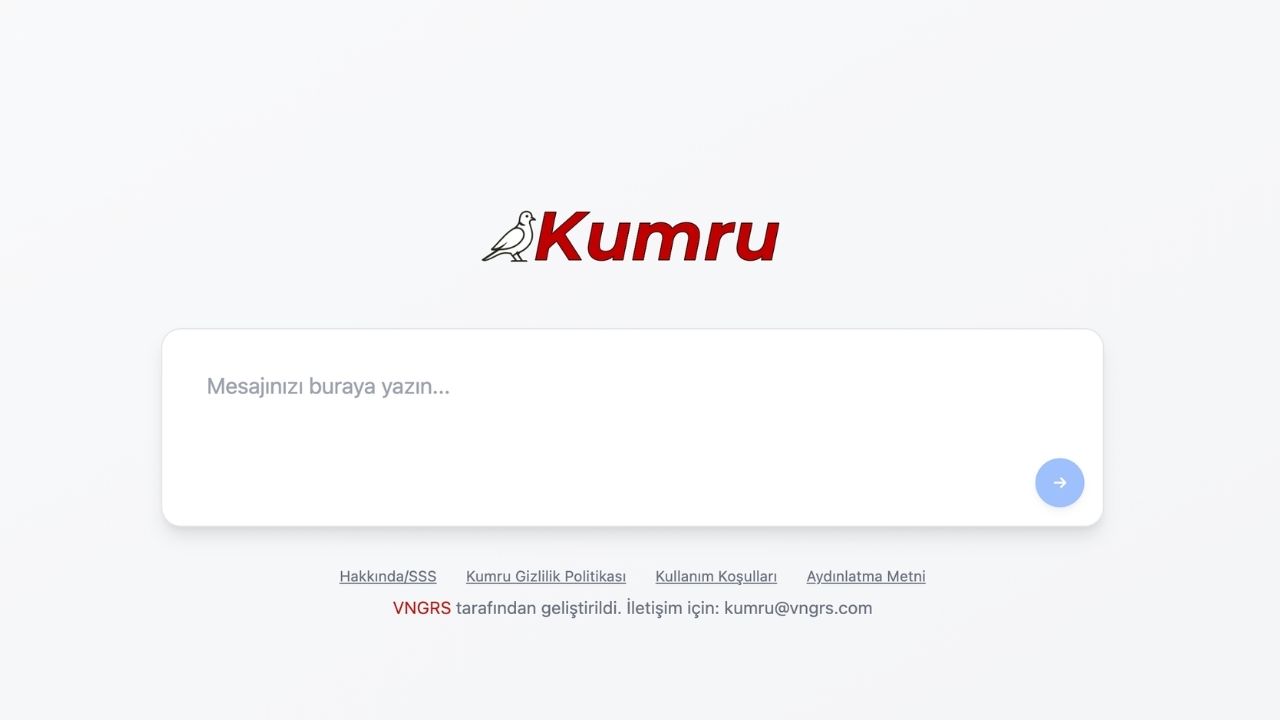
В мире венчурного бизнеса модели сосредотачиваются на функциональности, а не вступают в огромную гонку параметров. из Кумру Ай, Турецкая альтернатива LLM, которая позволяет компаниям работать на своих серверах, не тратя огромные бюджеты.
Абстракция текста, категоризация требований клиентов и налаживание естественного турецкого диалога Очень успешная модельОбеспечивает высокую скорость отвлечения без удаления аппаратных ресурсов.
VNGRS с нуля тренирует для турецкого Kumru 7,4 млрд параметров и может работать на GPU с 16 ГБ VRAM. Домой На нем можно попробовать демоверсию; 2 миллиарда параметров Kumru-2B открыты с лицензией Apache 2.0 на Hugging Face. Технические детали и ограничения Kumru AI Guide Новости Видишь.
3.T3 AI: Open Source и Community Power
T3 AI, разработанный в бизнес-ассоциации Baykar совместно с турецким фондом Technology Team Foundation (T3 Foundation), представляет масштабы работы сообщества. В Модели 11.07.2025 ТЕКНОФЕСТ открыт для использования с бета-версией в Социальной платформе. В ходе объявления было объявлено о вкладе в проект 1792 добровольцев из 67 провинций.
В проекте говорится, что он был разработан с открытым исходным кодом, но количество параметров и весов модели еще не были распределены. Если весы открыты, можно легко обучить специальные модели в таких областях, как юриспруденция или медицина.
4. Академические инициативы в области позвоночника и наружного веса
Экосистема в Турции не ограничивается тремя названиями:
Trendyol LLM:
Первая версия Trendyol LLM (2024) была обучена 10 миллиардам токенов на модели Meta LLaMA 2 7B. Следующие версии прошли Qwen 2.5 7B, Qwen 3 8B и Gemma 3 12B. Trendyol-LLM-Asure-12B, представленный в феврале 2026 года, также может работать и ставить перед электронной коммерцией задачи, такие как абстрагирование, вопрос-сэвап. Модели в основном используются на обнимающем лице.
Турана:
TURNA, разработанная TABILab на факультете компьютерной инженерии Университета Богазичи, представляет собой кодер параметров 1,1 миллиарда на основе UL2-кадра, турецкой языковой модели. Предназначен для понимания и генерации текста, а также для некоммерческих академических исследований объятий лица.
Zemberek Heritage:
Open Source английская библиотека обработки естественного языка ДомойОдин из инструментов, который уже много лет применяется в базовых работах, таких как корневое решение.
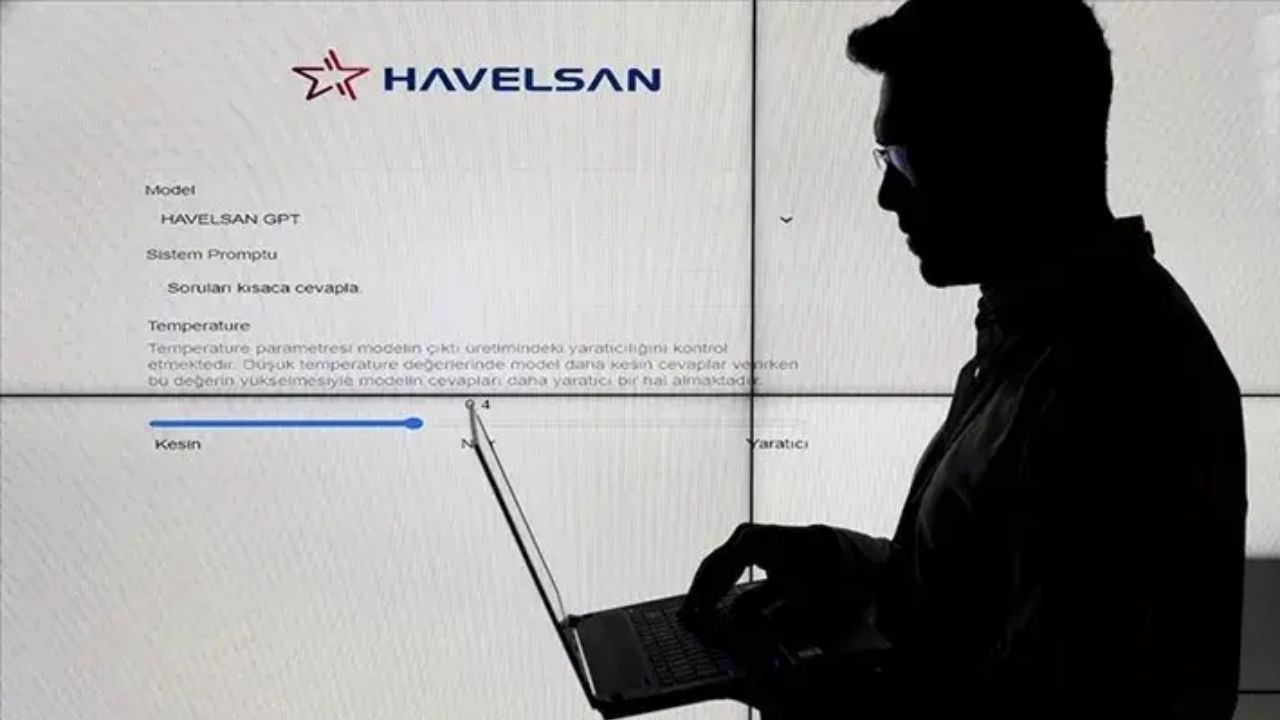
5. MAIN GPT (HAVELSAN): Нативный мозг обороны и корпоративной безопасности
Одним из наиболее важных шагов в области ИИ является оборонная промышленность и общественная безопасность. Разработан для защиты внутренней безопасности данных и высоких стандартов конфиденциальности HAVELSAN Гавелсан ГПТ Он выделяется как одна из корпоративных инфраструктур ИИ, которые могут работать за пределами Турции.
Корень (Multi Artificial Intelligence Network), продвигаемый в 01.02.2024 HAVELSAN, является платформой, где учреждения могут создать помощника искусственного интеллекта на основе своих данных. Закрытая цепь предназначена для работы; цель не оставляет данные за пределами учреждения. На первом этапе текстовые работы; абстрагирование контента способно обрабатывать информацию из открытых исходных данных и написания кода.
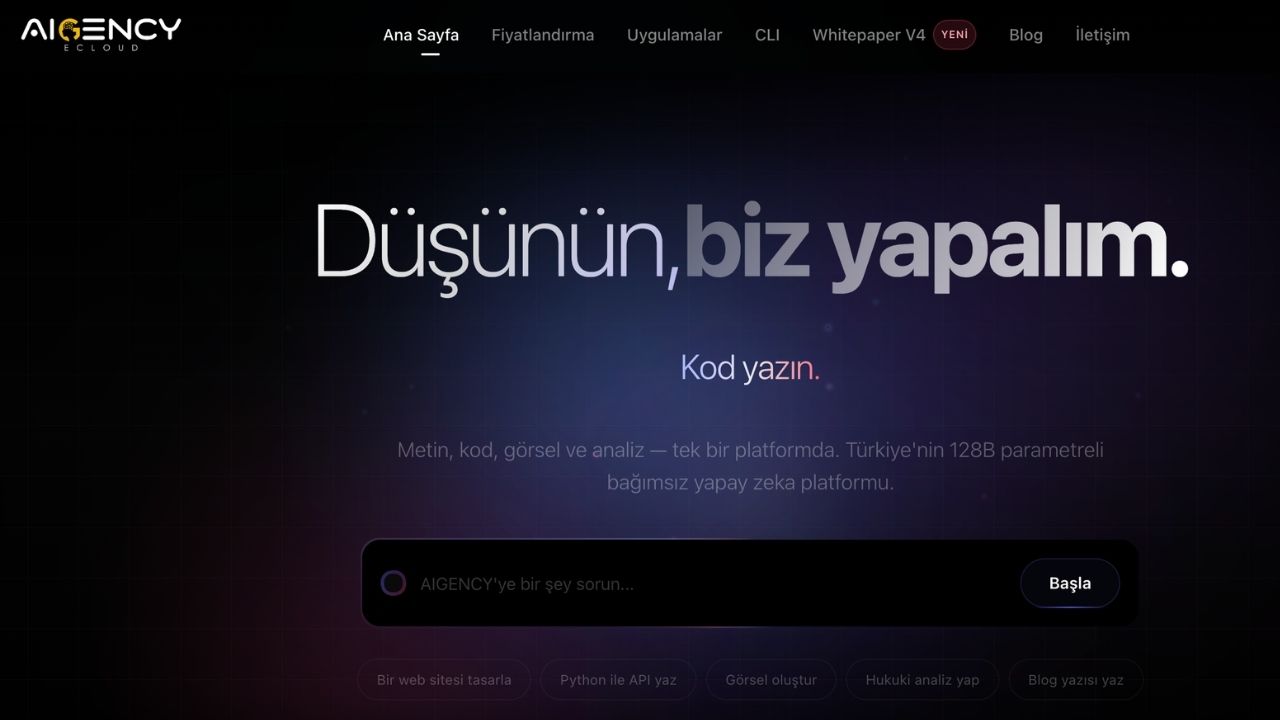
6. Aigency: Early-Term Turkish Language Model Initiative Home
Компания eCloud Software Technologies начала разработку в 2022 году АгентствоЭто одна из первых моделей государственного языка в Турции. Согласно новостям местной прессы, LLaMA от Meta основана на 3 моделях и фокусируется на производстве текстов, контент-анализе и корпоративных коммуникационных процессах. Независимая оценка модели пока не опубликована.
Обзор моделей:
Домой | разработчик | Масштаб/подход | Основной фокус | Самый большой плюс |
|---|---|---|---|---|
Новости | Тубитак | 1В, 9В, 27В (122В разработан) | Общественное, корпоративное, цифровое доминирование | 1 трилион словосырье пул данных, отечественный алтыап |
Kumru AI | ВНГРС | 7,4B с нуля; 2B открыто | Внутренняя (B2B) обработка документов |
Низкая стоимость сервера, быстрое время отклика
T3 AI AI
Фонд T3 и Baykar
Количество параметров не раскрывается
Турецкий LLM
Набор данных добровольцев, цель экосистемы с открытым исходным кодом
Трендиол LLM
Техника Trendyol
7B - 12B наружный вес
Электронная коммерция и диалог с клиентами
Интеграция в практические сценарии
Home GPT
Домой
Корпоративная и изолированная модель языка
Защита, общественная и корпоративная безопасность данных
Закрытая схема (на месте)
Агентство
Программное обеспечение eCloud
Ранняя стадия языковой архитектуры
Текстовое производство и корпоративные коммуникации
Ранняя инициатива, направленная на создание турецкого текста
Почему это важно для разработчиков и компаний?
Выбор модели родного языка — это не только идея «поддерживаем наземные технологии»; непосредственное размещение преимуществ компаний, заинтересованных в своих карманных и юридических процессах:
KVKK и безопасность данных:
Серьезная головная боль из-за регулирования банка, больницы или сайта электронной коммерции для получения пользовательских данных и отправки их на API за границу. Локальные модели не выводят данные из учреждения, поскольку они могут работать непосредственно на своем сервере.
Меньше оборудования, больше скорости:
Вместо сотен миллиардов параметров объемных моделей вы можете легко работать на одном GPU среднего сегмента, компактной модели 7B или 14B, обученной для конкретной работы. Вот почему затраты на сервер и электроэнергию серьезно снизились.
Вырвать зависимость:
Глобальные компании искусственного интеллекта могут удвоить цены на API за ночь или ограничить доступ к вашему бизнесу. Весы на открытом воздухе Обнимающее лицо Нативные модели, которые можно загрузить с таких платформ, позволяют полностью контролировать архитектуру программного обеспечения.
С открытием национальных суперкомпьютерных ресурсов, таких как TRUBA и проведением программного обеспечения, приобретенного в оборонной промышленности (ASELSAN, HAVELSAN), производство искусственного интеллекта в Турции быстро распространяется на базу. Теперь дело не только в печати текста, а в создании автономных систем, которые действительно понимают нашу родную культуру и язык. Родные модели также полностью проталкивают позвоночник этой независимости.
Написание будущего с помощью собственного кода
Гонка искусственного интеллекта теперь измеряется не только тем, кто имеет большую серверную ферму, но и тем, насколько реалистично она затрагивает местные потребности этой технологии. Модели, разработанные в Турции, вместо копирования готовых форм помещаются в линию, которая давит еще на многие ноги, уделяя особое внимание решению тонкостей турок, обеспечению безопасности данных и снижению операционных расходов компаний. Этот момент, исходя из корпоративной мощи TICGE, Kumru AI и T3 AI, показывает, что независимая технологическая инфраструктура, которая мыслит и производит на своем собственном языке, больше не привлекательна, а осязаемая реальность. Чтобы построить будущее с помощью собственных кодов, а не алгоритмов других, мы можем сделать самый важный шаг в цифровую эпоху.
Некоторые компании, стоящие за этими моделями Турецкие ИИ-компании выделяются в 2026 году Мы попали в статью. Для технических деталей Кумру Руководство Kumru AI Люди, работающие над моделями турецкого языка Маскотские общины Вы можете встретиться.
АвторDario Amodei'den Yapay Zeka Uyarısı: Sektör Yalan Söyledi
Gemini Ücretli mi? Ücretsiz Sürüm ve Tüm Planlar (2026)