Что такое генеративный ИИ? Принцип работы и типы моделей
Переведено автоматически
 Creator
Генерирующий ИИЭто своего рода искусственный интеллект, который создает новый контент (текст, визуальный, аудио, видео или код), который напоминает формы, которые учатся на больших наборах данных. Классический искусственный интеллект часто классифицирует или предсказывает ценность; продуктивный искусственный интеллект создает новый результат. Сегодня наиболее используемыми типами являются большие языковые модели (LLM), диффузионные модели, GAN и VAE.
Последнее обновление: 18.10.2026
ELIZA была опубликована в 1966 году с первых чат-программ, но она работала с готовыми правилами. Asıl leap VAE (2013), GAN (2014), поставляется с трансформаторной архитектурой (2017) и диффузионными моделями. Идея диффузии была рекомендована в 2015 году, широко распространена при работе DDPM в 2020 году. Эта технология используется во многих работах из учебного контента; такие риски, как подделка, авторское право, предвзятость и подгонка моделей (галюзинация), все еще находятся на повестке дня.
Что же представляет собой этот генеративный ИИ? Как это работает и каковы модели? Вот, подробности:
Что такое генеративный ИИ?
Генеративный искусственный интеллект — это область ИИ, которая фокусируется на создании алгоритмов и моделей, которые могут создавать новые и реалистичные данные, напоминающие шаблоны в наборе образовательных данных. Проще говоря, генеративный ИИ относится к классу систем ИИ, которые производят совершенно новые данные. Эти системы или модели обучены учиться на больших наборах данных и создавать что-то совершенно новое на основе этой информации. Так, используется термин «генеративный» (производимый).
Генеративный ИИ имеет множество применений в искусстве, синтезе изображений, производстве естественного языка, музыкальной композиции, кодировании и многих других областях. Большинство традиционных типов искусственного интеллекта предназначены для классификации существующих данных или категоризации, целью генеративных моделей ИИ является создание полностью оригинальных работ, которые никогда не были замечены ранее.
Дискриминационный ИИ (постоянный искусственный интеллект) и генеративные различия ИИ
Понимание различий между дискриминационным ИИ (постоянным искусственным интеллектом) и генеративным ИИ (искусственный интеллект производителя) помогает нам лучше понять различные приложения искусственного интеллекта.
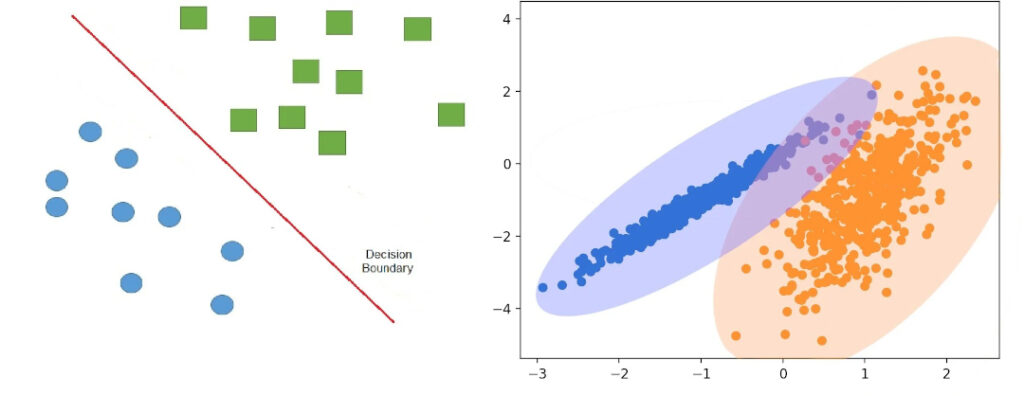
Дискриминационный ИИ Модель HomeОни обучены распознавать шаблоны в наборах данных и прогнозировать или классифицировать новые примеры с использованием этих шаблонов. Например, модель дискриминаторного ИИ, обученная на наборе данных, содержащем изображения кошек или собак, может классифицировать новые изображения как кошек или собак на основе шаблонов, которые они изучают из входных данных. Такие модели часто обучаются с использованием методов наблюдения и очень эффективны для конкретных задач. Они в основном используются для решения конкретных задач, таких как классификация или прогнозирование.
Генерирующий ИИ Если он предназначен для изучения базовых шаблонов в наборах данных и получения информации, аналогичной исходному набору данных, но не полностью тем же новым примерам. Например, производитель, обученный алгоритму AI, может создавать новые изображения кошек, которые выглядят аналогично исходному набору данных, но без полных копий. При создании моделей в основном учатся на немаркированных данных, самоконтролируемых (самоконтролируемых) методах; например, языковая модель обучается путем прогнозирования следующей части в тексте. Чат-помощники прекрасно адаптируются к человеческой обратной связи. Это делает искусственный интеллект особенно полезным в приложениях, где настроенные или регулируемые данные трудно напугать или получить.
Алгоритмы машинного обучения слеженияИспользуется, когда помеченные данные недоступны. Вместо этого алгоритм задается рядом неструктурированных наборов данных. Алгоритм рассматривает неструктурированные данные и пытается идентифицировать шаблоны и структуры независимо без каких-либо инструкций или предварительных знаний. Кластеризация и обнаружение аномалий являются примерами неконтролируемых методов обучения.
Полупересмотренные алгоритмы машинного обученияКогда есть некоторые маркированные данные, доступные для обучения, но они используются, когда их недостаточно для обучения полной модели. Алгоритм определяет шаблоны и структуры в данных, используя помеченные данные с немаркированными данными. Полунаблюдение можно рассматривать как гибридный подход между наблюдением и неконтролируемыми методами обучения.
Как правило, иммигрирующий ИИ развивает способность производить более широкое понимание и новые образцы данных, одновременно обучаясь решению конкретной проблемы. Понимание этих двух типов ИИ помогает нам определить, какие ситуации и как их можно эффективно использовать.
Основное различие между искусственным интеллектом и классическим искусственным интеллектом
Основное различие заключается в том, что классическая модель (сектор) дает вам тег, оценку или прогноз; продуктивная модель создает новый контент. Таблица ниже суммирует разницу.
Особенность | Классический (также) искусственный интеллект | Искусственный интеллект (Generative AI) |
|---|---|---|
Что это? | Классифицирует данные, оценки, оценки | Создание нового контента, который напоминает данные |
выход | Тег, вероятность, число (например, "спам" или "спам") | Текст, визуальный, аудио, видео, код |
Выборочные задания | Спам-фильтр, оценка кредитного риска, предложение продукта, прогнозирование ошибок | Чат, текстовое письмо, визуальная и видео генерация, написание кода |
Системы выборки | Фильтры электронной почты, двигатели рекомендаций, классификаторы | ChatGPT, Gemini, Claude, Midjourney, Stable Diffusion |
Короче говоря, когда вы говорите «генерирующий искусственный интеллект», вы можете думать о системах, которые решают или предсказывают, но не производят новый контент.
Генеративный принцип работы ИИ
Генеративный ИИ можно рассматривать как версию ИИ, которая имитирует творческие процессы человеческого мозга. В этой области, используя различные методы, такие как нервные сети и алгоритмы глубокого обучения, можно выявить определенные закономерности и получить на их основе новые результаты.
Процесс обучения генеративного ИИ обычно начинается с большого набора данных. Этот набор данных может содержать примеры, такие как изображения, текст, аудио или видео. Модель пытается выяснить основные правила, которыми управляет контент, анализируя закономерности и отношения во входных данных. Затем мы производим новые данные, извлекая примеры из распределения возможностей, которые вы изучаете. Он постоянно пытается максимизировать потенциал для получения правильного результата, корректируя его параметры.
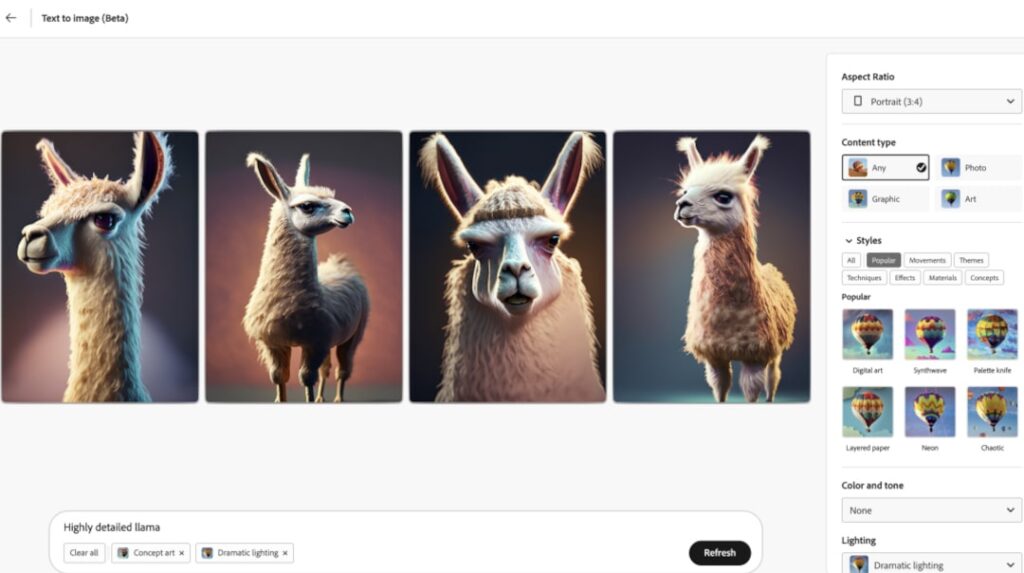
Например, генеративная модель, обученная на наборе данных, состоящем из изображений ламы, может создавать новые изображения ламы, выделяя примеры из изученного распределения, а затем уточняя выход с помощью процесса, называемого «бумагой». Во время удаления лучше настраивает вывод модели на желаемый вывод или исправляет любую ошибку. Это гарантирует, что генерируемый результат более реалистичный и лучше соответствует тому, что хочет видеть пользователь.
Генеративный ИИ может революционизировать производство творческого контента. Используя искусство, музыку, литературу и даже научные открытия, он может открыть двери для инноваций. Работа в этой области позволяет ИИ превратиться в технологию, которая может быть только аналитическим инструментом, имитировать человеческое творчество или даже поддерживать.
Что такое генеративные модели ИИ?
Генеративные модели ИИ — не единственный тип. Сегодня этот тип искусственного интеллекта был запущен в качестве различных моделей различными компаниями искусственного интеллекта. Вот наиболее известные из этого типа:
Тип модели | Как это работает? | сильный | Известные примеры |
|---|---|---|---|
Ган (2014) | Сепаратор с генератором обучают друг против друга | Быстрое и четкое визуальное производство в один шаг | StyleGAN, CycleGAN |
Верхний ящик | Сжимает данные из скрытого пространства, регенерирует оттуда | Контролируемая вариация, сжатие | Изображение шифровальщика на Stable Diffusion |
Fusion (2015, 2020) | Он создает визуальные эффекты, очищая шум шаг за шагом. | Высокое визуальное качество, текстовое руководство | DALL·E 2, Stable Diffusion |
Трансформер на основе LLM (2017) | Он создает текст, предсказывая следующую часть (токен). | Текст, код, чат, многоязычное использование m | GPT, Gemini, Llama |
Поток на основе (Glow, 2018) | Использует обратные конверсии | Полный расчет потенциала | Glow; Stable Diffusion 3 с соответствием потока |
Генеративные состязательные сети (GAN)
Генеративные состязательные сети (GAN) — это модель искусственного интеллекта, состоящая из двух нервных сетей: генератора и сепаратора. Например, когда вас просят создать изображения кошек, генератор создает новое изображение кошек, используя случайный вектор ввода.
Сначала эти фотографии могут быть простыми, но со временем они становятся реалистичными. Сепаратор работает, чтобы классифицировать реальные или поддельные фотографии, делая как настоящие фотографии кошек, так и поддельные фотографии.
Обе сети непрерывно развиваются, конкурируя друг с другом: делают сепаратор лучшей классификацией, генератор учится создавать более непроводящие картинки. Эта конкурентная структура вызвала использование «противоборствующего» выражения, называемого моделью.
Процесс обучения GAN
Процесс обучения GAN (Generative Adversarial Networks-produced Traction Networks) является довольно интересным и инновационным подходом. Этот процесс состоит из следующих этапов:
Начало теговГенератор (генератор) и различающий (дискриминатор) запускаются со случайными весами. Основная идея заключается в том, что две сети конкурируют друг с другом.
Учебный циклГенератор обучен сочетанию отличительных реальных и поддельных данных при создании сообществ поддельных данных. Колыбель дает оценку вероятности между 0 и 1, указав, являются ли входные данные реальными или поддельными.
Обратное распространение ()ДомойСигнал ошибки от затвора распространяется обратно, чтобы обновить вес сети. Затем генератор также обучают с помощью сигнала неисправности от различающего и обновляют его вес.
отбор пробПосле обучения модели генератор может производить новые образцы данных из изученного распределения.
GAN используются для различных приложений, таких как создание реалистичных изображений, видео и разговоров. Одним из преимуществ GAN является то, что они могут производить высококачественные и разнообразные примеры благодаря своей способности изучать сложные и многорежимные дистрибутивы.
Тем не менее, обучение GAN может быть затруднено, и они могут страдать от таких проблем, как коллапс мода, здесь генератор производит ограниченные и повторяющиеся примеры. Для решения этих проблем были рекомендованы различные модификации и улучшения, такие как Wasserstein GANs и StyleGANs.
Области применения GAN
GAN (Generative Adversarial Networks) - это технология искусственного интеллекта, состоящая из двух сетей, позволяющая создавать инновационные приложения в различных областях. Это:
Изображение и видеопроизводство / манипулирование: Дисплеи и глубокие подделки (глубокие подделки).
Передача стилей и видео с перевода изображений: конвертировать изображения, применяя различные стили.
Восстановление и синтетика данных: используется для повышения эффективности моделей контролируемого обучения.
Синтез и подзаголовок изображения из текста: визуализируйте письменный текст или добавьте субтитры к изображениям.
Производство и дизайн 3D объектов: создание реалистичных аватаров и виртуальных сред.
Звуковая трансформация и звуковой синтез: звук и музыкальное производство.
Разработка игр и дизайн: создание новых уровней и персонажей.
Творческие приложения: искусство, музыка, производство литературы.
Безопасность и конфиденциальность: генерация поддельных данных и глубокое обнаружение подделок.
Научные исследования и моделирование: моделируют сложные системы и делают научные прогнозы.
CycleGAN является примером GAN, используемым для перевода с изображения на изображение и может преобразовывать изображения без непревзойденных данных обучения. Эффективность GAN зависит от качества образовательных данных, сложности базового распределения и таких факторов, как архитектура модели.
Переменные автоматические кодеры (VAE)
Переменные автоматические кодеры (VAE) — это регенеративные модели, используемые в области искусственного интеллекта. Эти модели могут создавать новые выходы, похожие на наборы данных, особенно они эффективны в изучении правильных вариаций определенных направлений в данных. VAE работают через две сети нервов, которые включают кодер и растворитель для получения изображения.
Кодер преобразует изображение в малогабаритное представление, называемое «скрытым пространством», и создает новое изображение, похожее на оригинал, используя это представление растворителя. Отличительной особенностью VAE является то, что он использует исключительные модели для изучения распределения, лежащего в основе образовательных данных. Таким образом, они могут лучше улавливать неопределенность и переменные в данных. VAE обладает большим потенциалом для инновационных приложений в таких областях, как изобразительное искусство и моделирование данных.
Процесс обучения VAE
Переменные автоматические кодеры (VAE) являются широко используемым методом в машинном обучении и особенно эффективны в таких приложениях, как генерация данных, сжатие, удаление шума и извлечение свойств. Процесс обучения VAE состоит из следующих шагов:
Кодирование (Encoding): Входные данные подаются в сеть кодеров (encoder). Эта сеть сжимает данные в «латентное» пространство меньшего размера. Это скрытое пространство основано на предположении Гаусса о распределении.
Выборка (Sampling): случайное пятно в скрытом пространстве из гауссовского распределения.
Решение кода (декодирование): Сеть растворителей кода (декодер), берет выбранную точку и преобразует ее в новую точку данных. Растворитель кода обучается реконфигурировать исходные входные данные с использованием скрытого представления пространства.
Функция потерь для VAEs состоит из потери реструктуризации и потери KL-дивергенции (отклонение Headback-Leibler). Реструктуризация потерь измеряет, насколько хорошо растворитель кода может реструктурировать исходные входные данные. С другой стороны, потеря KL-дивергенции измеряет разницу между распределением изученного секретного пространства.
Обратное распространение (backpropagation): Сигнал ошибки от потерянной функции распространяется обратно по сети для обновления весов как кодера, так и декодера.
После завершения обучения VAE может производить новые данные путем отбора проб из распределения изученного секретного пространства. VAE также могут использоваться в других приложениях, таких как сжатие данных, удаление шума и удаление свойств. Например, приложение для удаления шума изображения может быть выполнено с помощью автоматических кодеров.
Области применения VAE
Variable Automatic Encoders (VAEs) - это технология на основе искусственных нервных сетей, которая занимает важное место в области искусственного интеллекта и машинного обучения. Эта технология используется во многих областях, особенно для генерации данных и манипулирования ими. Вот некоторые из областей применения VAE:
Производство изображений и манипуляция: VAE могут создавать новые и реалистичные изображения или изменять существующие изображения. Это предлагает новое творчество в области искусства и дизайна.
Видеопроизводство и прогноз: VAE можно использовать для создания видеоконтента и прогнозирования будущих квадратов.
Сжатие данных и удаление шума: VAE довольно эффективны в снижении данных от сжатия и шума, поэтому требуют меньше места для хранения и повышают качество данных.
Значение обнаружения и раскопки аномалий: VAE могут использоваться для обнаружения ненормальных или незаконных предметов в наборах данных и их удаления.
Система рекомендаций и персонализация: использует VAE для предоставления персонализированного контента и рекомендаций по продукту в соответствии с личными предпочтениями.
Извлечение и представление функций: VAE используются для изучения более значимых и полезных представлений данных.
Создание реалистичных 3D-моделей и сред: VAE можно использовать для создания 3D-моделей и виртуальных сред, которые напоминают реальный мир.
Обработка естественного языка: VAE играют важную роль в обработке естественного языка, включая производство текста и машинный перевод.
Биомедицинский анализ данных и открытие лекарств: VAE используются при анализе биомедицинских данных и открытии новых фармацевтических кандидатов.
Моделирование и прогнозирование в физике и других науках: VAE используются для моделирования и прогнозирования в различных областях науки.
Диффузионные модели
Диффузионные модели приходят к нам как инновационный шаг в области искусственного интеллекта. Эти модели добавляют шум к основным данным для получения высококачественных синтетических данных и обучения путем удаления этого шума. Благодаря процессу извлечения шума модели диффузии позволяют лучше понять структуру данных.
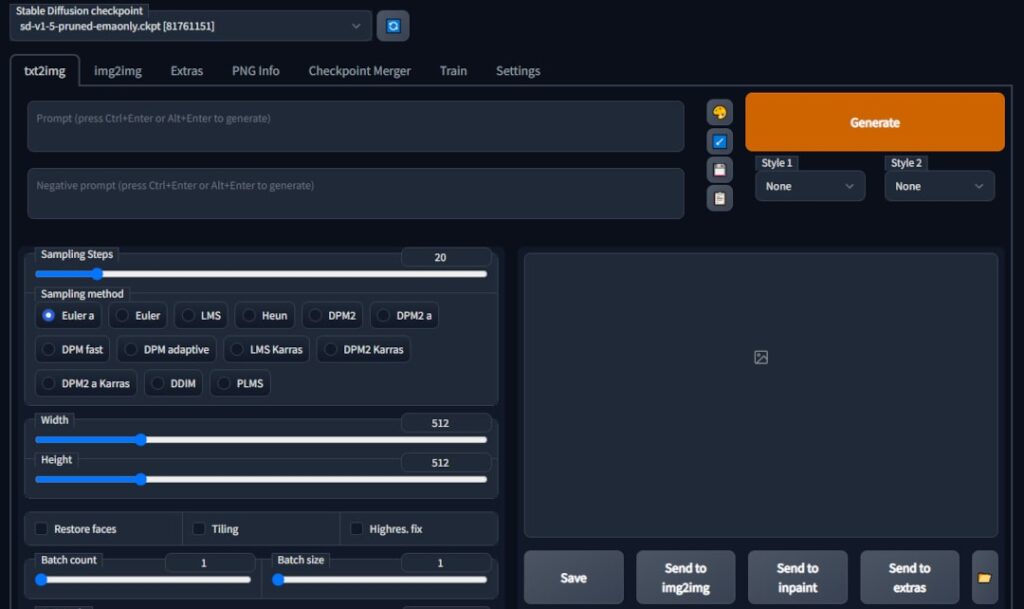
Bu modeller özellikle görüntü oluşturmada başarılıdır. Eğitimde model, veriye eklenen gürültüyü tahmin etmeyi öğrenir; bu basit hedef, GAN'lardaki iki ağlı rekabete göre eğitimi daha kararlı hale getirir. Bedeli, üretimin çok adımlı olması nedeniyle daha yavaş çalışmasıdır. OpenAI'nin DALL·E 2 modeli (2022) ve görüntüyü önce sıkıştırılmış bir gizli uzayda işleyen Stable Diffusion (latent diffusion), metinden görsel üreten difüzyon modellerine örnektir. İlk DALL·E (2021) ise difüzyon değil, otoregresif bir transformer modeliydi.
Другие генеративные модели ИИ
Мы видели, что генеративные ИИ в основном делятся на 3 различные модели. Но также доступны более инновационные и экспериментальные модели искусственного интеллекта. Эти модели подробно перечислены ниже.
Автогрезифицированные модели
Модели Autoregresif — это возможности прогностических моделей, основанных на предыдущих элементах, каждый из которых производит массив данных в свою очередь. В области обработки естественного языка (NLP) они часто используются в таких задачах, как производство текста и перевод языка. Эти модели предсказывают следующее значение, рассматривая предыдущие значения в числе. Например, можно предсказать цену следующего дня на основе цен предыдущих дней в анализе временных рядов цен на акции.
Большие языковые модели (LLM), используя такие автогрезифицированные модели, производят человекоподобные ответы на команды. Они обучаются на больших наборах текстовых данных, таких как книги, статьи и веб-сайты, и они предназначены для создания новых текстов в стиле и содержании, аналогичных фактическим данным. LLM получили успешные результаты на многих языках, таких как языковое моделирование, машинный перевод, задание вопросов и абстрагирование текста.
Это также важно в творческих работах, таких как высококачественные возможности генерации текста, помощники чата, набор кода, абстрагирование и сообщения в социальных сетях. Как тренировать LLMs Home Что такое модель большого языка (LLM), как получить образование? В нашей статье мы подробно объяснили.
Трансформаторные модели
Архитектура трансформатора была представлена в 2017 году в статье «Внимание — это все, что вам нужно» исследователей Google; сегодня на этой архитектуре установлены крупные языковые модели, такие как GPT, Gemini и Llama. Трансформатор — это своего рода нервная сетевая архитектура, основанная на собственном механизме внимания. Когда вводится вход, механизм позволяет модели назначать веса параллельно различным частям входного массива.
Затем модель определяет взаимосвязь между этими секциями и выдает соответствующий выход на специальный вход. Трансформаторы широко используются для задач НЛП, таких как перевод языка, производство и задание вопросов. Однако, если они специально не обучены создавать новый контент, их можно рассматривать не только как генеративные модели.
Модель на основе потока
Модели на основе потоков являются своего рода генеративными моделями ИИ и фокусируются на изучении организации данных в наборе данных. Эти модели работают путем понимания возможностей значений/событий в наборе данных и определения того, что часто происходит. При создании новых точек данных они защищают статистические свойства и характеристики существующих данных. Особенность этих моделей заключается в том, что применяемые ими существующие данные могут быть легко обращены вспять или обращены вспять путем «простого обратного преобразования».
Поскольку преобразование обратное, эти модели могут полностью вычислять возможность данных и могут производить образец из простого исходного распределения (например, случайный шум). Glow, выпущенный в 2018 году, является известным примером такого подхода. Недостатком является ограничение архитектуры требованием об изменении каждого слоя.
Идея потока сегодня возвращается по-разному: Stable Diffusion 3 была представлена в 2024 году как модель трансформатора, обученная методом сопоставления потока, называемым «отремонтированным потоком». Таким образом, диффузионные и потоковые подходы в современных визуальных моделях импортируются. Для деталей Stable Diffusion 3 Смотрите нашу статью.
Если вы хотите попробовать инструменты искусственного интеллекта при производстве Визуальное руководство по искусственному интеллекту с MidjourneyТэги Как использовать инструмент создания изображений с искусственным интеллектом DALL·E 2? и Создание визуального и видео с искусственным интеллектом Вы можете просматривать наши статьи. Для общего определения искусственного интеллекта Что такое искусственный интеллект? Наша статья - хорошее начало.
Часто задаваемые вопросы
Что означает генеративный ИИ?
Генеративный ИИ означает «естественный интеллект» на английском языке. Он рассказывает о новых текстовых, визуальных, аудио, видео или код-генерирующих системах искусственного интеллекта, которые напоминают данные, которые они изучают.
В чем основное различие между классическим искусственным интеллектом и генеративным ИИ?
Классический классифицирует или предсказывает данные, которые имеют искусственный интеллект; генеративный ИИ производит новый контент. Например, спам-фильтр «спам» теги, языковая модель, пишет вам новое электронное письмо.
Каковы примеры искусственного интеллекта без генерирующего ИИ?
Такие системы, как спам-фильтры, оценка кредитного риска, системы рекомендаций продукта, прогнозирование неисправностей и обнаружение объектов на изображении, являются примерами непрофессионального искусственного интеллекта. Они решают или предсказывают, не создают новый контент.
Что такое генеративные состязательные сети (GAN)?
GAN - это продуктивная модель, представленная в 2014 году и обученная двум нервным сетям. Генератор производит фальшивые примеры, сепаратор пытается отделить их от их истин, делая эту конкуренцию более реалистичной выходами.
ChatGPT является генеративным ИИ?
Да. ChatGPT является продуктивным приложением искусственного интеллекта, которое работает с крупными языковыми моделями, основанными на архитектуре трансформатора; он создает новый текст, предсказывая следующие части слова в соответствии с командой, которую вы даете.
CreatorMeta’nın Çığır Açan Yeni AI Uygulaması: Duygusal Anlamda İletişim!
GenAI: Çok Yönlü Yapay Zeka Platformunuz