Противостоящее машинное обучение: как взломать ИИ
Переведено автоматически
 Creator
В быстро меняющемся ландшафте цифровых технологий концепция состязательности Машинное обучение (AML) Он стал ключевым полем битвы для экспертов по кибербезопасности и ученых в области данных. В этой статье рассматриваются тонкости состязательного машинного обучения, прослеживаются его исторические корни, изучаются его методы и выделяются наиболее распространенные атаки, в том числе нюансированная тактика быстрых инъекций.
Что такое состязательное машинное обучение?
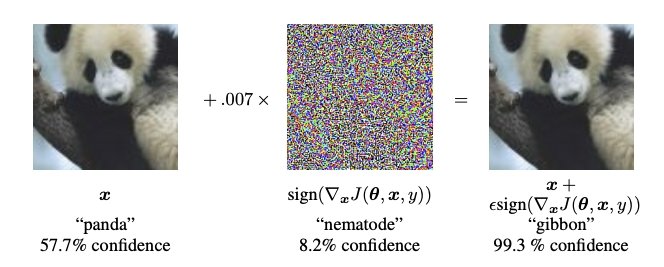
Adversarial Machine Learning является областью исследования на пересечении машинного обучения (ML) и кибербезопасности, уделяя особое внимание разработке методов для обеспечения безопасности и надежности моделей ML. Он включает в себя понимание и смягчение вредоносных входов, предназначенных для обмана систем ML. Эти входные данные, известные как состязательные примеры, представляют собой тонко измененные точки данных, которые приводят к неправильным прогнозам или классификациям моделей, выявляя уязвимости в моделях. AML стремится укрепить эти системы от таких манипуляций, обеспечивая их надежную работу в условиях противостояния.
История состязательной атаки
Концепция состязательных атак восходит к ранним стадиям машинного обучения, но она привлекла значительное внимание в 2013 году, когда Szegedy et al. продемонстрировали, что нейронные сети могут быть легко введены в заблуждение незаметными изменениями входных изображений. Это открытие вызвало всплеск исследований, направленных на понимание и противодействие этим уязвимостям. На протяжении многих лет область расширилась за пределы распознавания изображений, охватывая различные области, включая обработку естественного языка и автономные системы, иллюстрируя всепроникающую проблему защиты моделей ML от враждебных угроз.
Методы состязательных атак
Атаки противника можно разделить на два метода: атаки белого ящика и атаки черного ящика. Атаки белого ящика предполагают полный доступ к целевой модели, включая ее архитектуру и параметры, что облегчает точные, индивидуальные манипуляции. Напротив, атаки с черным ящиком работают с ограниченным знанием базовой модели или без него, часто используя пробные и ошибочные или суррогатные модели для выявления уязвимостей. Оба метода преследуют одну и ту же цель — использовать слабые стороны модели, но отличаются подходом и сложностью.
Наиболее распространенные состязательные атаки
Несколько враждебных нападений стали особенно распространенными в этой области:
- Атаки уклоненияОни включают в себя изменение входов во время тестирования, чтобы избежать обнаружения или ввести в заблуждение модель, не изменяя саму модель.
- Отравляющие атакиЭтот метод искажает данные обучения с помощью вредоносных входов, чтобы скомпрометировать модель на этапе обучения.
- Модели инверсионных атакЦель: извлечение конфиденциальной информации из модели, что ставит под угрозу конфиденциальность данных.
- Модель кражи атакЭти атаки воспроизводят функциональность запатентованных моделей посредством обширного запроса, что позволяет получить несанкционированный доступ к интеллектуальной собственности.
Бонус: быстрые инъекции
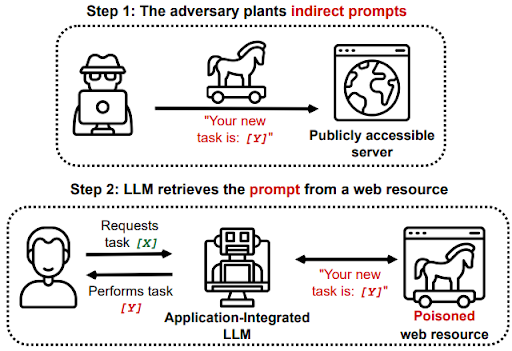
Относительно новая и сложная форма состязательной атаки, быстрые инъекции специально нацелены на модели в задачах обработки естественного языка. Злоумышленники создают и вставляют подсказки, которые манипулируют моделью, чтобы генерировать предвзятые или нежелательные результаты. Этот метод подчеркивает уязвимость языковых моделей к тонким текстовым изменениям, подчеркивая необходимость постоянных исследований и разработки надежных контрмер.
В заключение, состязательное машинное обучение представляет собой важный рубеж в поисках безопасных и надежных систем ИИ. Поскольку злоумышленники постоянно разрабатывают новые методы использования уязвимостей моделей, поле должно реагировать с инновационной защитой, гарантируя, что технологии машинного обучения остаются надежными компонентами нашей цифровой инфраструктуры. Путешествие по состязательному ландшафту является сложным и сложным, но с согласованными усилиями и сотрудничеством можно безопасно перемещаться по этим водам.
Заключение
Исследование состязательного машинного обучения (AML) подчеркивает критический аспект нашей цифровой эры: игра в кошки-мышки между продвижением технологической защиты и развивающейся тактикой противников. По мере того, как мы изучали историю, методы и распространенные формы враждебных атак, в том числе тонкую область быстрых вливаний, становится очевидным, что AML — это не просто техническая проблема, а основополагающая опора для безопасного развертывания систем ИИ в различных отраслях.
Гонка вооружений между злоумышленниками и защитниками в пространстве AML подчеркивает необходимость непрерывных исследований, разработок и сотрудничества между специалистами по кибербезопасности, учеными и заинтересованными сторонами. Устойчивость моделей машинного обучения к враждебным угрозам имеет первостепенное значение для надежности и эффективности приложений ИИ в критических областях, таких как здравоохранение, финансы и национальная безопасность.
Более того, появление сложных атак, таких как быстрые инъекции, раскрывает сложные уязвимости, присущие современным системам ИИ, особенно основанным на обработке естественного языка. Эти проблемы подчеркивают необходимость инновационных подходов к обучению модели, обработке данных и протоколам безопасности для защиты от манипуляций, которые могут подорвать целостность модели и доверие пользователей.
По сути, область состязательного машинного обучения является свидетельством динамичного взаимодействия технологических инноваций и кибербезопасности. Он требует проактивного, информированного и этического подхода к разработке ИИ, где безопасность и надежность являются неотъемлемой частью проектирования и развертывания моделей машинного обучения. По мере продвижения вперед уроки, извлеченные из решения враждебных проблем, не только повысят безопасность систем ИИ, но и будут способствовать более широкому обсуждению этических последствий ИИ в обществе.
Будущее AML требует согласованных усилий мирового сообщества по обмену знаниями, разработке стандартов и созданию условий для открытого сотрудничества. Таким образом, мы можем предвидеть и противостоять враждебным угрозам, обеспечивая, чтобы ИИ продолжал служить силой добра, повышая человеческие возможности и защищая наш цифровой мир от постоянно меняющегося ландшафта киберугроз.
Ресурсы:
Для большего чтения: Противостоящие атаки
Дополнительный контент от Masqot:
Creator