



DeepSeek V4: 1 миллион токенов и 1.6T Параметр!
Переведено автоматически
Китайская компания DeepSeekС моделью V4 1 миллион контекстов токенов и 1,6 триллиона параметров переопределили масштаб, эффективность и баланс затрат в искусственном интеллекте.
Что такое DeepSeek V4 и почему это важно?
Конкуренция в области искусственного интеллекта заключается не только в точности модели; в то время как длина контекста переопределяется с помощью таких параметров, как стоимость обработки и масштабируемость, модель DeepSeek V4, представленная DeepSeek, позиционируется как один из наиболее конкретных примеров этого преобразования. Вопрос «Что такое DeepSeek V4?» не только ограничен новым определением модели, но и относится к разрушению архитектуры техники больших языковых моделей (LLM). Мощность контекста в 1 миллион токенов, длительная обработка текста, анализ кода и радикальное расширение в многоступенчатых задачах рассуждения, шкала параметров 1,6 триллиона представляет собой новый порог, который достигает искусственный интеллект в вычислительной мощности.
Эта разработка позволяет обрабатывать больше информации за одну сессию в области финансов, права, разработки программного обеспечения и научных исследований, особенно в отраслях, требующих больших объемов данных. Процессы анализа, которые в традиционных моделях привязаны к пределу контекста, теперь могут непрерывно выполняться на гораздо более широких кластерах данных. Это означает не только повышение производительности, но и редизайн рабочих процессов.
Серия DeepSeek V4 означает не только масштабный рост, но и архитектурный редизайн. Семейство моделей, разработанных DeepSeek, представлено двумя различными структурами, включая DeepSeek-V4-Pro и DeepSeek-V4-Flash. Открытый исходный код в официальной коллекции Hugging Face Модель, выпущенная в качестве контекстного стандарта 1М, призвана сделать отрасль новой нормой.
1 миллион токенов искусственного интеллекта: Гранты
Вместимость 1 миллиона токенов, одна из самых замечательных инноваций DeepSeek V4, считается одним из самых больших технических скачков, когда-либо встречавшихся в моделях искусственного интеллекта. В то время как токен определяется как один из самых маленьких блоков, который может быть обработан из текста, это означает, что емкость достигает 1 миллиона; сотни документов страницы могут быть проанализированы за один раз больших баз кода или многослойных наборов данных.
Эта разработка создает серьезное преимущество, особенно в задачах, требующих длительного контекста. Например, анализ всего текста закона, такие процессы, как отладка в крупномасштабных программных проектах или обширное сравнение академических статей, теперь могут выполняться целиком, а не частично. Это в значительной степени устраняет проблему модели «световой непрерывности».
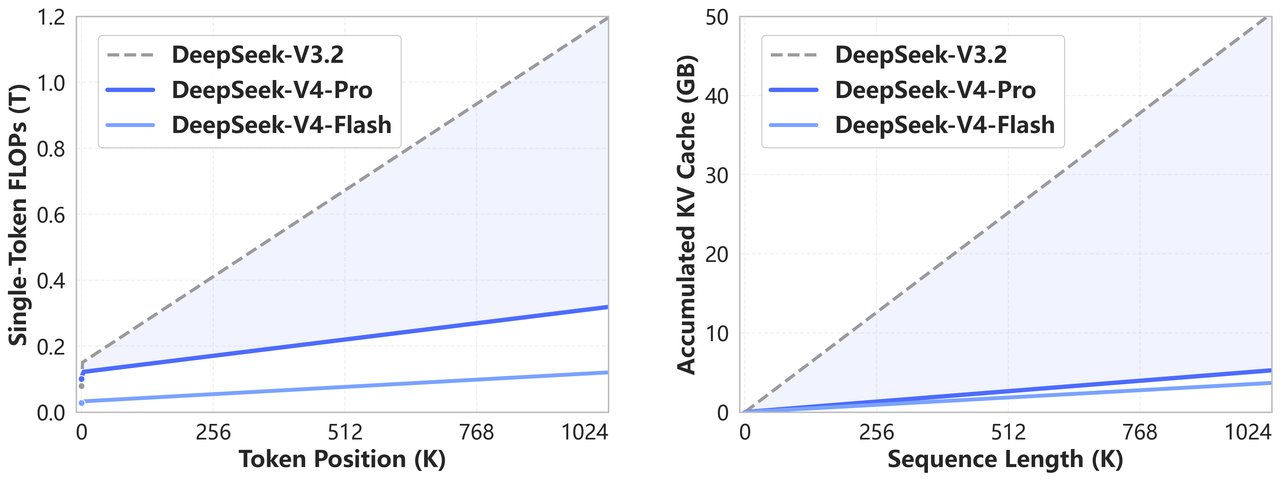
DeepSeek V4, Гибридная архитектура внимания Благодаря длительной обработке контекста, он обеспечивает серьезный прирост эффективности. Модель с комбинацией CSA и Heavily Attention Compressed (HCA) может работать с гораздо меньшими затратами на расчеты, чем предыдущие поколения. В частности, показано, что использование кэша KV в сценарии токена 1M значительно сокращается.
Архитектура экспертов: масштабируемый интеллектуальный подход
Архитектура Mixture of Experts (MoE), расположенная в техническом позвоночнике DeepSeek V4, выделяется как основной механизм, позволяющий модели эффективно работать, несмотря на большое количество параметров. Данная архитектура позволяет активировать всю модель только связанными «специальными» подсетями для определенных задач вместо запуска одновременно.
Такой подход дает серьезное преимущество в расчете по сравнению с классическими интенсивными моделями. Вместо того, чтобы использовать всю модель с 1,6 триллионами параметров, активируются только необходимые детали; как снижение стоимости обработки, так и оптимизация времени отклика. Эта ситуация особенно выделяется как критический фактор, который напрямую влияет на баланс затрат и производительности при использовании API.
Архитектура MoE также обеспечивает более высокие показатели точности, позволяя модели быть экспертами в различных типах задач. Это делает DeepSeek V4 не только большой, но и «умной» моделью.
Модели Pro и Flash в архитектуре DeepSeek V4 разделены на различные уровни активных параметров. DeepSeek-V4-Pro 1.6T работает с активным параметром 13B в общем параметре 49B, DeepSeek-V4-Flash 284B. Эта структура является главным преимуществом архитектуры МОС".Расчет столько, сколько требуется«реализует этот принцип непосредственно.
Структура Manifold-Constrained Hyper-Connections (mHC), расположенная в архитектуре DeepSeek V4, позволяет модели защищать мощность экспрессии при стабилизации потока информации между слоями. Кроме того, использование оптимизированного Muon обеспечивает более быструю конвергенцию и более стабильную динамику обучения в образовательном процессе.
Эффективность кэша KV: секретная сила длинных соединений
Другим элементом, который имеет решающее значение для практического использования емкости с длинным контекстом, является оптимизация кэша ключевых ценностей (KV Cache). КВ Эффективность кэша, разработанного в DeepSeek V4, значительно снижает нагрузку на обработку, позволяя модели использовать предыдущие токены без пересчета.
Это техническое улучшение напрямую влияет на производительность приложений, требующих длительного диалога и непрерывного потока данных. Например, система искусственного интеллекта с долгосрочным взаимодействием с пользователем может производить быстрые и последовательные ответы без необходимости перерабатывать всю историю в каждой новой записи.
Оптимизация кэша также играет важную роль с точки зрения энергоэффективности. Меньшая потребность в расчетах означает более низкое энергопотребление, что напрямую влияет на эксплуатационные расходы в крупных дата-центрах.
DeepSeek V4-Pro работает с примерно 10% использованием кэша KV в контекстном сценарии 1M по сравнению с DeepSeek-V3.2, вывод FLOPs также предлагает более эффективную структуру на уровне 27%. Эта оптимизация обеспечивает значительное увеличение производительности, особенно в длинных чатах и приложениях на основе агентов.
DeepSeek V4 Pro: производительность на корпоративном уровне
DeepSeek V4 Pro позиционируется как самая сильная версия семейства моделей и фокусируется на корпоративных сценариях использования. Расширенные возможности рассуждений, длительное управление контекстом и высокая точность делают эту версию идеальной для проектов, требующих большой обработки данных.
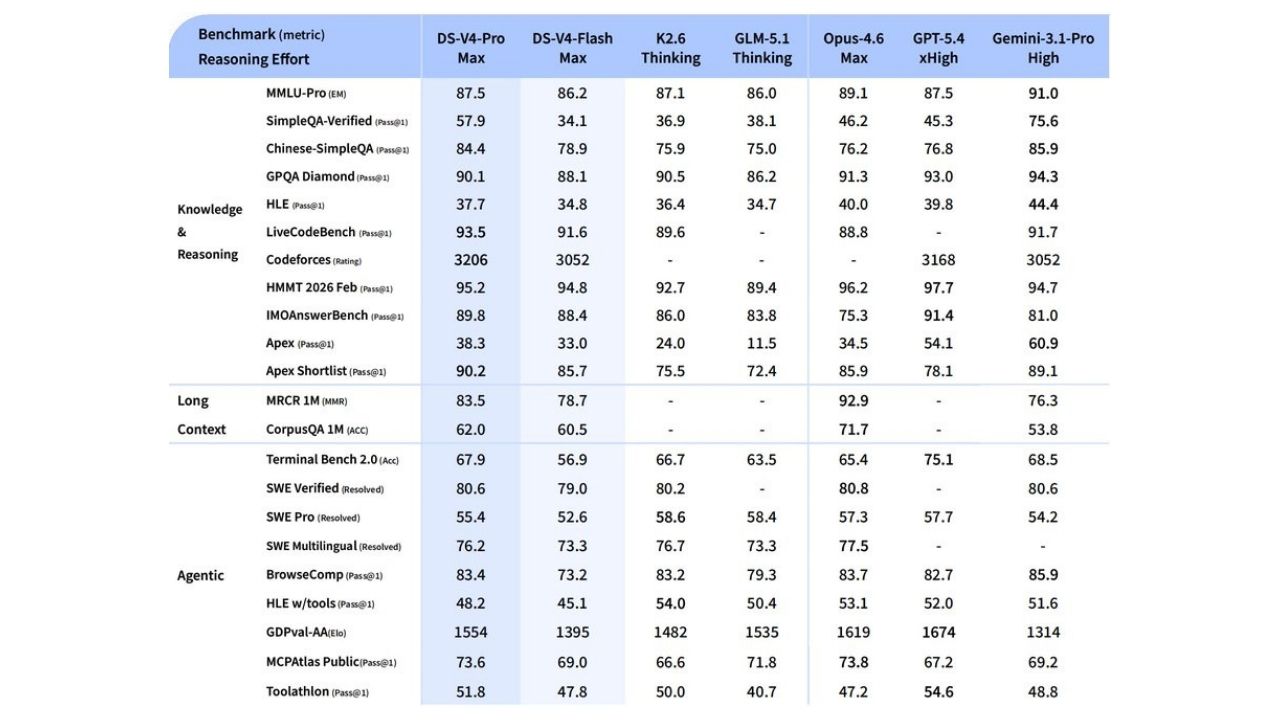
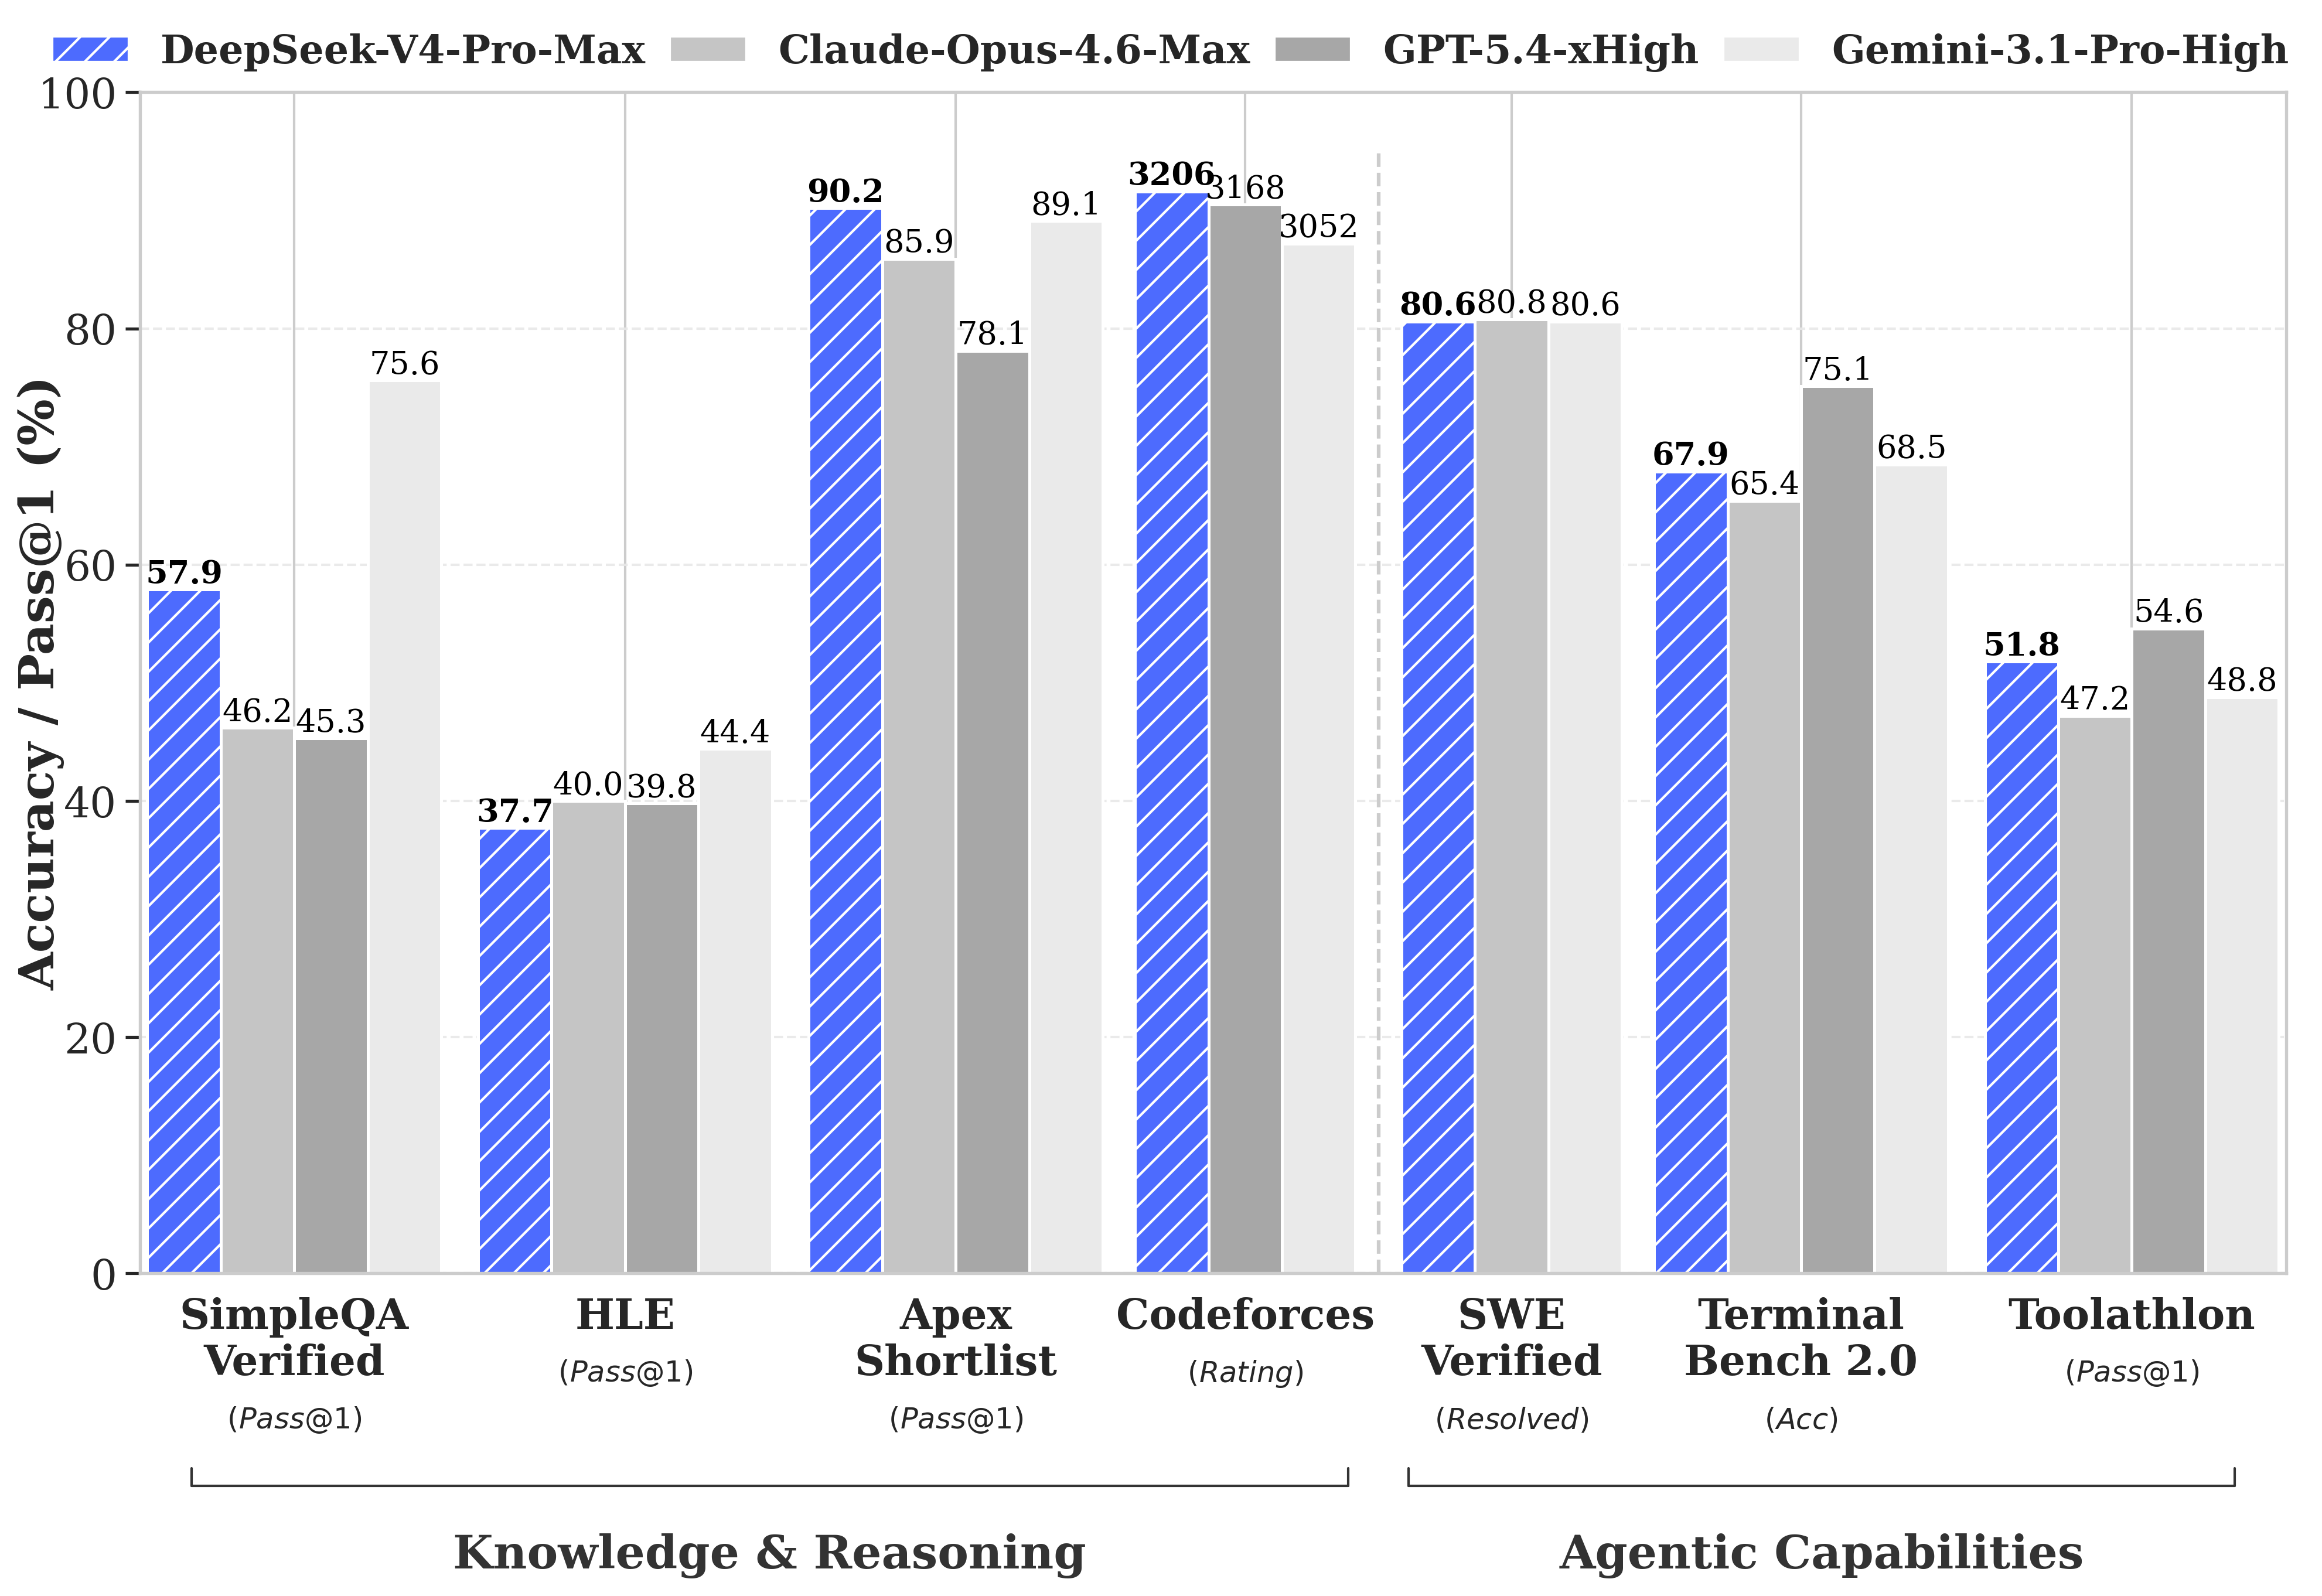
Одна из важнейших особенностей Pro-версии может дать более последовательные результаты в сложных задачах. Очень пошаговое решение задач, продвинутый уровень производства кода и аналитические задачи, производительность модели видна. Кроме того, благодаря гибкой структуре, предлагаемой через API, компании могут интегрировать модель в соответствии со своими потребностями.
DeepSeek V4 Flash vs Pro: производительность и баланс затрат
Версии Flash и Pro, входящие в семейство DeepSeek V4, предназначены для различных сценариев использования. Flash-версия, предлагая меньшую задержку и преимущество в стоимости; Pro-версия работает с максимальной производительностью и точностью.
Flash-модель оптимизирована для приложений реального времени, таких как чат-боты, обслуживание клиентов и быстрое производство контента. Соответствующая модель Pro предпочтительнее в более тяжелых и сложных задачах. Это различие позволяет разработчикам выбрать правильную модель в соответствии с их потребностями.
Flash-модель предлагает меньшую задержку благодаря меньшей структуре активных параметров по сравнению с версией Pro, в то время как простые задачи агента могут выполняться близко к уровню Pro. Противоположной моделью Pro являются особенно сложные рассуждения, четкий поиск кодирования и решение научных задач. Более сильные результаты производить.
Ценообразование API DeepSeek V4: конкурентная стратегия
Ценообразование DeepSeek V4 API оценивается как агрессивная конкурентная стратегия, учитывая технические возможности модели. Благодаря своей архитектуре MoE, снижение затрат на обработку отражается как более доступный интерфейс API для пользователя.
Эта ситуация выделяется как фактор, непосредственно влияющий на конкуренцию с крупными игроками, такими как OpenAI и Google на рынке. Более длительный контекст, более низкая стоимость и высокая производительность позволяют DeepSeek занять прочные позиции в глобальной гонке искусственного интеллекта.
DeepSeek V4 API работает с OpenAI ChatCompletions и Anthropic совместимой структурой. У пользователей есть только название модели. deepseek-v4-pro или deepseek-v4-flash Он может интегрироваться в существующие системы путем изменения. Домой «Мыслительный режим» и поддерживают различные уровни рассуждений, такие как «режим немышления».
Новый баланс в глобальной гонке искусственного интеллекта
Внедрение DeepSeek V4 является не только технической разработкой, но и создает новую точку баланса в глобальной конкуренции искусственного интеллекта. Быстрый прогресс в этой области китайских компаний все больше злится на американских технологических гигантов.
В этом контексте внимание также привлекает производительность моделей, разработанных на инфраструктуре NVIDIA. Оптимизация аппаратной и программной интеграции является одним из факторов, которые играют решающую роль в будущем ИИ.
Масштаб, эффективность и перспективы на будущее
DeepSeek V4 считается не только более крупными моделями в области искусственного интеллекта; более эффективными, более масштабируемыми и более доступными системами. 1 млн. токенов, 1,6 трлн. параметров и усовершенствованная архитектурная оптимизация; эта модель показывает, что эта модель будет формировать стандарты искусственного интеллекта в ближайшие годы.
Эта разработка открывает не только для технологических компаний искусственного интеллекта, но и становится стратегической инфраструктурой для всех секторов. Наряду с DeepSeek V4, концепция «большой модели» оставляет «более умную и эффективную модель».
DeepSeek V4, особенно в глобальной гонке ИИ важный переломный момент на стороне открытого исходного кода создавать. Публикация модели с открытыми весами усиливает потенциал создания альтернативной экосистемы закрытым системам.
JP Morgan Raporu: İnsansı Robotlarda Dönüm Noktası
Robotlara Beyin Geldi: Gemini Robotics-ER 1.6 ile Tanışın!


