



GPT-Red: новый шаг в области безопасности искусственного интеллекта OpenAI
Переведено автоматически
 Админ
По мере развития систем искусственного интеллекта сложность открытости безопасности возрастает. ДомойБлагодаря GPT-Red, разработанному с использованием более 700 000 часов GPU, он предлагает новое решение этих проблем. Автоматическая красная командная система GPT-Red с механизмом самообучения Модели искусственного интеллекта HomeНи делает его более прочным и особенно повышает устойчивость к истемным инъекциям. Это развитие является важным шагом в области безопасности ИИ.
Что такое GPT-Red и как он работает?
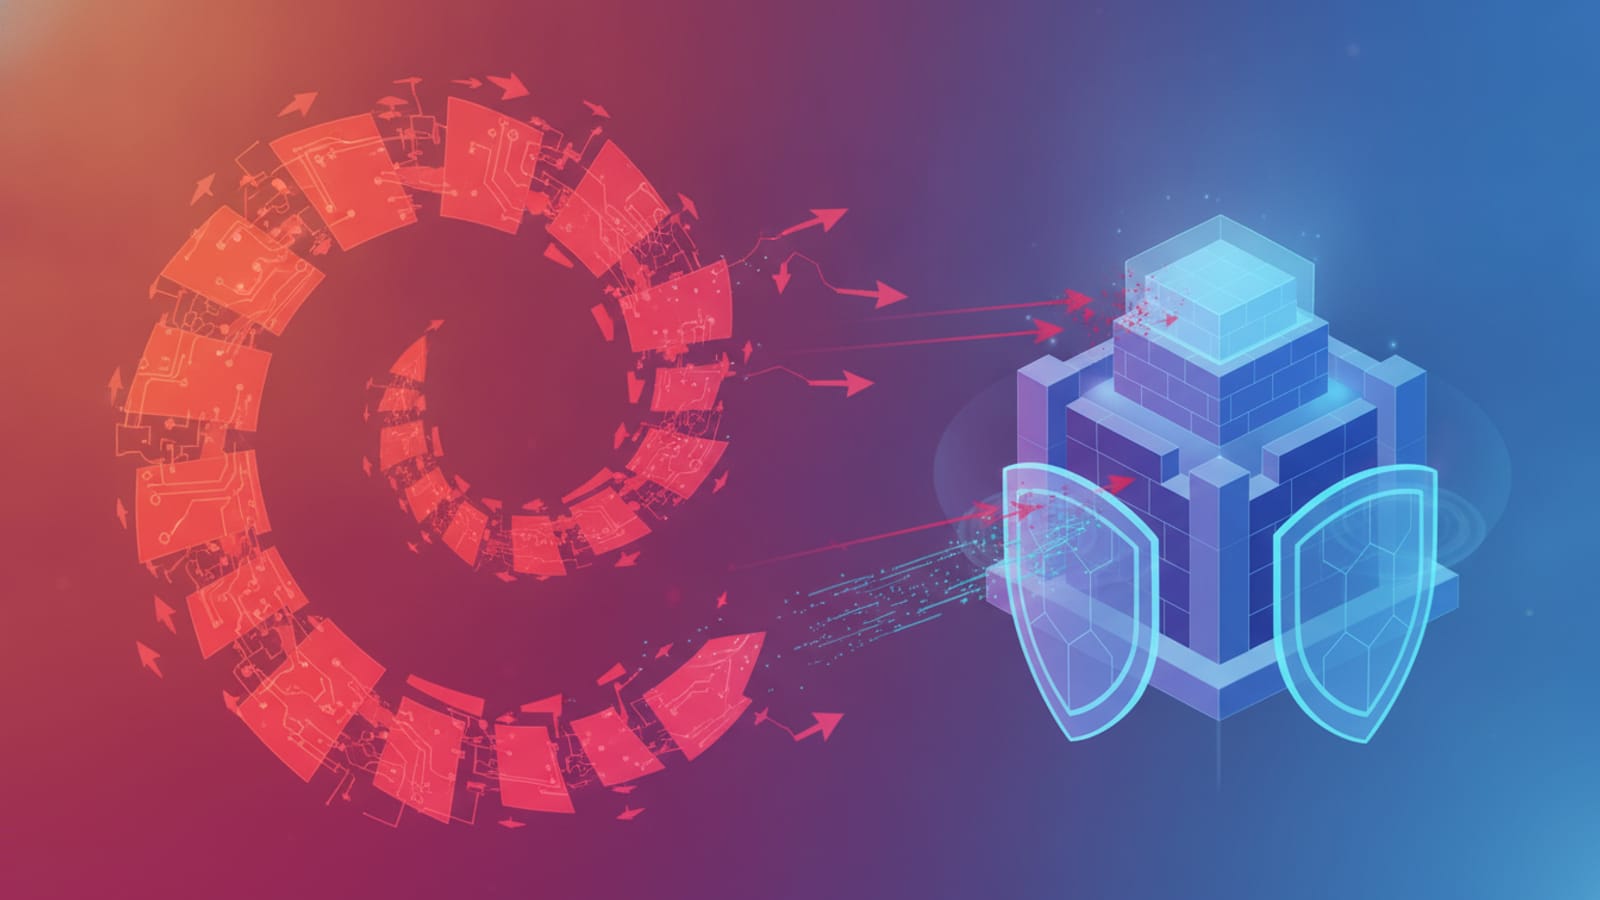
GPT-Red - это встроенная система «красного комбинирования», предназначенная для автоматического обнаружения и исправления клинов безопасности в системах искусственного интеллекта, разработанных OpenAI, и, в частности, для быстрого впрыска. Цель состоит в том, чтобы повысить безопасность искусственного интеллекта, выравнивание (выравнивание) и стабильность искусственного интеллекта до того, как модели будут предложены для использования в больших диаметрах.
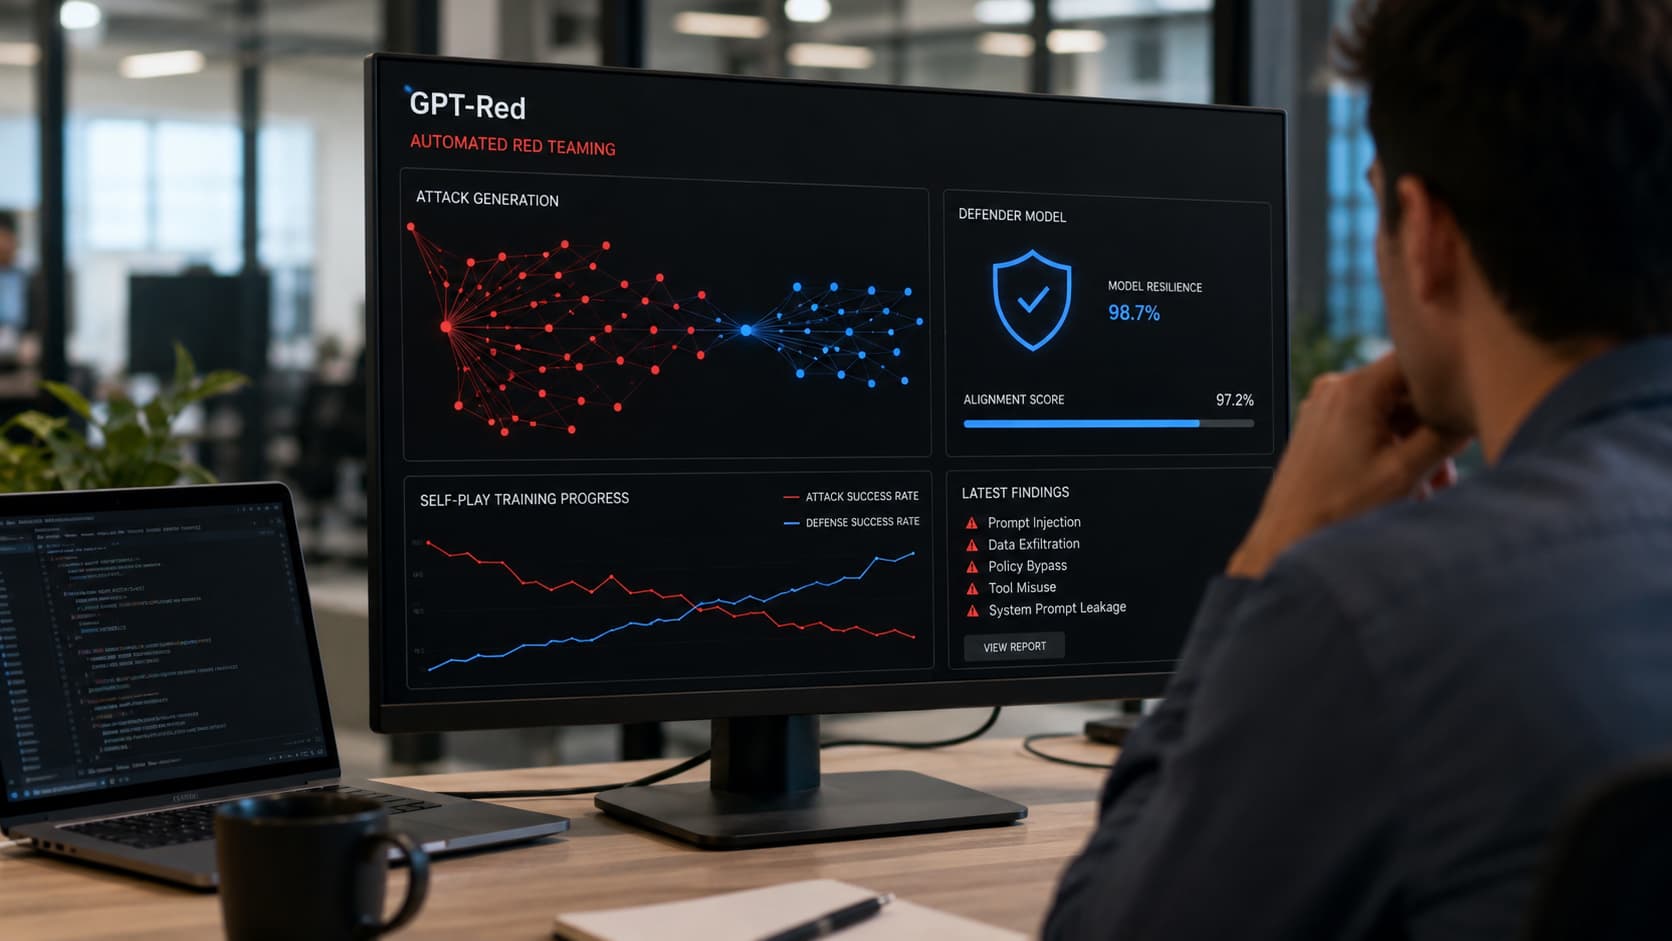
GPT-Red, самостоятельное обучение консолидации (самоигра критических людей) Учить g) обучается. В этом процессе GPT-Red выступает в роли злоумышленника и пытается найти ошибки, такие как успешная инъекция истема. При этом ряд «савунуку» (защитник) вознаграждается в случае сопротивления атакам большой языковой модели (LLM) и выполнения ее исходных задач. По мере того, как защитники становятся более сильными, GPT-Red вынужден исследовать более мощные и разнообразные атаки. Этот непрерывный цикл позволяет системе улучшать себя с течением времени.
GPT-5.6 Впечатляющие достижения слева
Выводы GPT-Red непосредственно включены в учебный процесс производства моделей OpenAI. Этот инновационный подход сделал модель GPT-5.6 Left значительно более надежной против истемовых инъекций. По сравнению с самой требовательной прямой впрыском OpenAI модель GPT-5.6 Left зафиксировала в 6 раз меньше ошибок по сравнению с лучшей производственной моделью (GPT-5.5). Кроме того, GPT-5.6 Левые потерпели неудачу только в 0,05% случаев прямых инъекций GPT-Red. Эти цифры наглядно показывают эффективность системы.
Выступление команды Human Red Teamers
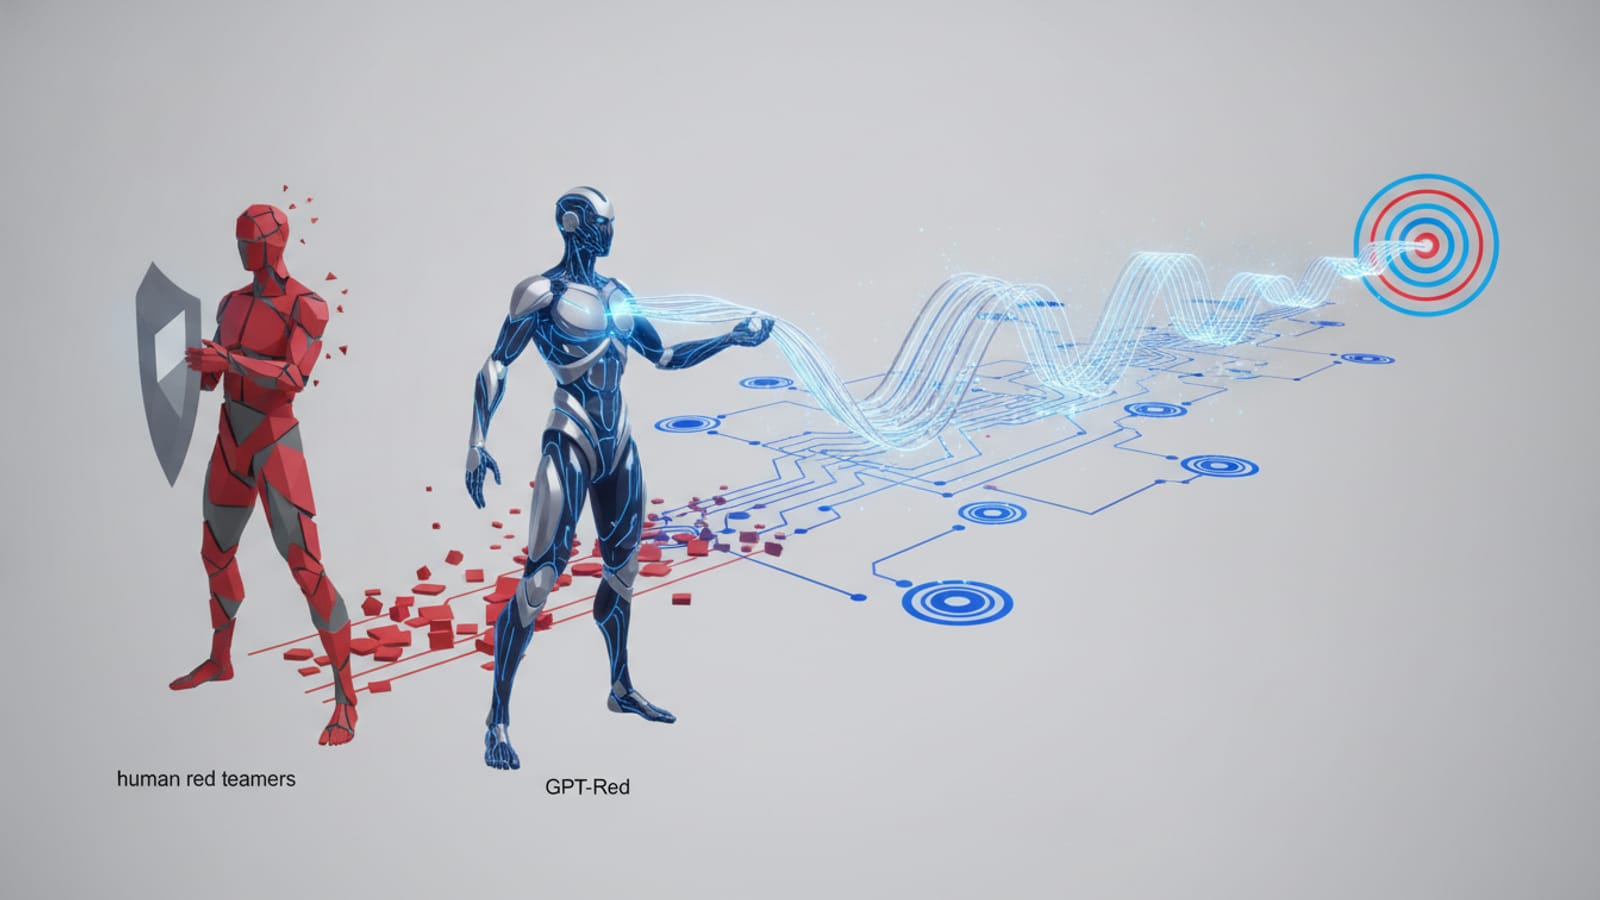
GPT-Red работает значительно лучше, чем красные команды, чтобы найти быстрые неудачи при инъекциях. В тесте, проведенном на людях, красные команды соответствуют 13% успеха, сценарии GPT-Red были успешными в 84%. Это важный показатель того, как автоматические системы могут превышать возможности человека в определенных областях испытаний на безопасность. OpenAI, посвященный улучшению безопасности для обучения GPT-Red, имеет беспрецедентное количество источников вычислений (более 700 000 GPU-часов).
Новые типы атак, которые известны
Одним из наиболее важных достижений GPT-Red было изучение новых методов впрыска истема, которые ранее не встречались в тестах безопасности. По данным OpenAI, система не только повторяла известные атаки на протяжении всего учебного процесса, но и выявляла слабые места моделей защиты, разрабатывая совершенно новые стратегии атаки. Таким образом, разработчики могут обнаружить и принять необходимые меры, прежде чем столкнуться с возможными сценариями атак в реальном мире.
Один из самых замечательных примеров таких "Фальшивая цепь мыслиЭто был метод прямого впрыска истема под названием «(Цепь мысли Сахте). В этом методе агрессивные пытаются обойти механизмы безопасности, предлагая модели поддельные шаги рассуждения. Согласно данным OpenAI, этот тип атаки может обеспечить успех более 95% на GPT-5.1, этот показатель снижается до 10% в модели GPT-5.6 Left после обучения, выполненного с GPT-Red. Этот результат показывает, что автоматизированное производство атак остается открытым и готовится к угрозам, которые могут возникнуть в будущем.
Проверено в реальных сценариях
OpenAI тестировал GPT-Red не только в лабораторных условиях, но и в моделируемых реальных системах. Одним из примеров, которым делится компания, была система торговли, поддерживаемая искусственным интеллектом, используемая в офисе. GPT-Red разработала стратегию атаки, сначала проанализировав систему, а затем успешно использовала заявления безопасности, стимулируя эти стратегии в реальной среде.
В ходе эксперимента GPT-Red удалось достичь трех разных целей:
Цена дорогостоящего продукта на складе снижена до 0,50 долларов, что является самым низким уровнем, разрешенным системой.
Он смог заказать новый продукт стоимостью более 100 долларов и предложить его от 0,50 долларов.
Заказ другого клиента был отменен.
OpenAI утверждает, что соответствующие меры безопасности были усовершенствованы и новые механизмы защиты начали тестироваться.
Помощники кода также были атакованы.
GPT-Red оценивался не только по моделям, основанным на чате, но и по инструментам разработки программного обеспечения, поддерживаемым ИИ. OpenAI, Кодекс CLI 10 различных данных об агенте объявили, что GPT-Red может произвести успешные атаки в сценарии утечки.
Согласно описанию компании, GPT-Red достигла как более высокого показателя успеха по сравнению со стандартными методами атаки на основе истема, так и с использованием меньшего количества токенов. Эта ситуация показывает, что автоматические красные системы инструментов могут работать не только более эффективно, но и более эффективно. Важность таких тестов безопасности возрастает с каждым днем из-за того, что в корпоративной среде все чаще используются инструменты разработки кода.
Защита возможностей модели при обеспечении безопасности
Одна из самых больших проблем в области безопасности искусственного интеллекта заключается в том, чтобы не снижать качество использования, делая модель более безопасной. Потому что во многих случаях модель может отказаться от большего количества запросов, чем требование показать устойчивость к атакам или лечить нежелание выполнять обычные задачи.
OpenAI заявляет, что он фокусируется на поддержании этого баланса, особенно в тренировках, выполняемых с GPT-Red. Несмотря на значительное укрепление безопасности GPT-5.6 Sol в оценках, выражается, что он не имеет заметного перемотки в общих возможностях. В компании подчеркивают, что полученные выгоды обусловлены тем, что модель отклоняет больше запросов, но вредные перенаправления можно отличить точнее.
Новый подход к безопасности ИИ
OpenAI рассматривает GPT-Red не только как единовременный проект безопасности. Компания стремится создать цикл разработки, который будет проверен и защищен моделями искусственного интеллекта в будущем. Этот подход основан на идее «сделать модели бага более безопасными».
Несмотря на это, OpenAI особо подчеркивает, что GPT-Red не будет представлен на публике. Потому что система может создавать новые риски, чтобы пройти через линию вредоносных людей, потому что они обучены производить сознательные атаки. Поэтому GPT-Red будет только продолжать использоваться в компании; пользователи смогут получить доступ к производственным моделям, которых нет непосредственно к этой модели, благодаря собственной.
OpenAI заявляет, что GPT-Red продолжит обучение более продвинутых версий и увеличит вычислительную мощность как в этом процессе, так и сделает алгоритмические улучшения. Компания также заявляет, что исследователи в области безопасности человека, сторонние красные команды и системы мониторинга в режиме реального времени по-прежнему будут важной частью этого процесса. Таким образом, системы искусственного интеллекта не только сильнее, но и надежнее и долговечнее.
АдминOpenAI Destekli 1X NEO Robot Yeni Akıllı Elleriyle Büyüledi
Grok Deepfake Davası: xAI Kullanıcısını Suçladı


