Türk Yapay Zeka Modelleri: BİLGE, Kumru, T3 AI ve Diğerleri

 Yazar
Büyük dil modelleri dünyayı kasıp kavururken gözden kaçan çok temel bir gerçek var: Silikon Vadisi çıkışlı dev modeller ne kadar yetenekli olursa olsun, iş Türkçeye geldiğinde farklılaşıyor. Çoğumuz o modellerle çalışırken araya sıkışan tuhaf çeviri kokan cümleleri, deyimlerin anlamsızlaşmasını ya da basit bir teknik sorunun gereksiz yere uzatılmasını fark etmişizdir. İşte tam bu noktada yerli yapay zeka projeleri, sadece milli bir gurur meselesi olmaktan çıkıp doğrudan teknik bir zorunluluk haline geldi.
Bugün Türkiye’de geliştirilen yapay zeka ekosistemi, OpenAI veya Anthropic modellerinin önüne basit bir arayüz giydiren projelerden ibaret değil. Kendi ağırlıklarıyla eğitilen, açık kaynak topluluklarının katkısıyla büyüyen ve doğrudan Türkçenin sondan eklemeli yapısına odaklanan güçlü bir altyapı inşa ediliyor.
Hangisini Nasıl Denersin?
Önce kısa bir tablo: hangi modele bugün nasıl ulaşabileceğin ve modelin açık mı kapalı mı olduğu (14.10.2026 itibarıyla).
Model | Geliştirici | Nasıl erişilir? | Açık / kapalı |
|---|---|---|---|
BİLGE | TÜBİTAK BİLGEM | Henüz genel kullanıma açık değil; pilot projeler için bilge.gov.tr üzerinden TÜBİTAK BİLGEM'e başvurulabiliyor | Kapalı |
Kumru | VNGRS | kumru.ai demosu; Kumru-2B Hugging Face'te | 7,4B kapalı, 2B açık (Apache 2.0) |
T3 AI | T3 Vakfı ve Baykar | 11.07.2025'te TEKNOFEST Sosyal Platformu'nda beta olarak açıldı | Açık kaynak hedefli; indirilebilir ağırlık paylaşılmadı |
Trendyol LLM | Trendyol | Hugging Face'ten indirilebilir | Açık ağırlık |
TURNA | Boğaziçi Üniversitesi TABILab | Hugging Face'ten indirilebilir | Açık, yalnız ticari olmayan akademik kullanım |
MAIN | HAVELSAN | Kurumlara özel, kurum içine kurulan platform | Kapalı |
Neden Küresel Modeller Yetmiyor?
Küresel yapay zekalar trilyonlarca kelimelik devasa arşivlerle eğitilse de bu verinin çok az bir kısmı Türkçeden oluşuyor. Bu durum iki büyük sorunu beraberinde getiriyor:
Token İsrafı ve Yüksek Fatura:
İngilizceye göre tasarlanmış tokenizer sistemleri, Türkçenin kök ve ek mantığını çözemiyor. Basit bir kelimeyi 3-4 parçaya (token) bölüyor. Bu da hem API kullanım faturalarını katlıyor hem de sistemin yanıt üretme süresini bariz biçimde uzatıyor.
Kültürel ve Hukuki Bağlam:
Küresel bir modele Türk Ticaret Kanunu’na uygun bir sözleşme analizi yaptırmak ya da yerel bir deyimin geçtiği müşteri şikayetini doğru duyguyla sınıflandırmak oldukça riskli. Çünkü model varsayılan olarak Batı kültürünü ve Amerikan hukuk mantığını referans alıyor.
Bu açığı kapatmak için Türkiye'de akademi, kamu ve bağımsız girişimler bir araya gelerek Türk yapay zeka modelleri geliştirmeye odaklandı.
Sahada Neler Oluyor? Öne Çıkan Yerli Modeller
Türkiye'deki yapay zeka projeleri; devlet destekli büyük ölçekli altyapılardan bağımsız girişimlerin çevik çözümlerine kadar farklı ihtiyaçlara yanıt veriyor.
1. BİLGE: TÜBİTAK’tan Kapsamlı Dil Modeli Ailesi
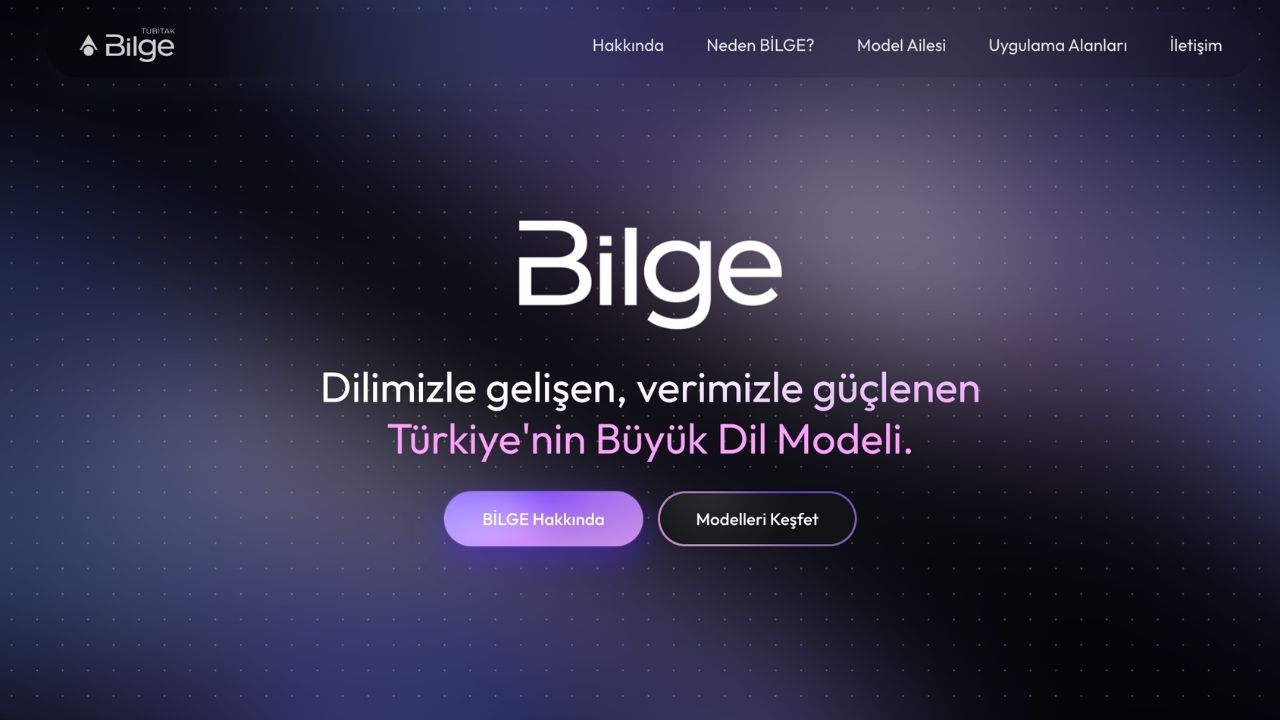
Kamu tarafındaki en somut ve kapsamlı adım, TÜBİTAK BİLGEM tarafından hayata geçirilen BİLGE projesi oldu. BİLGE’nin en büyük iddiası, Türkçeyi başka bir dilden çeviri yapmadan, doğrudan ana düşünce dili olarak kullanması.
Farklı İhtiyaçlar İçin Farklı Boyutlar:
BİLGE tek bir model değil, bir aile. Mobil ve uç cihazlar için tasarlanan 1B ile performans ve verimlilik dengesini gözeten 9B sıfırdan eğitildi. BİLGE 27B, Türkçe verilerle Sürekli Ön Eğitim (Continued Pre-Training) yöntemiyle geliştirildi. Karmaşık akıl yürütme görevleri için tasarlanan BİLGE 122B ise hâlâ geliştirme aşamasında.
Devasa Türkçe Korpus:
Eğitim, yaklaşık 1 trilyon kelimelik ham Türkçe veri havuzuyla başladı. Bu havuzdan 250 milyar yüksek kaliteli token seçildi ve veri 500 milyar sentetik veriyle zenginleştirildi. Amaç, modelin deyimleri, atasözlerini ve teknik terimleri Türkçe bağlamında doğru kavraması.
Düşük Enerji ve Maliyet:
Türkçeye uygun bir tokenizer kullandığı için daha az işlem gücü harcaması hedefleniyor. Kamu kurumları başta olmak üzere veri güvenliğinin kritik olduğu kurumsal uygulamalar için tasarlandı.
Erişim durumu: 14.10.2026 itibarıyla BİLGE genel kullanıma açık değil. Resmi sitesine göre pilot projeler için TÜBİTAK BİLGEM ile iletişime geçilebiliyor. Erişimle ilgili duyuruların yalnızca Sanayi ve Teknoloji Bakanlığı ile TÜBİTAK'ın resmi kanallarından yapılacağı açıklandı.
2. Kumru AI: Hızlı, Odaklı ve Hafif
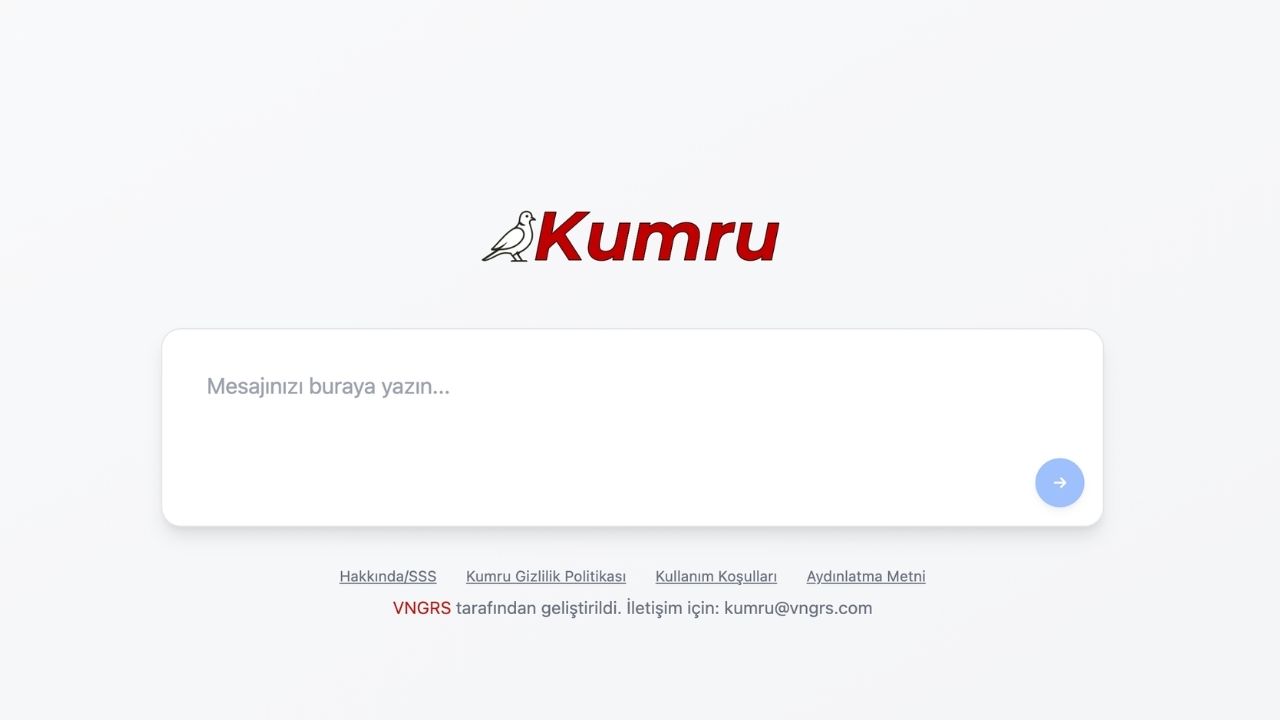
Girişim dünyasında ise devasa parametre yarışına girmek yerine işlevselliğe odaklanan modeller öne çıkıyor. Bunların başında gelen Kumru AI, işletmelerin dev bütçeler harcamadan kendi sunucularında çalıştırabileceği bir Türkçe LLM alternatifi sunuyor.
Metin özetleme, müşteri taleplerini kategorize etme ve doğal Türkçe diyalog kurma konularında oldukça başarılı olan model, donanım kaynaklarını yormadan yüksek çıkarım hızı sağlıyor.
VNGRS'in Türkçe için sıfırdan eğittiği Kumru 7,4 milyar parametreli ve 16 GB VRAM'li bir GPU'da çalışabiliyor. kumru.ai üzerindeki demodan deneyebilirsin; 2 milyar parametreli Kumru-2B ise Hugging Face'te Apache 2.0 lisansıyla açık. Teknik ayrıntılar ve sınırları için Kumru AI rehberimize bakabilirsin.
3. T3 AI: Açık Kaynak ve Topluluk Gücü
Türkiye Teknoloji Takımı Vakfı (T3 Vakfı) ile Baykar iş birliğinde geliştirilen T3 AI, işin topluluk boyutunu temsil ediyor. Model 11.07.2025'te TEKNOFEST Sosyal Platformu'nda beta sürümüyle kullanıma açıldı. Duyuru sırasında 67 ilden 1.792 gönüllünün projeye katkı verdiği açıklandı.
Proje açık kaynak olarak geliştirildiğini söylüyor; ancak parametre sayısı ve model ağırlıklarının nereden indirileceği henüz paylaşılmadı. Ağırlıklar açılırsa Türkiye'deki yazılımcıların hukuk ya da tıp gibi alanlara özel modeller eğitmesi kolaylaşabilir.
4. Akademik Omurga ve Açık Ağırlıklı Girişimler
Türkiye'deki ekosistem sadece bu üç isimle sınırlı değil:
Trendyol LLM:
Trendyol LLM'in ilk sürümü (2024) Meta'nın LLaMA 2 7B modeli üzerine 10 milyar token'lık Türkçe veriyle eğitildi. Sonraki sürümler Qwen 2.5 7B, Qwen 3 8B ve Gemma 3 12B tabanlarına geçti. Şubat 2026'da paylaşılan Trendyol-LLM-Asure-12B metnin yanında görselleri de işleyebiliyor ve özetleme, soru-cevap gibi e-ticaret görevleri için ayarlandı. Modeller Hugging Face'te açık ağırlıklı olarak paylaşılıyor.
TURNA:
Boğaziçi Üniversitesi Bilgisayar Mühendisliği Bölümü'ndeki TABILab'in geliştirdiği TURNA, UL2 çerçevesine dayanan 1,1 milyar parametreli bir kodlayıcı-çözücü (encoder-decoder) Türkçe dil modeli. Hem anlama hem metin üretme görevleri için tasarlandı ve Hugging Face'te yalnız ticari olmayan akademik araştırmalar için paylaşıldı.
Zemberek Mirası:
Açık kaynak Türkçe doğal dil işleme kütüphanesi Zemberek, kök-ek çözümleme gibi temel işlerde uzun yıllardır başvurulan araçlardan biri.
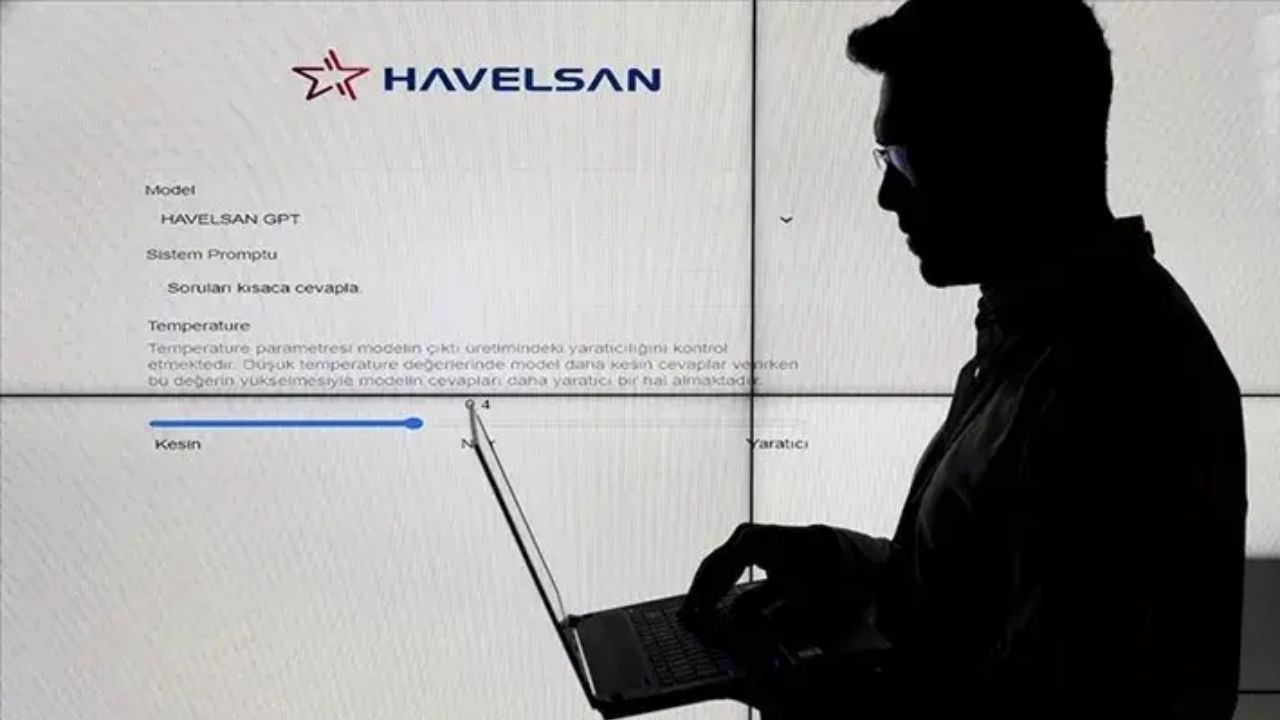
5. MAIN GPT (HAVELSAN): Savunma ve Kurumsal Güvenliğin Yerli Beyni
Yerli yapay zeka hamlesinin en kritik ayaklarından biri de savunma sanayii ve kamu güvenliği tarafında atılıyor. HAVELSAN tarafından tamamen kurum içi veri güvenliğini ve yüksek gizlilik standartlarını korumak üzere geliştirilen HAVELSAN MAIN GPT Türkiye’nin kapalı devre çalışabilen kurumsal yapay zeka altyapılarından biri olarak öne çıkıyor.
HAVELSAN'ın 01.02.2024'te tanıttığı MAIN (Multifunctional Artificial Intelligence Network), kurumların kendi verilerine dayalı yapay zeka asistanı kurabildiği bir platform. Kapalı devre çalışacak şekilde tasarlandı; amaç verinin kurum dışına çıkmaması. İlk aşamada metin tabanlı çalışıyor; içerik özetleme, açık kaynaklı verilerden bilgi çekme ve kod yazma gibi işler yapabiliyor.
6. Aigency: Erken Dönem Türkçe Dil Modeli Girişimi
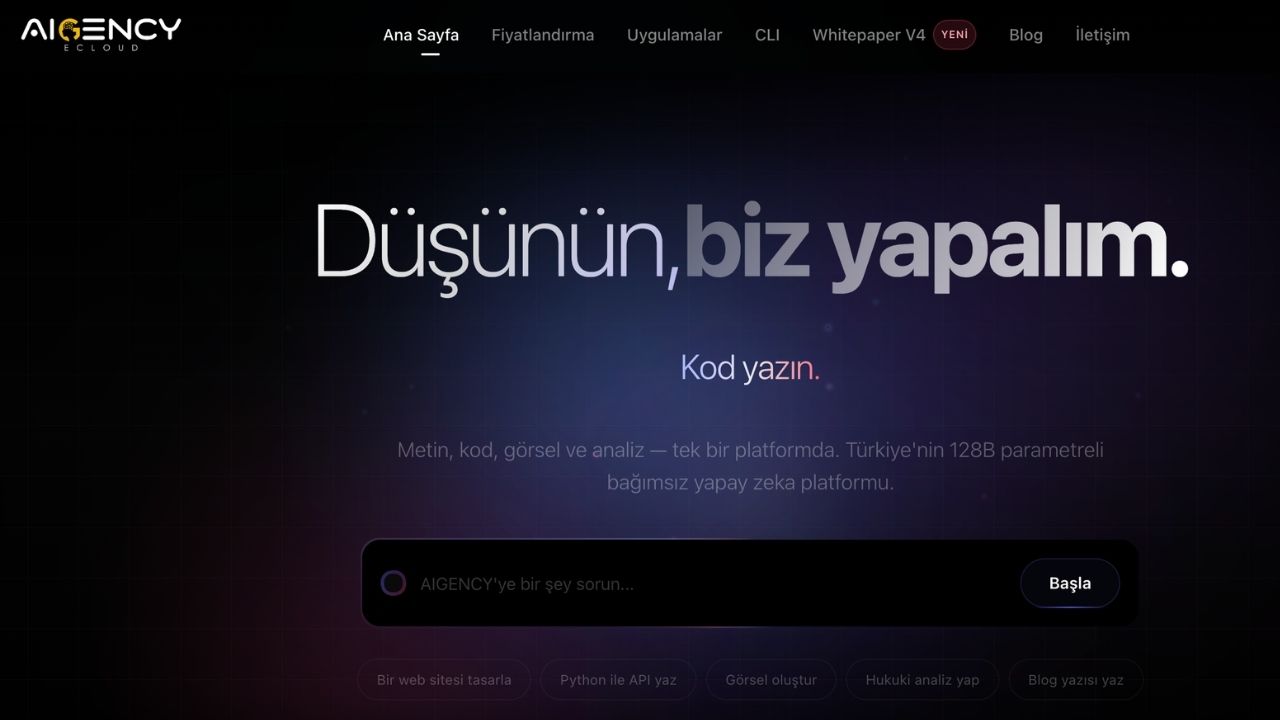
Şanlıurfa merkezli eCloud Yazılım Teknolojileri'nin 2022'de geliştirmeye başladığı Aigency, kendini Türkiye'nin ilk yerli dil modellerinden biri olarak tanıtıyor. Yerel basındaki haberlere göre Meta'nın LLaMA 3 modelini temel alıyor ve Türkçe metin üretimi, içerik analizi ve kurumsal iletişim süreçlerine odaklanıyor. Modelin bağımsız bir değerlendirmesi henüz yayımlanmadı.
Modellerin Genel Görünümü:
Model | Geliştirici | Ölçek / Yaklaşım | Temel Odak | En Büyük Artısı |
|---|---|---|---|---|
BİLGE | TÜBİTAK BİLGEM | 1B, 9B, 27B (122B geliştiriliyor) | Kamu, Kurumsal, Dijital Egemenlik | 1 trilyon kelimelik ham veri havuzu, yerli altyapı |
Kumru AI | VNGRS | 7,4B sıfırdan eğitim; 2B açık | Kurum içi (B2B) belge işleme, özetleme | Düşük sunucu maliyeti, hızlı yanıt süresi |
T3 AI | T3 Vakfı ve Baykar | Parametre sayısı açıklanmadı | Topluluk Tabanlı Türkçe LLM | Gönüllü veri seti, açık kaynak ekosistem hedefi |
Trendyol LLM | Trendyol Tech | 7B - 12B açık ağırlık | E-Ticaret ve Müşteri Diyaloğu | Pratik senaryolara doğrudan entegre olabilmesi |
MAIN GPT | HAVELSAN | Kurumsal & İzole Dil Modeli | Savunma, Kamu ve Kurumsal Veri Güvenliği | Kapalı devre (on-premise) çalışma |
Aigency | eCloud Yazılım | Erken Aşama Dil Mimarisi | Metin Üretimi ve Kurumsal İletişim | Türkçe metin üretimine odaklanan erken dönem girişim |
Geliştiriciler ve Şirketler İçin Neden Önemli?
Yerli bir dil modelini tercih etmek sadece "yerli teknolojiyi destekleyelim" fikrinden ibaret değil; doğrudan şirketlerin cebini ve yasal süreçlerini ilgilendiren avantajlar barındırıyor:
KVKK ve Veri Güvenliği:
Bir bankanın, hastanenin veya e-ticaret sitesinin kullanıcı verilerini alıp yurt dışındaki kapalı bir API'ye göndermesi regülasyonlar nedeniyle ciddi bir baş ağrısı. Yerli modeller doğrudan kurumun kendi sunucusunda (on-premise) çalışabildiği için veriler kurum dışına hiç çıkmıyor.
Daha Az Donanım, Daha Çok Hız:
Yüz milyarlarca parametrelik hantal modeller yerine, spesifik bir iş için eğitilmiş 7B ya da 14B'lik kompakt bir modeli tek bir orta segment GPU üzerinde rahatlıkla çalıştırabilirsiniz. Bu da sunucu ve elektrik maliyetlerini ciddi biçimde aşağı çekiyor.
Dışa Bağımlılığı Kırmak:
Global yapay zeka şirketlerinin bir gecede API fiyatlarını iki katına çıkarması veya erişim kısıtlaması getirmesi işinizi durma noktasına getirebilir. Açık ağırlıklarını Hugging Face gibi platformlardan indirebildiğiniz yerli modeller, yazılım mimarinizi tamamen kendi kontrolünüzde tutmanızı sağlar.
TRUBA gibi ulusal süper bilgisayar kaynaklarının araştırmacılara açılması ve savunma sanayiinde (ASELSAN, HAVELSAN) edinilen yazılım tecrübesinin sivil alana taşınmasıyla birlikte Türkiye'de yapay zeka üretimi hızla tabana yayılıyor. Artık mesele sadece metin yazdırmak değil; yerel veriyi güvenle işleyen, kendi kültürümüzü ve dilimizi gerçekten anlayan otonom sistemler kurabilmek. Yerli modeller de tam olarak bu bağımsızlığın omurgasını örüyor.
Geleceği Kendi Kodlarımızla Yazmak
Yapay zeka yarışı artık sadece kimin daha büyük bir sunucu çiftliğine sahip olduğuyla değil, bu teknolojinin yerel ihtiyaçlara ne kadar gerçekçi dokunduğuyla ölçülüyor. Türkiye'de geliştirilen modeller; hazır kalıpları kopyalamak yerine Türkçenin inceliklerini çözmeye, veri güvenliğini sağlamaya ve şirketlerin operasyonel maliyetlerini düşürmeye odaklanarak çok daha ayakları yere basan bir çizgiye yerleşti. BİLGE’nin kurumsal gücünden Kumru AI ve T3 AI gibi projelerin sunduğu esnekliğe kadar gelinen bu nokta, kendi dilinde düşünen ve üreten bağımsız bir teknoloji altyapısının artık bir temenni değil, somut bir gerçeklik olduğunu gösteriyor. Geleceği başkalarının algoritmalarıyla tüketmek yerine kendi kodlarımızla inşa etmek, dijital çağda atabileceğimiz en kritik adım.
Bu modellerin arkasındaki şirketlerden bazılarını 2026'da öne çıkan Türk yapay zeka şirketleri yazısında ele aldık. Kumru'nun teknik ayrıntıları için Kumru AI rehberine bakabilir, Türkçe dil modelleri üzerine çalışan insanlarla Masqot toplulukları üzerinden tanışabilirsin.
YazarDario Amodei'den Yapay Zeka Uyarısı: Sektör Yalan Söyledi
Gemini Ücretli mi? Ücretsiz Sürüm ve Tüm Planlar (2026)