
Yapay Zeka Neden Yanlış Bilgi Verir?


Büyük dil modelleri (LLM) ile yapılan araştırmalarda, iş akışlarında veya günlük bilgi edinme süreçlerinde sunulan yanıtlar son derece yetkin, akıcı ve ikna edici görünebilmektedir. Ancak verilen metin detaylı incelendiğinde; kaynak gösterilen bir akademik çalışmanın, mahkeme kararının ya da tarihsel olayın tamamen kurgusal olduğu ortaya çıkabilmektedir.
Bu durum, kullanıcıların zihninde kritik bir soruyu gündeme getirmektedir: Yapay zeka hata yapar mı, yapay zeka güvenilir mi?
Üretken yapay zeka araçları birer doğruluk denetleme mekanizması ya da klasik bir arama motoru değildir. Bu sistemlerin arkasındaki çalışma prensiplerini bilmek, yapay zeka halüsinasyon nedir sorusuna yanıt bulmayı ve üretilen çıktıları doğru süzgeçlerden geçirmeyi kolaylaştırmaktadır.
Yapay Zeka Halüsinasyonu Nedir?
Teknoloji literatüründe yapay zeka halüsinasyonu; bir yapay zeka modelinin gerçekte var olmayan, mantıksal olarak temelsiz veya olgusal açıdan yanlış bilgileri son derece kendinden emin, tutarlı ve akıcı bir anlatımla gerçekmiş gibi sunması durumudur.
İnsan psikolojisindeki sanrılardan farklı olarak buradaki süreç bilinçli bir yanılsama veya kasıtlı bir aldatma değildir. Model, matematiksel olarak en mantıklı görünen kelime dizilimini kurgularken olgusal gerçeklikten tamamen kopmaktadır.
IBM'in yapay zeka halüsinasyonları analizi çerçevesinde; bu modeller doğru ile yanlışı insan zihnindeki gibi ayırt edememektedir. Sistemler yalnızca eğitim verilerindeki örüntülere (patterns) neyin uyduğunu hesaplamakta, bilgi boşluğuyla karşılaştıklarında ise "konfabulasyon" (uydurma) yoluyla boşlukları doldurmaktadır. Örneğin, 2023 yılında ABD'de bir avukatın ChatGPT kullanarak hazırladığı dava dilekçesinde, modelin var olmayan içtihatları, dosya numaralarını ve sahte yargıç kararlarını gerçekmiş gibi kurguladığı tespit edilmiştir. Model, gerçek hukuk metinlerinin yapısını kusursuz taklit ettiği için ortaya çıkan sahte metin ilk bakışta ayırt edilememiştir.
Yapay Zeka ile Sıradan Hata Arasındaki Fark
Yapay zekanın sunduğu her yanlış cevap halüsinasyon kategorisinde değerlendirilmez. Bir modelin eski bir nüfus bilgisini vermesi, çeviride dil bilgisel bir hata yapması ya da teknik bir hesaplamada yanılması "sıradan hata" kapsamındadır. Sıradan hatalar çoğunlukla eğitim setindeki eksik bir veri veya işlem kuralı üzerinden takip edilebilir ve düzeltilebilir.
Halüsinasyon ise modelin zemininde hiçbir gerçek veri olmamasına rağmen tamamen kurgusal içerik türetmesi ve bunu kesin bir gerçeklik tonuyla sunmasıdır. Bu durum halüsinasyonların tespitini sıradan hatalara kıyasla çok daha zor kılmaktadır.
Yapay Zeka Neden Yanlış Bilgi Verir?
Yapay zekanın gerçeğe aykırı çıktılar üretmesini kavrayabilmek adına öncelikle yapay zeka teknolojisinin temelleri ve gelişim süreci hakkında bilgi sahibi olmak gerekir. Modellerin temelde birer veri işleme ve olasılık hesaplama mimarisi olduğu anlaşıldığında, hata paylarının mantığı da netleşmektedir:
1. İstatistiksel Tahmin ve Olasılık Mantığı
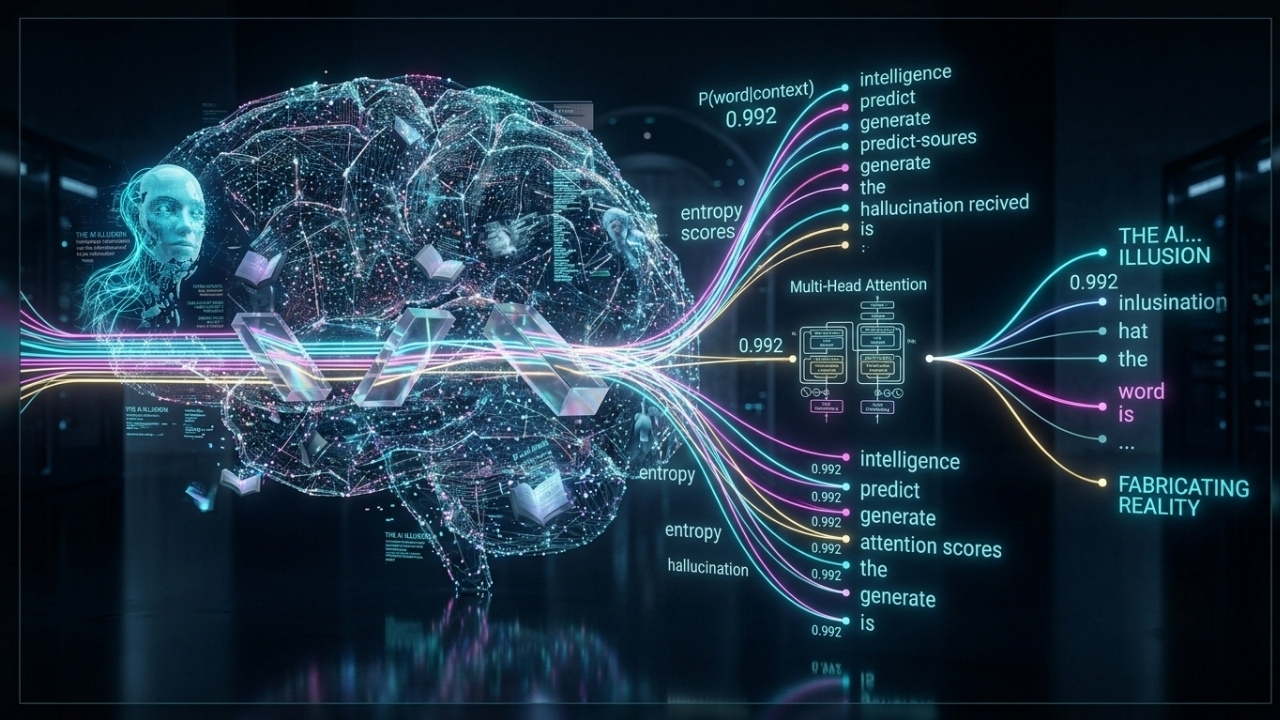
Büyük dil modelleri bir sonraki kelimeyi (token) tahmin etme prensibiyle çalışır. Model, "Bu ifadeden sonra istatistiksel olarak hangi kelimenin gelmesi en olasıdır?" sorusunu yanıtlamaya odaklanır. Model için öncelik cümlenin olgusal doğruluğu değil, dil yapısı ve anlamsal örüntü açısından inandırıcılığıdır. Mantık yürütme ile istatistiksel olasılık çatıştığında halüsinasyon meydana gelir.
2. Kusurlu, Yetersiz veya Aşırı Uydurulmuş (Overfitting) Eğitim Verisi
Modeller internet ortamındaki açık kaynaklar, makaleler ve dijital metinler taranarak eğitilir. Eğitim havuzunda yer alan yanlış bilgiler, önyargılar veya çelişkili ifadeler model tarafından genel kurallar olarak benimsenir. Bunun yanı sıra model eğitim verisine aşırı uyum sağladığında (overfitting), anlamsız korelasyonları kural zannederek genelleştirme yeteneğini kaybeder ve hatalı bağlantılar kurar.
3. Kullanıcı Girdilerine Aşırı Uyum Sağlama
Üretken modeller, kullanıcının komutuna (prompt) kesintisiz yanıt vermek üzere optimize edilmiştir. Çoğu zaman bilmediğini belirtmek yerine, kullanıcının sorduğu sorunun doğruluğunu peşinen kabul ederek cevap üretir. Örneğin, temelsiz veya kurgusal bir soru yöneltildiğinde model soruyu reddetmek yerine sorunun varsayımına uygun kurgusal bir senaryo yazar.
4. Güvenlik Açıkları ve Kötü Amaçlı Manipülasyonlar (Prompt Injection)
Yapay zekanın yanlış veya yanıltıcı bilgi üretmesi her zaman modelin eğitim eksikliğinden kaynaklanmaz. Dışarıdan yapılan manipülasyonlar da halüsinasyonu tetikleyebilmektedir. "Prompt injection" gibi düşmanca saldırı teknikleriyle modelin güvenlik katmanları manipüle edilerek sistemin tamamen kurgusal, yönlendirilmiş veya zararlı çıktılar üretmesi sağlanabilmektedir. Yapay zeka sistemlerinin bu tür müdahaleler karşısındaki kırılganlıklarını ve savunma mekanizmalarını anlamak için yapay zeka güvenliği nedir ve hacklenebilir mi konusunu kapsamlı bir şekilde ele almak gerekmektedir. Güvenlik filtreleri esnetilen veya manipüle edilen modellerde bilgi tutarlılığı hızla kaybolmaktadır.
5. Çoklu Ajan Sistemlerinde Hataların Büyümesi (Cascading Hallucinations)
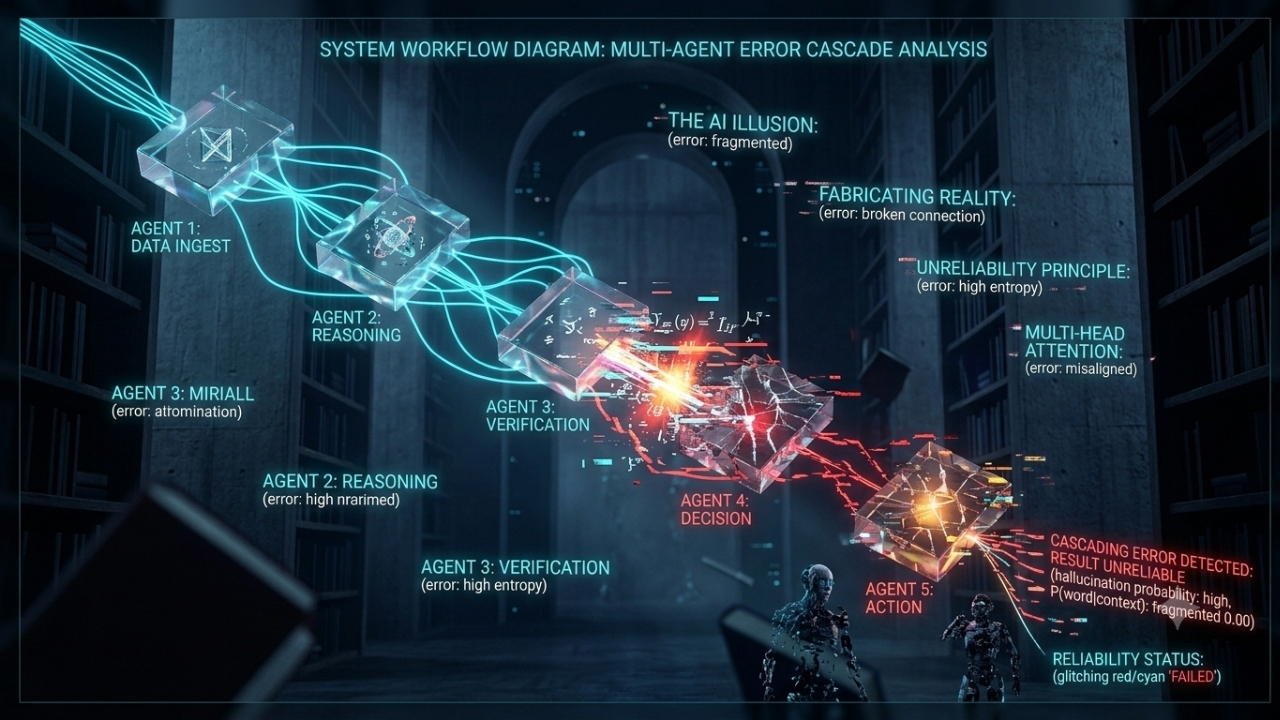
Günümüzde yaygınlaşan otonom yapay zeka ajanları zincirleme iş akışlarında birlikte çalışmaktadır. İlk ajanın ürettiği tek bir halüsinasyon, sonraki ajanlar tarafından doğrulanmış bir gerçek olarak kabul edilip karar süreçlerine dahil edildiğinde, operasyonel ve hukuki riskler katlanarak büyümektedir.
ChatGPT Hata Yapar mı, Günlük Hayatta Güvenilir mi?
ChatGPT ve benzeri tüm üretken yapay zeka sistemleri düzenli olarak hata yapabilmektedir.
Metin düzenleme, fikir geliştirme, kod şablonları oluşturma, dil çevirisi ve temel kavramların özetlenmesi gibi alanlarda oldukça verimlidir. Ancak sistemin çıktı kalitesini artırmak ve rastgeleliği kontrol altına almak için sıcaklık (temperature) veya top_p gibi teknik ayarların nasıl çalıştığını bilmek önem taşır. Modelden alınan yanıtların tutarlılığını artırmak ve tekrara düşen kalıpları denetlemek için uygulanan gelişmiş komut yapılarına ChatGPT gizli kodları ve parametreleri üzerinden erişilebilmektedir.
Buna karşın doğrudan karar alma mekanizması gerektiren şu alanlarda yapay zeka çıktıları nihai bir kaynak olarak değerlendirilmemelidir:
Tıp ve Sağlık: Dozaj, semptom ve tanı konularında yanlış veya spekülatif bilgi üretme riski yüksektir.
Hukuk: Yürürlükte olmayan mevzuat maddeleri veya sahte içtihatlar üretebilir.
Akademik Çalışmalar: Var olmayan kaynakçalar, uydurma yazarlar ve sahte DOI numaraları en yaygın halüsinasyon türleridir.
Finans: Doğrulanmamış piyasa ve şirket verileri üzerinden yanıltıcı yönlendirmeler yapabilir.
Halüsinasyon Riskini Azaltma Yöntemleri
Yapay zekanın hata payını tamamen sıfırlamak mevcut mimaride mümkün olmasa da doğru kullanım teknikleriyle minimize edilebilir. Halüsinasyon riskini en aza indirmede kullanılan rol tanımlama, adım adım düşünme ve bağlam sınırlama gibi yaklaşımlar, temel prompt mühendisliği teknikleri ile doğrudan ilişkilidir.
Strateji | Amacı | Örnek Komut Yaklaşımı |
|---|---|---|
Rol ve Çerçeve Belirleme | Spekülasyon alanını daraltır. | "Yalnızca doğrulanmış resmî mevzuat çerçevesinde yanıtla." |
Bilinmeyeni Bildirme Talimatı | Uydurma refleksini engeller. | "Cevaptan kesin emin değilsen tahmin yürütme, belirt." |
Kaynak İnceleme ve Bağlam Sağlama | Veri tabanı sınırlarını netleştirir. | "Aşağıdaki metne sadık kalarak ilgili soruları yanıtla." |
Adım Adım Akıl Yürütme | Mantıksal tutarlılığı artırır. | "Sonuca varmadan önce izlediğin adımları tek tek sırala." |
Halüsinasyon Sorunu Çözülebilir mi?
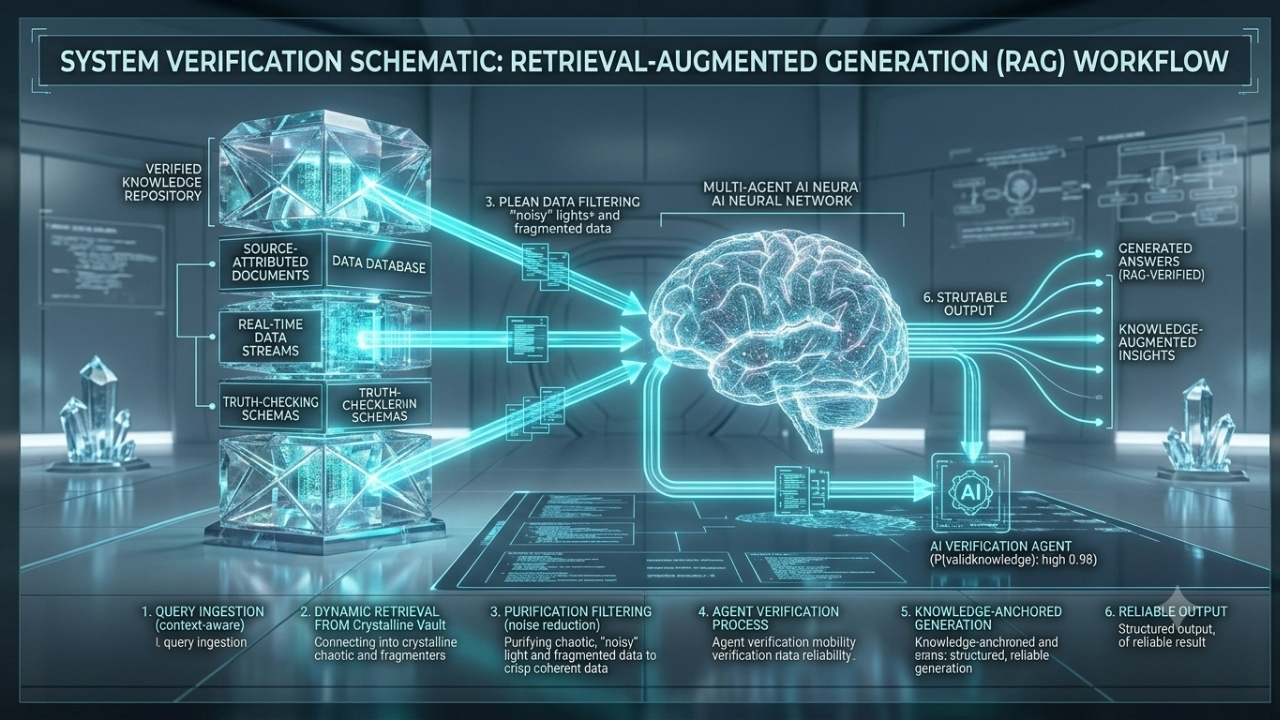
Yapay zeka modellerinin güvenilirliğini artırmak ve halüsinasyon riskini asgari düzeye çekmek adına hem akademik dünyada hem de teknoloji şirketlerinde yoğun Ar-Ge çalışmaları yürütülmektedir. Günümüzde bu alandaki en yaygın ve işlevsel mimari çözüm RAG (Retrieval-Augmented Generation / Geri Alımla Zenginleştirilmiş Üretim) olarak öne çıkmaktadır. RAG yönteminde dil modeli, doğrudan kendi kapalı parametrik hafızasındaki olasılıksal eşleşmelere bel bağlamak yerine; sorgu anında şirket veri tabanları, güncel web dizinleri veya doğrulanmış resmî belgeler gibi güvenilir harici bilgi kaynaklarına başvurur. İlgili ham veriyi bu kaynaklardan çektikten sonra kendi gelişmiş dil sentezleme kabiliyetini devreye sokarak yanıtı yapılandırır. Böylece modelin "boşluk doldurma" refleksi büyük ölçüde kontrol altına alınır ve bilgi doğrulanabilir bir temele oturtulur.
RAG mimarisinin yanı sıra modellerin akıl yürütme (reasoning) basamaklarını şeffaflaştıran yeni nesil eğitim teknikleri, geri bildirimli pekiştirmeli öğrenme (RLHF - Reinforcement Learning from Human Feedback) ve yapay zeka denetçilerinin devreye girdiği otomatik doğruluk filtreleri doğruluk oranlarını kademeli olarak yükseltmektedir. Ayrıca modellerin cevabı üretmeden önce kendi iç mantığını test ettiği öz-denetim (self-correction) mekanizmaları da sisteme entegre edilmektedir.
Tüm bu teknolojik ilerlemelere rağmen, mevcut büyük dil modelleri temelde semantik bir "anlama" veya "kavrama" yetisine değil; devasa veri setleri üzerindeki istatistiksel token (kelime/hece) tahminine dayanmaktadır. Matematiksel olarak çalışan bu olasılık motorlarında, sıfır hata veya mutlak doğruluk garantisi teorik olarak mümkün değildir. Geliştirilen yeni yöntemler halüsinasyon oranını sıfırlamamakta; yalnızca tespit edilebilir, sınırlandırılabilir ve yönetilebilir bir eşiğe çekmektedir.
Üretken yapay zeka sistemleri, mutlak bir bilgi otoritesi veya teyit mekanizması olarak değil; karmaşık işleri hızlandıran, ancak her zaman insan süzgecinden (human-in-the-loop) ve kritik düşünce filtresinden geçirilmesi zorunlu olan destekleyici asistanlar olarak konumlandırılmalıdır.
Yorumlar (0)
Yorum yapmak için giriş yapmalısınız.
Giriş Yap