



Kumru AI Nədir? Türkiyə İnkişaf Modelləri
Avtomatik tərcümə edildi
 Admin
Kumru 7,4 milyart parametrləri ilə ən böyük bir dil modeli (LLM) Türkiyə dəyişən VNGRS trenləri. Təhlükəsizlik məqsədiyyət və suallar kimi işlər üçün hazırlanmışdır; ilk ümumi versiyası sentyabr 2025-in sonunda açıqlandı. Memarlıq Mistral-v0.3 əsaslanır; rock camı (sliding penceresi) struktur olduğu kimi LLaMA-3 üçün əvvəldir.
Necə Denersin Kumru?
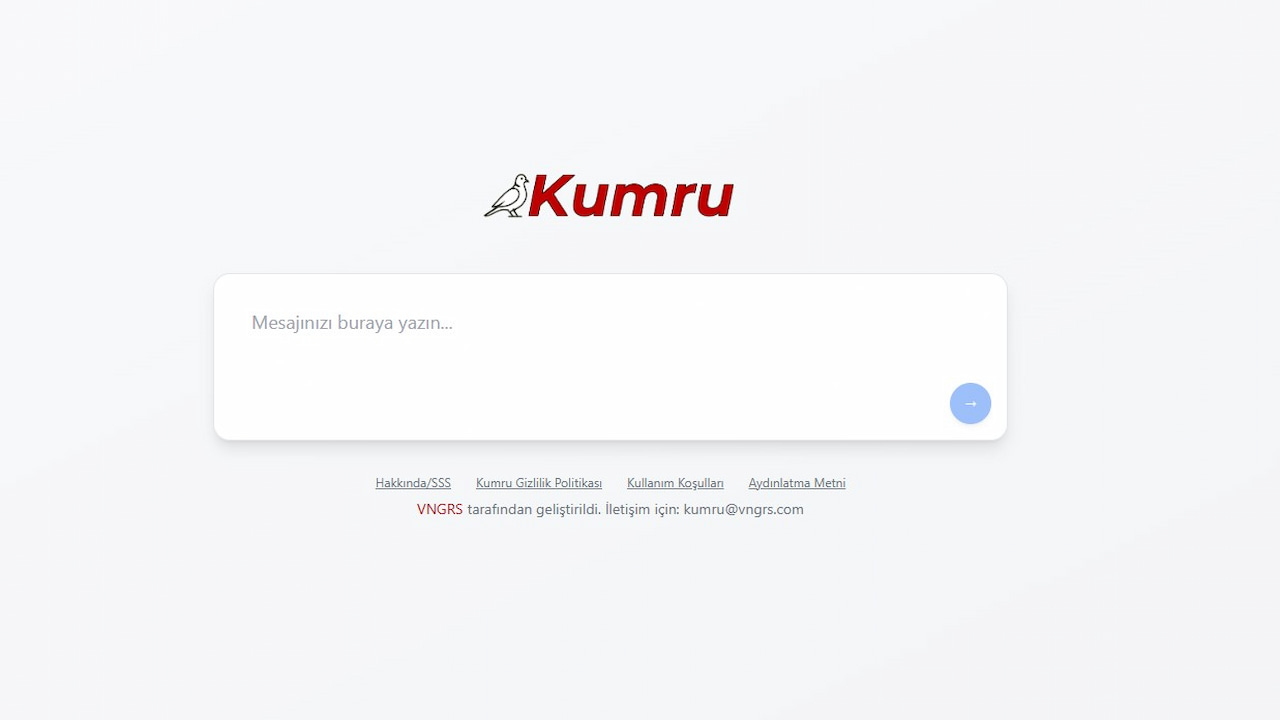
From Browser Home Qeydiyyatdan keçin; 7,4 milyart parametrləri ilə modelin demo chat ekran.
Türk problemlərini və ya chat qutusuna məsləhət etmək istədiyiniz məhsul yazın.
2 milyart parametrləri onların kompüter və ya server haqqında çalışırsan Kumru- 2BYou can download ' from Hugging Face; Apache 2.0 lisenziya ilə açıq.
Kumru əsas tərəfindən istifadə etmək üçün hazırlanmış kiçik modeldir. Demo versiyası yanlış məlumat verə bilər və matematikdə zorlanılır; aşağıdakı səbəbləri deyir.
Kumru AI VNGRS şirkəti tərəfindən hazırlanmışdır Bu inkişaf ChatGPT müsabiqələri olacaq, Kumru əsas missiyası son istifadəçindir, Türkiyə (on-premise).
Kumru AI və Niyə Sıfırdan proqram?
Kumru AI 7.4 milyart parametrlərinə əsasən bir solvent (decoder-only) memarlıqdır Böyük Dil Model (LLM). Modelin inkişafında əsas motivasiya əsas LLM modelinin əsas ehtiyacıdır ki, Türk dilinin məlumat təhlükəsizliyi tərəfindən istifadə edilə bilər.
Sıfırdan Eğitim Avantajı: LLaMA veya Gemma gibi çok dilli modeller üzerine ince ayar yapmak yerine, Kumru'nun Türkçe için sıfırdan eğitilmesi stratejik bir karardı. Hazır modellerin tokenizer’ları (metin kodlayıcıları) Türkçe metinleri işlerken çok daha fazla token harcar, bu da eğitim ve kullanım maliyetini artırır. Kumru ise Türkçeye özel geliştirilmiş modern bir tokenizer kullanıyor. VNGRS'in karşılaştırmasına göre diğer çok dilli modeller aynı Türkçe metin için Kumru'dan %38 ila %98 daha fazla token harcıyor. Bu verimlilik, Kumru’yu hız ve maliyet açısından yerinde dağıtım için ideal hale getirir.
Hafif ve Erişilebilir: Kumru, 16 GB VRAM'e sahip RTX A4000 veya RTX 3090 gibi orta seviye GPU'larda çalışabildiği için, büyük donanım yatırımları gerektirmeden kurumsal sistemlere entegre edilebilir. Bu özellik, veri güvenliği regülasyonlarına tabi sektörler (finans, sağlık vb.) için kritik önem taşır.
Kumru Yapay Zeka Nasıl Eğitildi ve Teknik Özellikleri Nelerdir?
Kumru'nun geliştirme süreci, tamamen Türk mühendislerden oluşan küçük bir ekip tarafından, dikkatli bir mühendislik çalışmasıyla yürütüldü:
Ön Eğitim Aşaması: Model, 45 gün süren ön eğitim aşamasında NVIDIA'nın H100 ve H200 GPU'ları kullanılarak 500 GB büyüklüğünde temizlenmiş ve tekilleştirilmiş Türkçe metinler üzerinde eğitildi. Bu süreçte Kumru, 300 milyar token'a maruz kaldı.
Mimari ve Destek: Kumru'nun mimarisi Mistral-v0.3'e dayanıyor; kayan pencere kapatıldığı için yapı olarak LLaMA-3 ile eşdeğer. Toplu iş boyutu, optimize edici ve öğrenme hızı gibi eğitim kararlarında da LLaMA-3’ün teknik raporu temel alındı.
Bağlam Uzunluğu: Kumru 8.192 Türkçe token'lık bağlam uzunluğuna sahip. Bu da, tek bir işlemde yaklaşık 20 A4 sayfaya kadar belge işleyebileceği anlamına gelir.
İnce Ayar (Fine-Tuning): Ön eğitimin ardından, çeşitli kullanım senaryolarını desteklemek için yaklaşık 1 milyon örnekten oluşan bir karışım üzerinde ince ayar yapıldı.
X Üzerinden Gelen Sorulara VNGRS'ten Yanıtlar: Yerli Yapay Zeka Kumru'yu Nasıl Konumlandırmalıyız?
VNGRS, Kumru’ya gösterilen yoğun ilginin ardından, sosyal medya (X) üzerinden gelen en kritik soruları yanıtlayarak modelin konumlandırmasını netleştirdi:
Kumru, ChatGPT'ye Rakip mi?
Yanıt: Hayır. Kumru, son kullanıcıya (B2C) yönelik bir ürün değil, kurum içi (B2B) çözümler için geliştirilmiş, küçük, hızlı ve ucuz bir çözümdür. ChatGPT hem B2C hem B2B için konumlandırılmış devasa bir model ailesidir.
Neden Hata Yapıyor (Halüsinasyon)?
Yanıt: Yapay zeka modellerindeki hatalı bilgi verme (halüsinasyon) problemi, pekiştirmeli öğrenme (RLHF) aşamasında en aza indirilir. Kumru, OpenAI'ın ilk Davinci modelleri gibi, henüz RLHF aşamasından geçmediği için hatalı bilgiler verebilmektedir. Bu eksiklik, gelecekteki geliştirmelerle giderilecektir.
Kumru Matematikte Neden Kötü?
Yanıt: Dil modelleri kelimelerden oluşur ve bilgiyi eğitildikleri metinlerden istatistiksel olarak öğrenirler; kendi içlerinde bir hesap makinesi mekanizmasına sahip değildirler. Kumru, Türkçe yetkinlik için geliştirildiği ve henüz RLHF aşamasından geçmediği için matematikte hata yapmaktadır.
Sıfırdan Eğitim Neden Seçildi?
Yanıt: Hazır (pre-trained) modelleri (LLaMA gibi) alıp ince ayar yapmak, orijinal modelin tokenizer’ını (metin kodlayıcısı) kullanmayı gerektirir. Bu da Türkçe metinler işlenirken maliyeti iki katına kadar artırır. VNGRS, bu nedenle tamamen sıfırdan, Türkçe'nin ihtiyaçlarına özel, maliyet ve hız açısından optimize edilmiş modern bir tokenizer ile Kumru'yu eğitmeyi seçti. Bu, uzun vadede verimlilik ve maliyet avantajı sağlamaktadır.
7 Milyarlık Model Açık Kaynak Yayınlanacak mı?
Answer: Daha böyük və multi-mode modellər istehsal olunur kimi, 7 milyard versiyadan başlayan yaşlı modellər tərəfindən yayımlanılır. VNGRS Hugging Face saytında yalnız 2 milyart parametrləri 14.10.2026 Kumru- 2B Kumru-2B-Base əsas versiyası Apache 2.0 lisenziyası ilə açıqdır. 7,4 milyard parametr modeli açıq mövcuddur.
Qeyd edilən sözlər yanlış cavab, Niyə?
Answer: Mövcud dil modelləri üçün ən yaxşı əlaqə (token). Model kriptovalyutaları görür, məhsulları emal etdiyi zaman etməyə bilməz. Buna görə, onlar tezlər haqqında suallar.
Mistral Model Memarlıq gəlir?
Answer: Model memarlıq Mistral lider Mistral modeli alınmış və təhsil edilmişdir deyil. Kumru yaradılmış və sonunda tokenizer və model ağırları ilə sona çatdırılmışdır. Memarlıq, binanın kompüter dizaynı kimi modelin ümumi strukturunu təyin edir.
Kumru AI istifadə etmək üçün necə və Future Plans necə?
Kumru AI, sandru.ai ünvanı Demo versiyası giriş.
Cari status (14.10.2026): Sentyabr 2025-ci ilin ilk dekabr ayından, VNGRS Hugging Face səhifəsi yeni Kumru modeli yayımlanmışdır. Aşağıdakı planlar VNGRS ilk versiya ilə paylaşılmışdır.
İndi Planlar:
Cheerful Learning (RLHF): Bu məhsulları modelin minimuma endirimini almaq və matematiksel xidməti inkişaf etdirmək üçün bu məhsul almaq planlaşdırılır.
Multimodallik: Kumru-ın multimodal modelini görsel və taranmış məlumatların emal imkanı (image encoder inteqrasiyası) təmin edir.
Böyük Modellər: Daha böyük və mahnı Kumru versiyaları daha böyük və up-to-date data setləri ilə təhsil olunub və sonra yaşlı modellər açıq mövzu kimi yayım.
Bu inkişaflar, VNGRSBu, Türkiyənin öz dil xüsusi AI ekosistemi üçün uzunmüddətli investisiyalar keçirilməsinin missiyasını göstərir.
Türkiyə (BİLGE, T3 AI, Trendyol LLM, TURNA və MAIN) Türkiyənin yerli AI modelləri Home Biz məhsulda müraciət edirik. VNGRS Türk AI şirkətləri 2026-da mövcuddur Siz siyahısı da gözlə bilərsiniz. Türk dili modelləri ilə danışmaq istəyirsinizsə Masqot iclası Sizə uyğun tapa bilərsiniz.
AdminHumain Horizon Pro Yapay Zeka Merkezli Yeni Nesil Laptop
OpenAI’da Yeni Dönem: Yönetim Kadrosunda Büyük Değişim


