



Kumru Was ist das? Eingeborene türkische künstliche Intelligenz
Automatisch übersetzt
 Admin
Kumru ist ein großes Sprachmodell (LLM) mit 7,4 Milliarden Parametern, das VNGRS von Grund auf für Türkisch trainiert. Die Textabstraktion wurde für Jobs wie Dokumentenverarbeitung und Frage-Cevap entwickelt; die erste allgemeine Version wurde Ende September 2025 angekündigt. Die Architektur basiert auf Mistral-v0.3; das Felsfenster (Schiebefenster) entspricht LLaMA-3, da die Struktur geschlossen ist.
Wie Denersin Kumru?
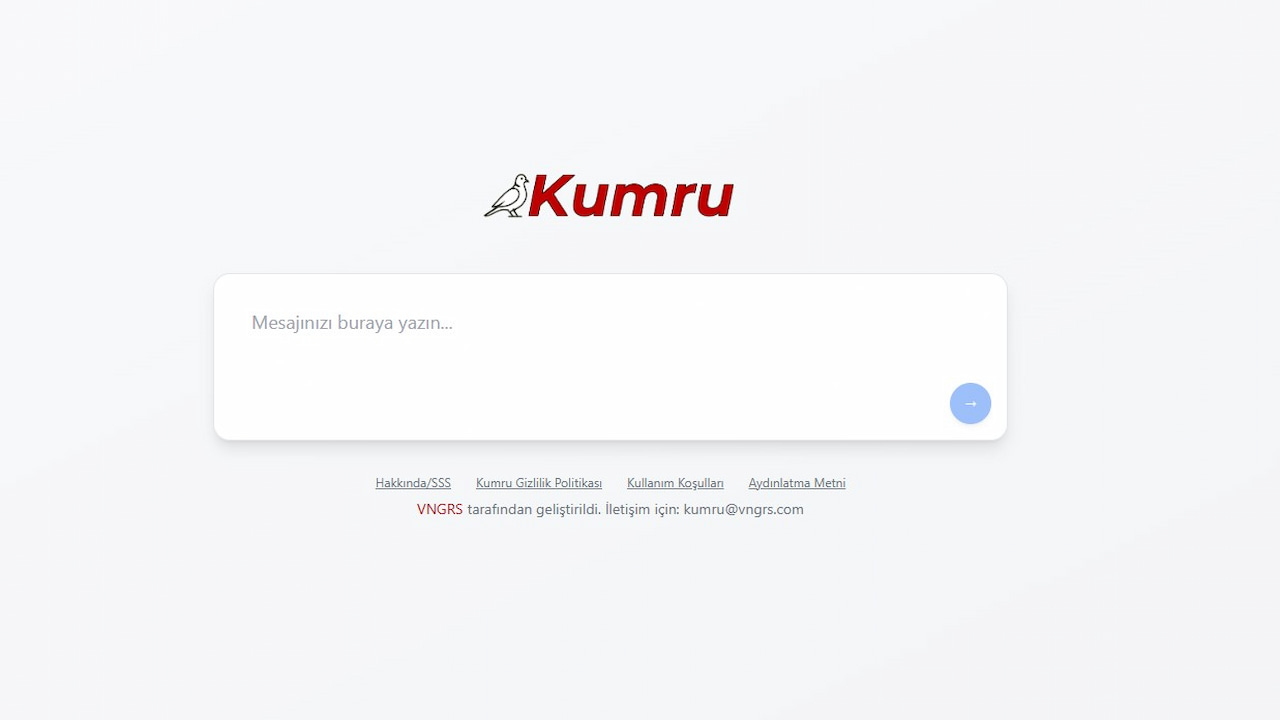
Vom Browser Zuhause Gehen sie zur adresse; der demo-chat-bildschirm des modells mit 7,4 milliarden parametern öffnet sich.
Schreiben sie den text, den sie zusammenfassen möchten, oder text in die chat-box.
2 Milliarden Parameter, wenn Sie ihren Computer oder Server ausprobieren möchten Kumru-2BSie können ' von Hugging Face herunterladen; offen mit Apache 2.0 Lizenz.
Passen Sie die Erwartungen entsprechend an: Kumru ist ein kleines Modell, das für die Ausführung in der Institution entwickelt wurde, kein allgemeiner Chat-Assistent. Die demo-version kann falsche informationen geben und in mathematik gezwungen werden; wir sagen die gründe unten.
Die von VNGRS entwickelte Kumru AI wurde speziell für Unternehmensanforderungen entwickelt, die Datenschutz und hohe Leistung erfordern. Obwohl diese Entwicklung die Diskussionen bringt, die der ChatGPT-Rivale nicht sein würde, ist die Hauptaufgabe von Kumru vom letzten Benutzer, Lösungen für die Regulierungssektoren in der Türkei (vor Ort) bereitzustellen.
Was ist Kumru AI und warum von Null entwickelt?
Kumru AI ist eine Lösemittel-Architektur (nur Decoder) basierend auf 7,4 Milliarden Parametern Big Language Model (LLM)Die Hauptmotivation bei der Entwicklung des Modells ist die große Notwendigkeit eines grundlegenden LLM-Modells, das in der Organisation unter Berücksichtigung der Datensicherheitsvorschriften der Türkei und der Exzellenz in der türkischen Sprache verwendet werden kann.
Null Bildungsvorteil: Anstatt bei mehrsprachigen Modellen wie LLaMA oder Gemma eine Feinanpassung vorzunehmen, war Kumru eine strategische Entscheidung, von Grund auf für Englisch zu trainieren. Fertige Modelle werden bei der Verarbeitung von Token (Text-Encodern) viel mehr Token ausgegeben, was die Kosten für Training und Nutzung erhöht. Kumru verwendet einen modernen Tokenizer, der speziell für Türkisch entwickelt wurde. Laut dem Vergleich von VNGRS geben andere mehrsprachige Modelle mehr als 38% mehr Token aus als Kumru für denselben türkischen Text. Diese Effizienz macht Kumru ideal für die Verteilung in Bezug auf Geschwindigkeit und Kosten.
Leichtgewicht und Zugänglichkeit: Kumru kann auf mittleren GPUs wie RTX A4000 oder RTX 3090 mit 16 GB VRAM arbeiten und kann in Unternehmenssysteme integriert werden, ohne dass große Hardwareinvestitionen erforderlich sind. Diese Funktion unterliegt den Bereichen der Datensicherheitsverordnung (Finanzen, Gesundheit usw.) von entscheidender Bedeutung.
Kumru Wie wurde künstliche Intelligenz ausgebildet und was sind technische Spezifikationen?
Entwicklungsprozess von KumruVon einem kleinen Team, bestehend aus türkischen Ingenieuren, wurde es mit einer sorgfältigen Ingenieurarbeit durchgeführt:
Vorschulungsphase: Das Modell wurde in der Vortrainingsphase von 45 Tagen mit NVIDIA H100 und H200 GPUs in einer Größe von 500 GB gereinigt. Kumru war in diesem Prozess 300 Milliarden Token ausgesetzt.
Architektur und Support: Die Architektur von Kumru basiert auf Mistral-v0.3; entspricht LLaMA-3 als Struktur, da das Felsfenster geschlossen ist. In der Ausbildung Entscheidungen wie Bulk Business Größe, optimiert und Lerngeschwindigkeit Technischer Bericht von LLaMA-3 u Base genommen wurde.
Kontextlänge: Kumru 8.192 hat die Kontextlänge des türkischen Tokens. Dies bedeutet, dass Sie bis zu etwa 20 A4-Seiten in einer Transaktion dokumentieren können.
Dünne Einstellung (Fine-Tuning): Nach der Vorschulung wurde eine Mischung aus etwa 1 Million Beispielen fein angepasst, um verschiedene Nutzungsszenarien zu unterstützen.
Antworten auf Fragen von VNGRS: Wie positioniert man Native Artificial Intelligence Kumru?
Nach dem intensiven Interesse an Kumru klärt VNGRS die Positionierung des Modells, indem es die kritischsten Fragen aus Social Media beantwortet (X):
Kumru Konkurrenz zu ChatGPT?
Antwort: Kumru ist eine kleine, schnelle und kostengünstige Lösung, die für In-House-Lösungen (B2B) entwickelt wurde, kein Produkt für den Endverbraucher (B2C). ChatGPT ist eine riesige Modellfamilie, die sowohl für B2C als auch für B2B positioniert ist.
Warum mache ich Fehler (Relation)?
Antwort: Das Problem falscher Informationen in künstlichen Intelligenzmodellen (Halfination) wird in der Phase des konsolidierten Lernens (RLHF) minimiert. Kumru kann wie die ersten Davinci-Modelle von OpenAI falsche Informationen liefern, da es die RLHF-Stufe noch nicht durchläuft. Dieser Mangel wird mit zukünftigen Verbesserungen behoben werden.
Warum ist Kumru Mathe?
Antwort: Sprachmodelle bestehen aus Wörtern und sie lernen statistisch aus dem Text, den sie Informationen trainieren; sie haben keinen eigenen Rechnermechanismus. Kumru wurde für türkische Kompetenzen entwickelt und ist jetzt in Mathematik falsch, weil es nicht durch die RLHF-Stufe geht.
Warum wählen Sie Zero Education?
Antwort: Vorbereitete (vortrainierte) Modelle (wie LLaMA) und erfordern eine Feinanpassung, verwenden Sie das Token des Originalmodells (Text-Encoder). Dies erhöht die Kosten bei der Verarbeitung türkischer Texte bis zu verdoppeln. VNGRS hat sich entschieden, Kumru mit einem modernen Token zu trainieren, das in Bezug auf Spezialisierung, Kosten und Geschwindigkeit auf die Bedürfnisse des Türkischen von Grund auf optimiert wurde. Dies bietet langfristig Effizienz und Kostenvorteil.
7 Milliarden Modell wird Open Source veröffentlicht?
Antwort: Da größere und multimodale Modelle produziert werden, ist geplant, dass sie von alten Modellen ab 7 Milliarden Version veröffentlicht werden. 2 Milliarden Parameter allein auf der Hugging Face-Seite von VNGRS zum 14.10.2026 Kumru-2B und die Basisversion von Kumru-2B-Base ist mit Apache 2.0-Lizenz geöffnet. 7,4 Milliarden Parametermodell wurde noch nicht als Open Source veröffentlicht.
Die Buchstaben im Wort, das ich erwähnte, sind falsch antwortend, warum?
Antwort: Die kleinste Einheit für populäre Sprachmodelle ist Wort oder Wort (Token). Das Modell sieht Token, nicht die Buchstaben, die es bei der Verarbeitung von Texten schaffen. Daher machen sie oft Fehler in Fragen zu Briefen.
Mistral Was kommt Modellarchitektur?
Antwort: Die Modellarchitektur Mistral bedeutet nicht, dass ein führendes trainiertes Mistral-Modell übernommen und trainiert wurde. Kumru wurde von Ende zu Ende mit Tokenizer und Modellgewichten erstellt und trainiert. Die Architektur definiert die Gesamtstruktur des Modells, z. B. die grobe Architektur des Gebäudes.
Kumru Wie bietet man KI-Nutzung an und was sind die Zukunftspläne?
Kumru AI, sandru.ai Adresse über eine Demo Version mit Zugang.
Aktueller Stand (14.10.2026): Seit der ersten Veröffentlichung im September 2025 wurde auf der Hugging Face-Seite von VNGRS kein neues Kumru-Modell veröffentlicht. Die folgenden Pläne zielen darauf ab, dass VNGRS mit der ersten Version geteilt wird.
Zukunftspläne:
Fröhliches Lernen (RLHF): Es ist geplant, diese Phase schnell zu durchlaufen, um die Fehler des Modells zu minimieren und die mathematischen Fähigkeiten zu verbessern.
Multimodalität: Es zielt darauf ab, ein multimodales Modell von Kumru zu erstellen, indem Visuals und gescannte Dokumente verarbeitet werden können (Bild-Encoder-Integration).
Größere Modelle: Die größeren und ruinierten Kumru-Versionen sollen mit größeren und aktuellen Datensätzen trainiert und dann als Open Source alter Modelle ausgestrahlt werden.
Diese Entwicklungen, VNGRSEs zeigt auch die Mission, langfristige Investitionen in das türkische private KI-Ökosystem zu tätigen.
Weitere in der Türkei entwickelte Sprachmodelle (BİLGE, T3 AI, Trendyol LLM, TURNA und MAIN) Türkeis native AI-Modelle Home Wir vergleichen im Artikel. VNGRS Türkische KI-Unternehmen, die sich im Jahr 2026 abheben Home Sie können auch die Liste durchsuchen. Wenn Sie über türkische Sprachmodelle sprechen möchten Masqot Gemeinschaften Sie können finden, was zu Ihnen passt.
AdminHumain Horizon Pro Yapay Zeka Merkezli Yeni Nesil Laptop
OpenAI’da Yeni Dönem: Yönetim Kadrosunda Büyük Değişim


